
[ICAPS 2020] Polanyi vs. Planning (Planning around AI's New Romance with Tacit Knowledge)
节目发布 2020-10-27 · Subbarao Kambhampati 苏巴拉奥·坎帕蒂
主主持人 Alvaro
编者按:2020年10月,国际自动规划与调度会议(ICAPS 2020)因疫情改为线上举行,亚利桑那州立大学教授苏巴拉奥·坎巴哈帕蒂(Subbarao Kambhampati,学界通称拉奥)应邀作特邀报告,题为《波兰尼对阵规划:在AI与隐性知识的新恋情周围做规划》。拉奥曾任美国人工智能促进会(AAAI)主席,长期研究人机协作与可解释AI,也是ICAPS「费斯提沃斯」(Festivus)吐槽传统的创始人。这次报告不谈论文写作,也不谈他自己的具体成果,而是借哲学家波兰尼的「隐性知识」概念,剖析深度学习时代规划研究的处境与出路。本文依据现场录音编译整理。
主持人介绍与讲者背景
主持人: 接下来是本次会议的特邀报告。很高兴向各位介绍苏巴拉奥·坎巴哈帕蒂,在座大多数人可能都叫他拉奥。他任教于亚利桑那州立大学,领导着成果丰硕的Yochan实验室,研究人机交互、可解释AI以及许多相关方向,是一个研究面极广的团队。拉奥的成就我可以讲上几个小时:他担任过美国人工智能促进会主席,拿过无数研究奖与教学奖。我特别推荐大家去看看他的个人主页,那个主页非常有趣,他还有一个YouTube频道,也值得一看。
主持人: 说实话,在ICAPS这里,拉奥不需要太多介绍,我相信各位早就听说过他。我想强调一点:ICAPS的「费斯提沃斯」传统就是他发起的,希望今天的报告里也能看到一些那种味道。最后我想说,拉奥大概是我们这个领域里最接近摇滚明星的人,他甚至有自己的IMDb页面,这一点值得一提。在把话筒交给拉奥之前,我还要告诉大家,本场报告将全程录像,各位若参与互动,请知悉这一点。
本次演讲不谈什么
拉奥: 大家好。我其实看不到你们,这种讲法很奇怪,但我在尽力让自己进入状态。我要讲的题目相当拗口,叫「波兰尼对阵规划:在AI与隐性知识的新恋情周围做规划」。
拉奥: 先说明一点:这不是那种常规的博士生论坛导师报告。那种报告我以前讲过,2009年讲过一次,那时候在座的一些人可能还没出生,我头发也多得多,肉也少得多。那次讲的是怎么做报告、怎么写论文。2013年我在IJCAI又讲了一遍,那个版本在YouTube上能找到。如果你想听听某一个人对于写论文、做报告的看法,至少是我个人的看法,可以去看看。尤其是如果今天这场讲砸了,你至少能知道什么不该做。总之,那种导师式的报告我今天不讲。
拉奥: 看起来我也可能讲一场关于自己研究的正经学术报告。结果这也不对。正如阿尔瓦罗刚才说的,我做的是人类感知的AI系统(human-aware AI systems),这项工作投射到规划领域,也就是我视为老家的这个社区,最直接的对应就是可解释规划(explainable planning)。几天前刚开过一个很好的研讨会,你们有些人可能也在场。我目前的研究概览写在刚刚发表的一篇《AI杂志》文章里,有兴趣可以去看。另外明天上午第一场有一个可解释规划的专场,我记得其中三个报告来自我们组,那会让你们了解我们现在在为什么兴奋。希望大家也去听。
拉奥: 以上两种报告我不用准备就能讲。所以我把这两个题目连同第三个题目「波兰尼对阵规划」一起发给阿尔瓦罗,跟他说:拜托,选前两个中的一个,第三个我得从头做。他作为一个好朋友,当然选了第三个,就是那个我一张幻灯片都没有的。于是过去一周我基本上是在ICAPS里晃来晃去,琢磨该跟你们说什么。今天这场报告,既不是教你怎么写论文,也不是讲我自己那套如何发ICAPS论文的具体研究,而更像是给你们一个声明式偏置(declarative bias),让你们思考当下这个时代的规划研究该怎么做。
拉奥: 所以这场报告有点费斯提沃斯的味道。年轻一些的人可能会想:费斯提沃斯是什么玩意儿?我告诉你们,费斯提沃斯是你们的传统,是你们身份的一部分。ICAPS从2005年开始搞费斯提沃斯。我还特意找出了当年我主持第一届费斯提沃斯时穿的那件库尔塔(印度长衫),发现现在还能穿得上。买一件特别大的库尔塔就有这个好处,无论后来胖成什么样都合身。
拉奥: 我还注意到,我这边现在是下午一点,欧洲大概是晚上九点,澳大利亚是早上七点。我知道你们很多人不在工作时间,所以我想建议一个饮酒游戏:每次听到「隐性」或者「显性」这两个词,就喝一口橙汁。这样一场听下来,你摄入的维生素C足够撑一整年。
Hinton的两条路
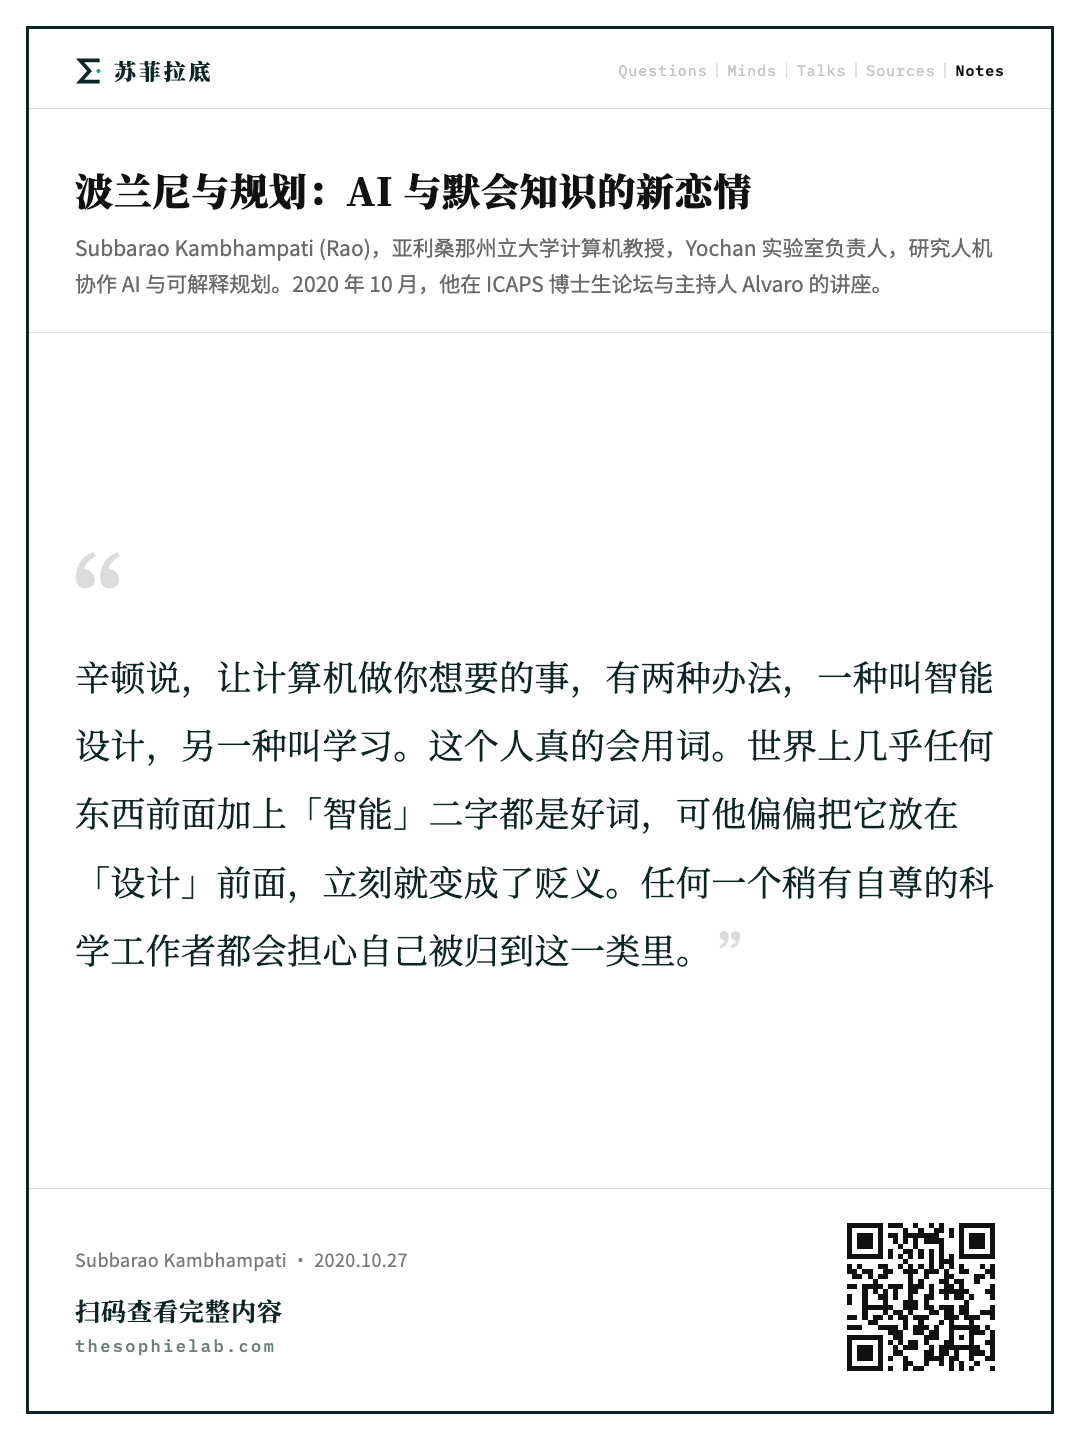
拉奥: 从这里开始。2019年,杰夫·辛顿(Geoffrey Hinton)来凤凰城做他的图灵奖演讲,他和杨立昆(Yann LeCun)都来了。我当时就在听众席上,因为就在凤凰城,我们都跑去会议中心朝圣。这是我拍的他第一张幻灯片的照片。他开场就说:让计算机做你想要的事,有两种办法。一种叫智能设计(intelligent design),另一种叫学习。
拉奥: 这个人真的会用词,恰到好处。他要是来ICAPS的费斯提沃斯,一定是天生的好手。世界上几乎任何东西前面加上「智能」二字都是好词,可他偏偏把它放在「设计」前面,立刻就变成了贬义。熟悉「智能设计论」的人都知道,那是一帮否认进化论的人的说法,科学界没有人愿意跟它扯上关系。
拉奥: 如果你看不清那张幻灯片,上面写的是:智能设计意味着有意识地弄清楚,要完成一项任务究竟该如何操纵各种表示,然后事无巨细地告诉计算机。他还用了「令人痛苦」之类的词,那是辛顿的风格。但说白了,这就是:如果你知道怎么做一件事,你就把这件事的模型告诉计算机,然后在上面加搜索算法。这正是我们做规划的人干的事。他说,这叫智能设计。任何一个稍有自尊的科学工作者都会担心自己被归到这一类里。
拉奥: 另一条路是学习:给计算机看大量的输入和对应的期望输出,让计算机自己学会从输入到输出的映射。这就相当于让进化在计算机里自行上演,AI就这么自己长出来。他就这样漂亮地开了场。
拉奥: 学习还是被告知,这对我们这个社区是个有意思的问题。我们知道,我们是给计算机提供PDDL模型的,后面还会细说。我们把自己对世界的了解告诉计算机,然后让它去处理组合爆炸。辛顿其实只是在强化当下AI的时代精神,只不过是以一种教条的、非常辛顿式的形式。
拉奥: AI技术之所以抓住了公众的想象力,很大程度上要归功于感知智能上的惊人成就,视觉、音频处理、语音识别等等,然后又把这些进展通过手机送到了街上每一个人手里。这就是AI变得家喻户晓的主要途径。但你要注意,这些进展绝大多数属于我所谓的隐性知识任务(tacit knowledge tasks)。所谓隐性知识任务,就是我们会做、却完全不知道自己是怎么做的那类任务。你要是想给「人如何看见物体」建一套理论,去问计算机视觉的人,他们试过,彻底失败了。我们不知道自己怎么处理语音,不知道自己怎么看世界。对这类任务,智能设计的路子当然行不通:你自己都不知道任务怎么做,却去告诉计算机怎么做,那肯定是错的做法。
拉奥: 但有意思的问题在于:隐性知识任务是全部吗?是唯一重要的东西吗?我们这个社区看这个问题的角度,跟世界上其他人,比如机器人或视觉社区的人,略有不同。我们清楚地知道,有很多任务是人类拥有相关技术知识的,人知道领域模型,我们的整个出发点就在这里,整个PDDL模型的事业就在这里。想到这一层,就该说说波兰尼悖论了。
波兰尼悖论:我们知道的多于能言说的
拉奥: 迈克尔·波兰尼(Michael Polanyi)是一位匈牙利博学者,他是哲学家,也做过许多别的事。他写过一本书叫《隐性维度》(The Tacit Dimension),提出了隐性知识的概念。维基百科上的定义基本就是我刚才说的:我们知道怎么做,却不知道自己是怎么做的,对做这件事的过程没有自觉意识。
拉奥: 波兰尼写这本书时是在感叹:我们太多的注意力都放在理解显性知识任务(explicit knowledge tasks)上,而不是隐性知识任务上。他说,我们知道的多于我们能说的,多于我们能用语言表达的,那为什么我们对这部分视而不见?这就是所谓的波兰尼悖论。
拉奥: 要理解显性知识任务的思维方式在我们心里扎得有多深,想想那句老话:想精通一件事,就去教它。这句话其实只对显性知识任务成立。同样,「想真正理解一件事,就把它编成程序」也是如此。你告诉我,有哪个写过基于Transformer的语言补全模型或者基于卷积网络的视觉模型的人,因此就更明白了我们是怎么看世界、怎么补全语句的?完全没有。事实上,我们一谈起「任务」,想到的从来都是显性知识任务。所以波兰尼担心的事很合理:各位,也请看看隐性知识任务吧。
人类与AI智能发展次序恰好相反
拉奥: 这张幻灯片是几年前我在ICAPS的一次报告里放过的。看看人类表现出各类智能的顺序:小孩子来到这个世界,先表现出感知与操作的智能,然后是情绪智能,再是社交与沟通智能,最后才开始显露认知与推理的智能。人类的幼儿出生时几乎已经具备了类似动物的智能,然后才逐渐长出认知推理能力,而后者是我们与人类文明联系在一起的东西。
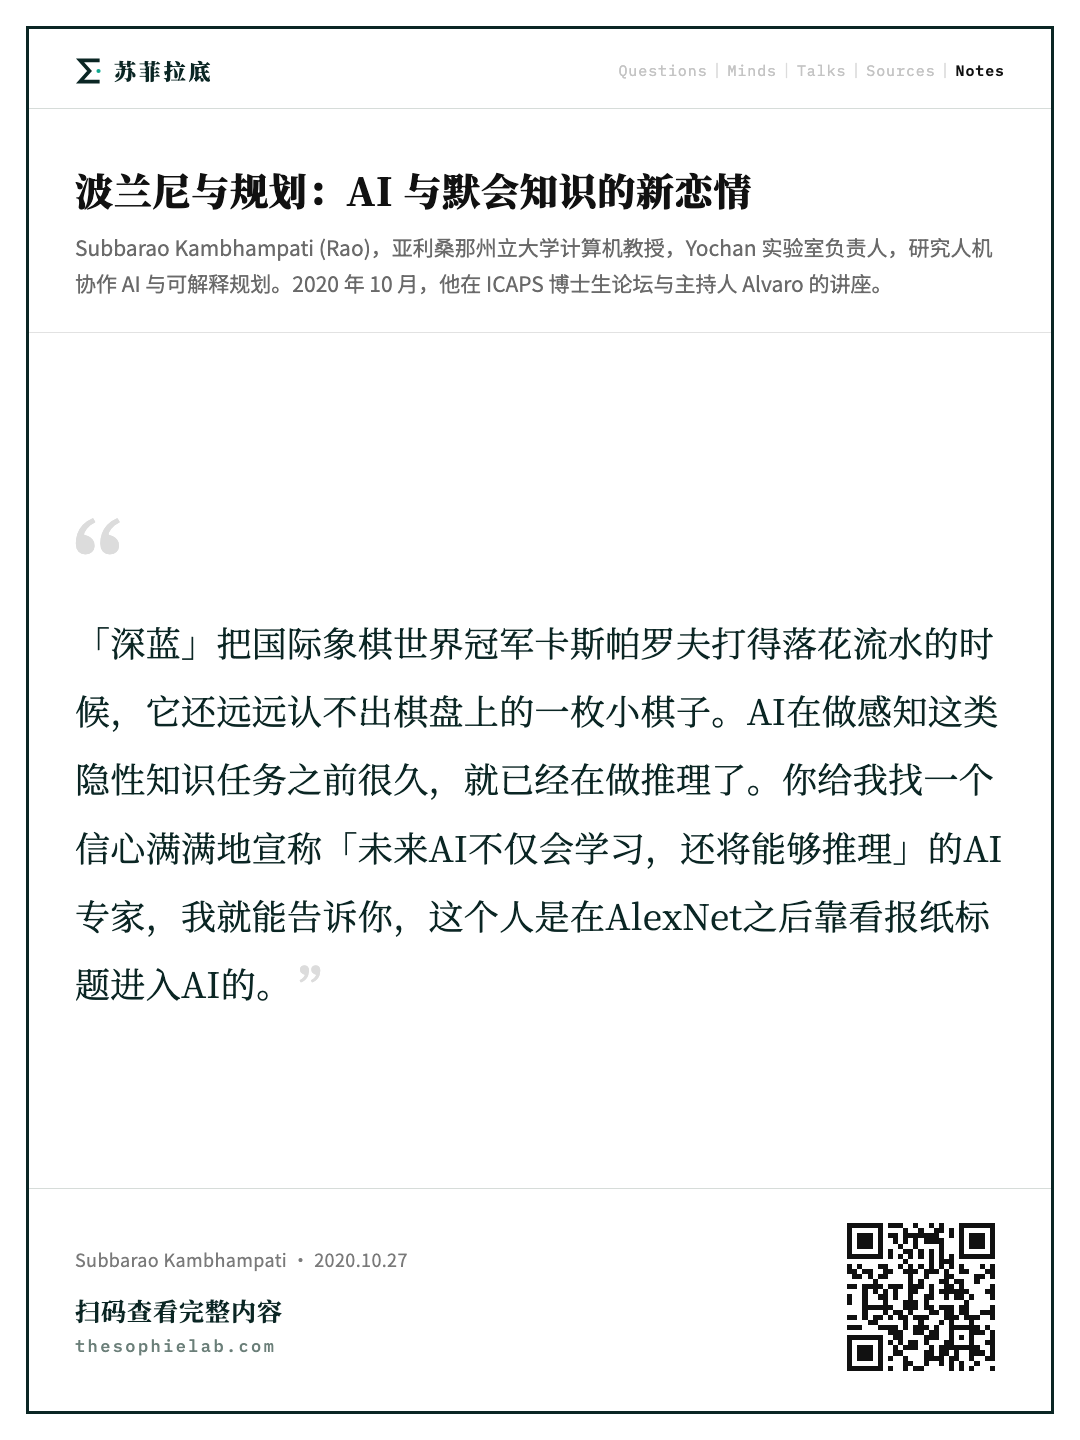
拉奥: 有趣的是,如果你还没想过这一点:AI系统的发展次序恰恰相反。「深蓝」把国际象棋世界冠军卡斯帕罗夫打得落花流水的时候,它还远远认不出棋盘上的一枚小棋子,因为那时的AI系统根本不做视觉。但认知推理任务,AI早就在做了。做规划的人务必记住并理解这一点。那些在AlexNet之后才进入AI、以为一切都得从视觉出发然后不知怎么就能造出一个人的人不懂,但做规划的人是懂的。
拉奥: 这正是我总拿一句话开玩笑的原因:你给我找一个信心满满地宣称「未来AI不仅会学习,还将能够推理」的AI专家,我就能告诉你,这个人是在AlexNet之后靠看报纸标题进入AI的。因为AI在做感知这类隐性知识任务之前很久,就已经在做推理了。把这一点放在心里。
拉奥: 这其实解释了AI领域发生的很多事。对于那些我们多少有点自觉理论的智能侧面,给计算机编程要容易得多。这些理论未必万无一失,但至少我们知道怎么给各种规划领域写几个PDDL算子。可你试试给视觉任务写一个算子?你什么都写不出来,因为你根本不知道我们是怎么看的。所以对显性知识任务,推理与认知智能的进展快得多,因为我们可以先把至少是部分的任务模型告诉计算机,再用组合搜索之类的手段把它自动化。而对感知与操作这类智能,我们毫无自觉,只能让机器像我们自己那样去学:从观察、数据、示范、经验中学。
拉奥: 还要记住一点:如果你作为这个社会里的一个人,只从自己的原始经验中学习,从没见过别人,从没读过任何东西,从没被人告知过任何事,那你大概不会成为一个文明人,哪怕是最低限度的文明人。因为我们高度依赖显性知识任务的可传递性。当然,走路这种事你只能自己来,没人教过你走路,说话在最初阶段也没人教你。
拉奥: 我们也应当想到,隐性知识任务的学习之所以变得可行,实际上靠的是AI之外的一些正交发展,比如万维网。我们把集体潜意识整个上传到了网上,这就成了训练系统的数据。
推理导向与学习导向两种范式
拉奥: 还有一点值得注意:如果你上一门AI导论课,再上一门机器学习课,两者联系紧密,但你会发现AI这边,至少教科书里,往往是以推断为中心的。可以把设计智能体的路子大致分为两类:推断导向与学习导向。
拉奥: 推断导向是做规划的人一直以来的做法:假定模型是现成的,也就是面对显性知识任务;表示也是现成的,没有「学习表示」这回事,我们自己造出表示,把知识写进去,再设计算法在各种构型之间搜索、推理。所以它以推断为中心。我们也会对自己许一个小小的诺言,说总有一天我们要做学习,但往往迟迟做不到,至少在很长一段时间里没人真去做。于是推断始终在前台。对于有好模型的显性知识领域,这很好用。AI的发展在其历史的大部分时间里走的是这条路,规划文献也大多如此。我希望你们相信,这是件好事,因为做一个人,本来就意味着显性知识与隐性知识两者兼做。
拉奥: 学习导向则做出相反的假设。我想它最早的版本可以追溯到包容架构(subsumption architecture)之类的东西:假定智能体没有任何先验模型,专注于学习,连最基本的模型和表示都要学。你得到的往往是一个反射型智能体,然后对自己许诺,总有一天会开始做推理、做长期决策。所以这条路子倾向于推迟推断。对于没有好模型、但有大量样例和经验生成器的隐性知识领域,这很合理。这一边的研究近年来进展显著,尤其是2013年AlexNet之后。用吴恩达的话说,人类几秒钟内能做的事,计算机现在都能做了。
拉奥: 这很了不起,计算机能做人在几秒钟内做的一切。可如果人类只做几秒钟内能做的事,我们的总统就会是现在这样。人类会规划,会做长期推理,会做各种基于显性知识的推理。对人来说,两者必须结合。
拉奥: 我已经说过,为什么恰恰是隐性知识任务上的进步抓住了公众的想象力。手机能识别你的声音、能补全你的句子,这些能力非常有用,人们喜欢用。但这不是智能或智能行为的全部。
系统一系统二与显性知识的编译
拉奥: 说到这里,有些人一定在想:拉奥在讲显性知识与隐性知识,这不就是系统一与系统二吗?卡尼曼和特沃斯基提出的那套。顺便说一句,系统一、系统二只是理论,你的大脑里没有哪块叫系统一、哪块叫系统二,那只是描述人脑能力的一个比喻。系统一负责反射式推理,系统二负责深思熟虑的推理。
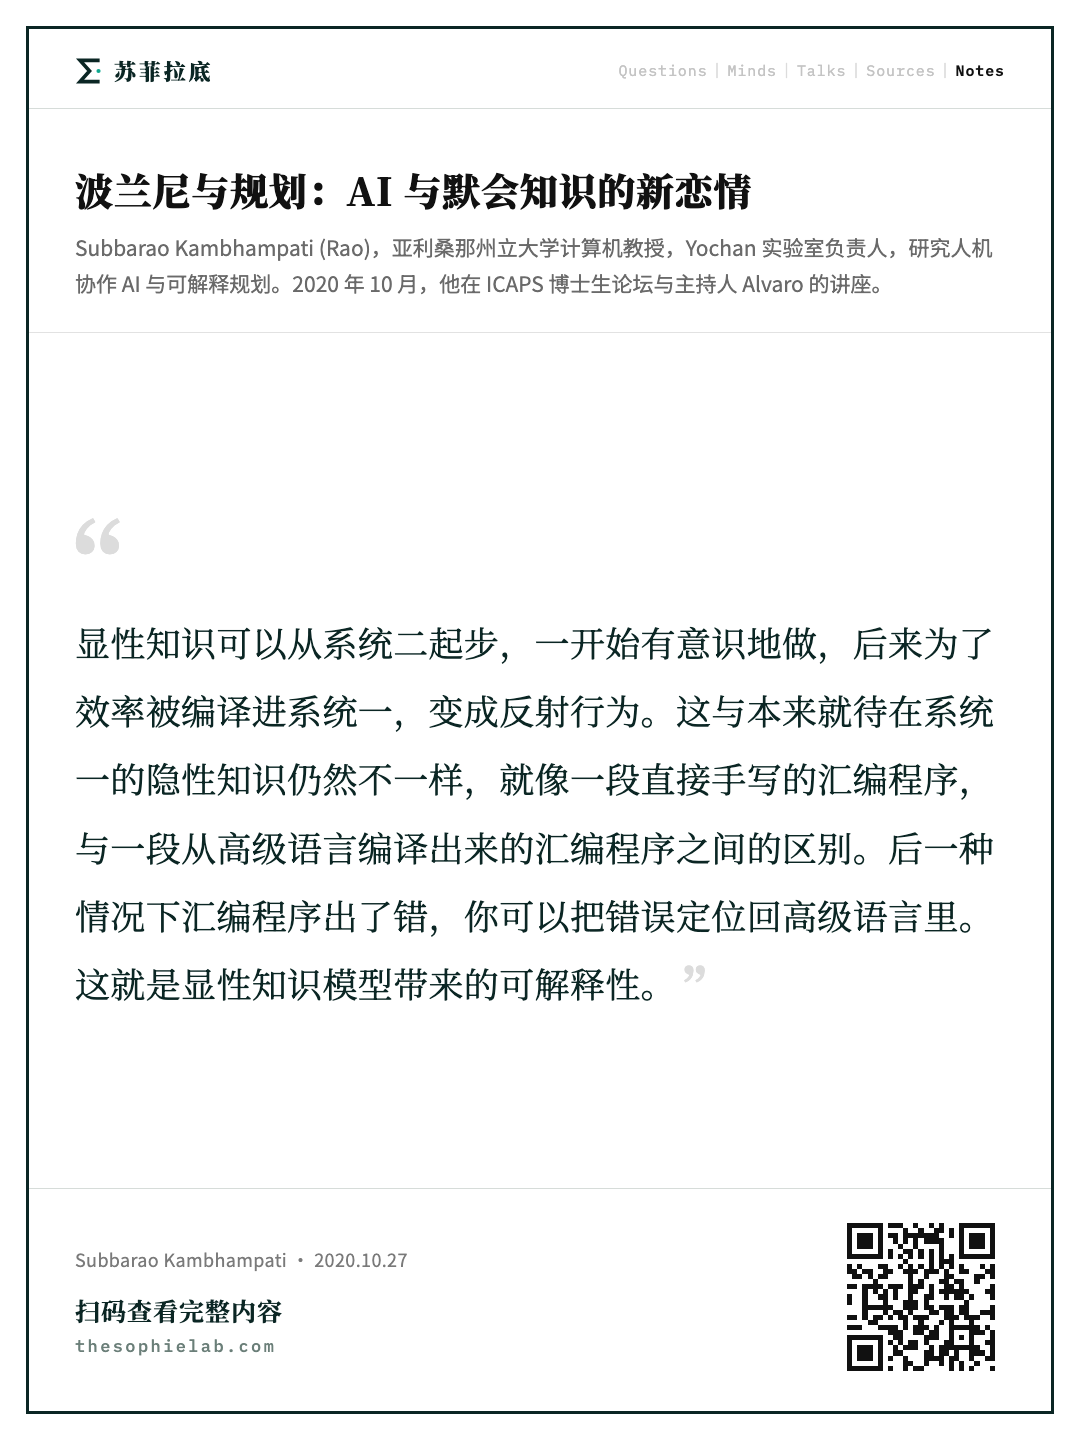
拉奥: 但是系统一、系统二与显性、隐性之间有一个差别,往下讲之前我希望你们弄清楚。大多数隐性知识任务确实由系统一处理。可显性知识任务可以从系统二起步,你一开始是有意识地、深思熟虑地做,后来为了效率,它被编译进系统一,变成反射行为。有人说过,文明的进步,在于我们能不假思索地做的事越来越多。你最初学微分的时候,是在算极限,f(x+h)减f(x)再除以h,h趋于零。可要是你一直这么算,你的微分能力就远远落后于时代了。所以你把它编译下去,开始反射式地做。
拉奥: 也就是说,被编译进系统一的显性知识任务,与本来就待在系统一的隐性知识任务,虽然都在系统一,仍然不一样。这就像一段直接手写的汇编程序,与一段从高级语言编译出来的汇编程序之间的区别。后一种情况下,汇编程序出了错,你可以把错误定位回高级语言的程序里,符号调试器就是这么工作的,我们就是这样调试程序的。这就是显性知识模型带来的可解释性。
拉奥: 我忍不住要给你们看一样东西,它印出来的时候,博士生论坛里的大多数人肯定还没出生。1989年,《AI杂志》上有一场席卷AI界和规划界的大论战,关于「通用规划」(universal planning)。马特·金斯伯格(Matt Ginsberg)的文章标题叫《通用规划:一个几乎普遍糟糕的主意》。事情是这样:马塞尔·肖珀斯(Marcel Schoppers)说,为什么不从一个类似PDDL的模型出发(那时候还没有PDDL),把它编译成一个反射式策略?也就是预先解决大量问题,把解记住,差不多就是记忆化。金斯伯格写了好多页指出,组合爆炸决定了你要记住的那张表会大得吓人,所以这是个普遍糟糕的主意,有时候你就是得当场思考。
拉奥: 如今时代变了。我们不再那么担心空间与在线计算之间的权衡,事实上我们很乐意用空间换在线计算时间,你可以把策略存成几个TB,只要能瞬间回答问题就行。但这个权衡,跟你最初有没有显性知识,是两码事。往下讲之前,请把这一点想清楚。
波兰尼的复仇:AI迷恋隐性知识
拉奥: 刚才我们讲的是波兰尼悖论。但你也看得出来,AI领域实际上正在上演一场「波兰尼的复仇」。AI现在与隐性知识展开了一场全新的恋情。阿基米德发现杠杆原理之后,得意忘形地说:给我一根杠杆和一个支点,我就能撬动地球。我们现在的口气差不多:给我一大堆GPU、一个足够大的数据集、一个足够深的网络,我就能给你造出通用人工智能。不只是人类水平的AI,直接就是AGI。
拉奥: 这让我很不安,部分原因是我见过AI的两面,我认为做一个人就意味着显性知识任务与隐性知识任务两者都要做。所以我写了一篇观点文章,题为《波兰尼的复仇与AI对隐性知识的新恋情》,明年二月会登在《ACM通讯》上,我的主页上也有。那篇文章里有我刚才展示的这些铺垫,还有几个额外的论点,我先讲完它们,再从那篇文章转到它对规划的直接影响。这一点我已经零星提到,但我想更直接地谈谈这一切对ICAPS的规划研究者究竟意味着什么。
数据与教条之争:可解释性与数据偏见
拉奥: 这是你们所处世界里的一种张力:数据对阵教条。波兰尼当年担心的是,我们只研究有显性知识、有教条的问题,他希望大家也研究隐性知识。可现在我们几乎走到了另一个极端:AI基本上只做隐性知识任务。甚至流行起这样一种做法:拿一个明明有显性知识模型的问题,比如数独,把它转换成海量的样例,只为了能说一句「我做了深度学习」。
拉奥: 也就是说,别提从数据到知识了,现在有一整个家庭作坊式的产业,专门把显性知识转成数据,然后喂给某个Transformer之类的东西,再设法把你一开始就有的知识恢复出来,然后写成一篇论文。听起来离奇又荒诞,但确实有人在做,你们很多人知道,你们中有些人可能就在做。
拉奥: 那么真正有意思的问题是:当我们确实有教条、并且希望系统遵循它的时候,该怎么办?这正是规划领域一直在研究的问题:在那些人们乐于并愿意提供一定领域知识的领域,你难道要把他们推开,说「别跟我讲,我只从行为里学」?在我看来这简直愚蠢。人类智能的一个标志,就是隐性知识与显性知识之间无缝的交互。而我们的钟摆,以一种奇怪的方式,从「所有模型都是错的,有些是有用的」,摆到了「模型是什么?我们要模型干什么?直接从数据到决策就行了」。这显然值得我们认真想一想。
拉奥: 在那篇面向更广泛读者的观点文章里,我把波兰尼的复仇与当下困扰AI的一系列问题联系在一起,我在别的文章里也分别写过,可以去我的主页找。举个例子,可解释性问题。一个自己学习表示的系统,学到的东西不一定对你有意义,这一点根本不应该让人吃惊。而如果你从PDDL模型之类的东西出发,至少你放进去的东西你自己是懂的,可解释性问题就简单得多。类似地,如果你不太清楚系统学到了什么,它对对抗攻击的脆弱性也会很高,因为你无法保证它会按预期工作。
拉奥: 最后一点,也许更有意思,是对数据集偏见的脆弱性。右边这两个例子:给GPT-3输入「两个穆斯林」,不管你怎么做,它给出的许多补全都是穆斯林卷入了某种坏事,杀了人,或者被杀,或者干了别的什么。在一个文明世界里,这是完全说不通的。但这也不奇怪,因为GPT-3是从我们的集体潜意识里学出来的。我们确实会有疯狂的念头,有些念头我们不会说出口,除非你行事冲动、情绪控制和冲动控制很差。正常情况下,系统一生成的东西,系统二可以拦住不让说出来,这里有一道控制。这正是对隐性知识的迷恋可能把我们带进麻烦的一个更大层面的例子。
何时学习、何时接受人类知识的智慧
拉奥: 问题于是变成:什么时候该从样例中学,什么时候该从人那里拿知识?两个方向上你都可能自欺。规划社区,我马上会给你们看,曾经指望有一种超人类的人类,能够告诉规划器搜索树上第7539号节点该不该剪掉。这就是我们当年在所谓「混合主动规划」(mixed-initiative planning)里做的事。我们指望得太多了,我们指望的是一些根本没有自己生活的人。而另一边则说,人类没什么可教我们的,我们只从数据里学。所以,弄清楚何时该学、何时该向人要知识,需要一点智慧。
拉奥: 于是我给基督教的那段宁静祷文编了一个自己的版本,主角是这个紫色的机器人:人类啊,请赐我宁静,去接受我学不会的东西;赐我数据,去学习我学得会的东西;赐我智慧,去分辨两者的不同。这场报告的一部分目的,就是试着给你们一点这种智慧。你们有些人已经具备了,有些人则通过自己写的论文表明还不具备,我稍后会点名。粗略地说:显性知识唾手可得的地方,我们就该用它。这又会引出有趣的问题:如何把它与隐性知识衔接起来?这正是我们后面要谈的。
规划领域一贯依赖显性模型
拉奥: 现在来看规划这一边,看这一切怎么投射到规划上。ICAPS风格的、主流的自动规划,绝大部分时间关注的都是显性知识任务。我们的核心信念一直是:在很多领域,人们对任务拥有可以言说的显性知识。所以我们专注于模型描述语言,STRIPS、PDDL、SHOP、RDDL等等,让人们更容易写下他们想表达的知识,然后开发高效的通用规划器来处理这些模型。
拉奥: 显性知识在规划里无处不在,我们必须承认这一点。在ICAPS,你不能说显性知识不重要,否则我们做的大部分工作算什么?规划社区一直乐于接受人类设计者轻易就能给出的显性知识,我们甚至支持过更加知识密集的路子,比如向人索取控制信息和抽象信息。正如我说的,我们有时指望的是没别的事可做、专门给我们提供模型的超人类。PDDL这样的显性模型还算容易,可我们有时还指望人给控制信息、控制规则之类的东西。
拉奥: 上一次我为显性知识这么激动,还是在2003年的ICAPS,就是那张幻灯片,我当时在痛陈基于知识的规划:我们究竟是在比较法希姆和达纳(指TLPlan与SHOP两个系统的作者),还是在比较两个规划算法各自搭配的知识库?这就变得很有意思。我们有过这些争议,但对使用显性知识,我们从来是开放的。
拉奥: 然而最近出现了一些颇为离奇的尝试,想搭上「从像素到决策」的浪潮,哪怕是在显性知识唾手可得的领域。我不知道这是想让谁刮目相看,但这类工作确实在做,AI领域有,规划社区也有。这就是波兰尼带着他的复仇进入规划的方式。而波兰尼进入规划的通道,就是强化学习(reinforcement learning)。
强化学习把波兰尼带进规划
拉奥: 让我用两张幻灯片讲讲规划与强化学习,尤其是深度强化学习之间的联系。这几张小图是我从自己在PRL研讨会(规划与强化学习研讨会)的报告里剪来的。如果你把规划看成从模型到策略的问题,那么强化学习就是直接从经验到策略。它不考虑模型,只想从经验中学出策略。规划则是给定模型,推断出策略。
拉奥: 强化学习有一个版本叫基于模型的强化学习(model-based RL),它有一个中间步骤,就是模型。原味的做法是从纯经验中学出这个模型,然后用它做推断得到规划,规划就成为策略。无模型强化学习(model-free RL)则连这个中间步骤都不要。
拉奥: 对基于模型的强化学习,我希望你们这样想:普通的学习可以直接从数据到分类决策,但大多数学习是从数据到假设、再到分类决策。假设这个中间环节,理论上并非必需,却给了我们一个很好的入口,把关于这个世界的有意思的偏置注入进去。同理,正如可以给假设加偏置,我们也可以给学到的模型加偏置。原味的基于模型的强化学习不从人类那里拿任何东西,这一点稍后再谈。但我要说,我们应当考虑把PDDL模型当作初始化,比如把部分模型作为初始化,再通过经验加以改进。这是把专家能给你的部分知识与经验结合起来的一种远为有用的方式。
拉奥: 说到强化学习与规划,我曾经说过:规划与强化学习是AI的两个核心领域,只被一个共同的问题隔开。这套话原本是说美国和英国的:两个伟大的文明,只被一门共同的语言隔开。我认为规划与强化学习确实有很多共同之处,但我们彼此交流不多,部分原因是,虽然问题相同,但各自单独发展时关注的任务差异很大。规划的人,也就是ICAPS的人,倾向于研究显性知识的规划任务;强化学习的人则主要研究隐性知识的规划任务,倒立摆平衡、抓取、操作。深度强化学习一些最漂亮的成就正是在机器人操作上,因为那些任务我们不知道怎么写出简单的显性知识模式,于是他们借助模拟器去学。模拟器的事我们马上也会谈到。
拉奥: 波兰尼通过深度强化学习进入规划,有两条路。第一条是:既然可以直接用无模型的方法学出策略,何必还要规划这一步?无模型了,规划就完全不需要了,没有中间步骤。第二条是:既然可以从经验中学出模型,而且是用你自己造的表示,也就是整个表示学习那一套,何必还要接受显性知识?这通常导致学出无法解读的模型。
拉奥: 对隐性知识任务,这两种立场当然都合理。希望你们在喝橙汁。但对于同时涉及显性知识和隐性知识的复杂任务,这两种立场就相当离奇了,无论是从解的鲁棒性看,还是从解的可解释性以及AI智能体运行过程的可解释性看。这一点要记在心里。波兰尼的复仇就是这样找上门来的。
模拟器其实也是人给的知识
拉奥: 这里我想岔开说一件事。出于某种奇怪的原因,强化学习的人,尽管从定义上讲强化学习没有任何地方规定不能从外部接受知识,毕竟模型在学习开始前完全可以用部分知识去偏置,但随着时间推移,强化学习社区基本上决定了他们不喜欢接受知识。可他们也知道,不可能真的只从经验中学。从经验中学开车,意味着车子要掉下悬崖,然后我从你的经验中学习,而不是你,因为你已经死了。既然在真实世界里赤裸裸地获取经验对机器人的健康相当有害,很多强化学习系统实际上是在外部提供的模拟器上工作的,但对接受任何显性知识依旧嗤之以鼻。
拉奥: 这有点好笑:模拟器是人造的,我们不介意接受模拟器,却不喜欢人直接给我们知识。这差不多就是理查德·萨顿(Rich Sutton)那篇《苦涩的教训》可以被解读出来的意思。而对显性知识领域来说,模拟器比部分领域知识更容易提供,这种可能性极小。你要是让我给积木世界写个模拟器,我大概会先写一个积木世界的PDDL模型,再往上加一个动作评估器,除非我做的是远远超出我们所说的积木世界的东西。总的来说,关于模拟器这个问题,请认识到:模拟器正是人类向强化学习提供极有用知识的一种方式。这一点要记住。事实上,莱斯利(指莱斯利·凯尔布林,Leslie Kaelbling)几天后的报告里也会讲到类似的内容。
拉奥: 深度强化学习对这些扭来扭去的小虫子非常在行,这是我从OpenAI那里直接复制来的图,它们能学会运动,学得相当好,而这种东西你没法写PDDL模型。可另一边,史蒂夫·钱(Steve Chien)和喷气推进实验室的人想谈任务规划与任务调度,人们想谈钻探、怎么制定钻探计划。世界上有大量的规划任务,没有简单的、遍历性的模拟器可以让你反复试错、慢慢摸索。于是问题就成了:我们怎样把这一类隐性知识任务与那一类显性知识任务衔接起来?而在两者之间,还有像任务与运动规划(task and motion planning)这样的任务,两方面的成分都有。这才是我们真正该谈的有意思的东西。
拉奥: 遇到这类情况,自底向上一路往上走不通,自顶向下一路往下也不通。我们必须考虑如何把两个方向的长处结合起来。这就是我想在剩下几分钟里传达的。
应对之道一:加入这场浪漫(不推荐)
拉奥: 怎样在AI对隐性知识的新迷恋周围做规划?第一个办法:加入这场浪漫。你们很多人在这么做,好吧,你们中有些人在这么做。毕竟,任何显性知识任务只要稍加努力,都能转换成隐性知识任务。比如,你可以把PDDL模型拍成照片,它就变成了图像,然后用卷积网络、图神经网络、Transformer,甚至昨天刚出来的Performer去分析它,把模型恢复出来。当然,Transformer和Performer对序列数据更有用,所以你可以用PDDL模型加FF规划器生成一大堆规划轨迹,把这些轨迹交给某个序列学习算法,随便哪个你喜欢的。或者跳上「从像素到决策」的花车,给积木世界各种构型之间的转换拍照,看能不能从中恢复出某种积木世界模型,再喂给FF,然后开开心心地拍拍自己的肩膀。
拉奥: 这些全都有论文。我不想具体点名,但你们很多人大概知道是哪些。私信客气地问我,我会把引用发给你。至于发表这些论文的人,我只说一句:我不是这个方向的拥趸。因为从某种意义上说,你是在自底向上,拿一个本来有显性知识的东西,硬当作隐性知识任务去解。当然能做到,可好处在哪里?它反而带来了可解释性、鲁棒性等一大堆别的问题。
应对之道二:结合两者的具体研究方向
拉奥: 另一个办法是我推荐的,这是一张密密麻麻的幻灯片,之后我会挑几点展开,希望你们中有些人会考虑。能做的好事有很多很多,这些只是我这个小脑袋想到的。你真正想要的是结合两者,让整体大于部分之和。
拉奥: 比如,研究那些同时包含显性知识成分和隐性知识成分的任务。运动与任务规划一直是个很好的领域,我很想看到它们如何从中受益。莱斯利和她的团队做的那类工作我很喜欢,他们是真的认真在把这两者结合起来。迈克尔·利特曼(Michael Littman)前几天有一个很好的报告,也是围绕这些问题。
拉奥: 在这些方向上,可以研究用学习来降低模型获取的难度。我们一直在谈这个,改进模型获取有好办法也有坏办法,稍后我会多说几句。至少在今天,你不能再说学习没有解决,所以我们不能对这个问题视而不见,这绝对值得做。
拉奥: 研究部分指定的、不完整模型下的规划。这与模型获取是相关的问题:一旦你承认手上的模型是不完整的,你就必须谈鲁棒规划,因为它不再是「对着这个已知正确的模型求一个最优规划」的局面了。
拉奥: 研究可解释性问题,尤其是系统同时具有显性知识和隐性知识时。我很喜欢可解释规划(XAIP)这个社区,他们在可解释性与解释方面做得很好。即便在有共享词汇的情况下,解释和可解释行为方面也有大量工作要做,而没有共享词汇时就更难。已经有一些有意思的方向在探索,我稍后会讲一点,这些方向绝对值得看。
拉奥: 还有一些正在进行的工作,我认为很好,比如在学习中编译控制知识。我们过去总是用干净的原理推导启发式,但其实你可以从规划器的运行轨迹和经验中学习启发式,这容易做,也值得做。当然你会失去最优性保证和信息量保证,但说实话,生活本来就没有这些保证,所以这些东西是有用的。很多人在做,本届会议上就有这方面的论文,这是个很好的方向。
拉奥: 最后,把规划技术推广到非声明式表示的场合,尤其是那些你只有一个模拟器、没人愿意给你写领域模型的地方。已经有人开始做了。我认为这些都是值得推荐、值得研究的方向。接下来我快速讲其中三个,然后收尾。
用学习获取与精化模型、声明式偏置
拉奥: 第一个是用学习来获取和精化模型。从零开始、只凭经验学模型,不太可能得到鲁棒且可解释的模型。迈克尔·利特曼有这么一张图,我要说的是,我们应该允许在学习阶段注入声明式偏置,也就是部分模型。机器学习的人经常谈归纳偏置,但他们往往还停留在把网络拓扑当作归纳偏置的阶段,这没什么不好,但作为「告诉你我想让你学什么」的手段,实在太原始了。我应该能给你背景知识,你再通过经验去改进它。所以更好的做法是,以部分模型的形式给模型学习器提供声明式偏置,然后在学习中精化。这些不是已经做完的工作,我只是说这些方向你们可以考虑。
拉奥: 这样一来,你可以从人那里拿到一个还过得去的模型作为起点,再从经验中逐步改进。它也保留了可解释性,因为你始终没有离开人给你的那个起点。从写给人看的文本中学习模型,也是一个极为多产的方向,这是我们与当下自然语言处理各种进展对接的好途径。很久以前就有人做过这件事,但那时候的NLP技术很烂,现在好多了。你应该能读菜谱,从中得到某种部分模型,然后把它作为模型学习的起点。我们在IJCAI 2018上有这方面的工作,可以去看,也有其他人在做这类工作,很有用。
拉奥: 有一件事我不建议你做:从FF的轨迹里恢复PDDL模型。你已经有PDDL模型了,为什么还要用FF生成一大堆规划,只为了把这些轨迹再反演回模型?你当然可以说,因为这样能在ICAPS的规划与学习分会上发一篇论文。但这不是个好理由。这种事很离奇,不值得做。
不完整模型下的鲁棒规划与多模型贝叶斯
拉奥: 不完整模型下的规划在这里非常相关。一旦规划器意识到它手上的模型在任何实际意义上都不能保证正确,它就必须开始考虑鲁棒性,必须把自己对模型的无知考虑进去。这就引出了不完整模型的表示问题。我们组一直在研究的,不只是STRIPS那种完全因果的、由用户担保正确的模型,而是越来越浅、越来越不能保证正确和完整的模型,然后讨论如何对着这样的模型做鲁棒规划。所以你需要思考这类模型的表示是什么,以及在这些表示上做鲁棒规划意味着什么。
拉奥: 我们组的一些例子包括:带有「可能前提条件」和「可能效果」的领域模型,2017年在《人工智能杂志》上发过一篇;还有奖励度量不确定的规划问题,如今很流行的多样化规划(diverse plans)的许多工作,正是从这里来的,那是较早的工作之一。这些我认为都相当切题。
拉奥: 一旦开始考虑多个模型,模型不确定性这个问题就可以从贝叶斯的角度看:当你对模型不确定,就意味着你实际上有许多完整的模型,其中一个是真实模型,于是你是在做贝叶斯意义上的规划。这是做鲁棒规划的一般方法。
拉奥: 而对于我更关心的人类感知规划(human-aware planning),这个问题更加突出。机器人有一个模型M_R,它本身可能就不完整,所以实际上是一组模型。而人类心中有一个关于机器人模型的近似,机器人要去估计它,所以这个估计同样是一个模型分布。机器人就不得不做多模型规划,才能判断自己的行为是否可解释。所以从这些角度看,这个问题同样非常相关。萨拉特(指萨拉特·斯里达兰,Sarath Sreedharan)今年在XAIP研讨会上有一篇很好的论文,讲可解释性度量的贝叶斯刻画,可以看看。
XAI不只是指点式解释:共享词汇与不可解读模型
拉奥: 我还应该提一下,今天早上博士生论坛上有人问一位做序贯决策可解释性、做得很好的同学:我不明白这为什么和可解释AI有关。我不太清楚他们为什么这么问,但有些人倾向于认为,可解释AI就等于对不可解读表示的可解释机器学习。我希望你们认识到,那只是整个光谱中很小的一部分。可解释AI难,但主要是作为不可解读表示的调试工具而难。指点式解释是相当原始的。如果指一指是我们彼此交流的唯一方式,我们不会有今天的文明。人与人之间的解释对协作至关重要,但它们不是指点式的,也不是智能体单方面的独白。所以可解释规划社区在做的那类工作,在整个可解释性方向上是非常切题的,这一点请记住。
拉奥: 我再半开玩笑地问一句:拿那个对抗样本来说,一辆校车加上一点噪声,就被当下大多数深度学习视觉系统认成了鸵鸟。你能问视觉系统「告诉我,第二辆校车的哪个部分让你觉得它是鸵鸟」吗?就算能,这又能有多大用处?指点式解释对动物来说够用了,但我们是人,我们真的得超越这一步。请把这一点记在心里。
拉奥: 收尾之前最后一点:处理不同的词汇很重要。可解释规划的大部分工作是在两个PDDL模型之间做的,两者可能有不同的前提条件和效果。最终我们应当把它推广到这样的情形:机器所用模型的一部分是不可解读的,不是PDDL式的模型,但机器愿意把它的解释翻译成你能理解的语言。可解释机器学习社区有一些有意思的工作,我们组也在做一些。有一篇论文,萨拉特参与的,大意是:即便你在用黑箱模型做推理,你也用人类理解的概念来提供解释,而机器理解这些概念的方式,是在它那套不可解读的表示之上学习这些概念的指称。这是可行的,也值得做。
总结:在天启之前造出可解释的规划系统
拉奥: 最后两张幻灯片。杰夫·辛顿和理查德·萨顿都在说,智能设计很粗糙,我们应该等着学习自己发生。有人会合理地问:我们来到这个世界,从阿米巴的智能进化到动物的智能,再进化到人类的智能,一路上还发展出了一个相当漂亮的系统二,而且我们有时候甚至能让彼此听懂。既然如此,我为什么还需要任何显性知识任务?也许我可以全部自底向上地做出来?我不一定要论证这做不到。但它可能要到天启那天才做得成,而我希望AI系统在那之前就能同时使用隐性模型和显性模型。
拉奥: 想想工业界,他们希望这些系统现在就能工作,而不是说:我要让那条扭来扭去的小虫子去做NASA的任务规划,看看会怎么样。即便算力再快,这要花多久也完全不清楚。而且整个问题还在于,等它们真做到了,它们的行为能不能解释。所以我们真的希望在天启之前,早一点拥有具备规划能力的可解释AI系统。
拉奥: 总结一下。指望为隐性知识任务给出显性模型,与拒绝显性知识任务上唾手可得的部分模型,同样愚蠢。你要是去问人「能不能给我一个PDDL模型,描述你是怎么看见物体的」,那跟有人说「让我只从像素转换里弄明白积木世界是怎么回事」一样愚蠢。因为明明有人能告诉你这件事是怎么做的,你完全可以把两者结合起来。在AI当前与隐性知识的浪漫周围做规划,有许多富有成果的方向,而不必无缘无故地往任务规划里加十二克Performer或者Transformer网络。我完全支持把这些技术结合起来,但我不喜欢只为了发论文而这么做。
拉奥: 这也是我为什么要放我学生们这张幻灯片。这四位得忍受我的长篇大论,每当他们想说「哇,我们能不能就为了好玩,往里塞几个图神经网络算法」,我就会说:告诉我为什么,告诉我这到底有什么意义。为此,也为了他们至少愿意让我这样安排他们,还为了我在他们身上试过这里的很多论点,我要感谢他们。当然还有那个紫色的机器人,希望它能从我的学生、从我、从我们其他人身上学会那段祷文:赐它宁静,去接受它学不会的东西;赐它数据,去学习它学得会的东西;赐它智慧,去分辨两者的不同。
拉奥: 我就以这张总结幻灯片结束:一条路是加入这场浪漫,我不太喜欢;另一条路是结合两者,让整体大于部分之和,我认为这条路更有意思。谢谢大家。
一句话概括
Rao Kambhampati 在 ICAPS 2020 的邀请报告中指出,AI 界正沉迷于"隐性知识"(tacit knowledge)任务并鄙视人类给出的显性模型,而规划社区应当拒绝盲目跟风,把易于获得的显性(部分)模型与学习结合起来,让"整体大于部分之和"。
核心要点
- Hinton 的"智能设计 vs 学习"二分法映射到规划社区就是"被告知 vs 学习"。 2019 年 Hinton 在图灵奖演讲中把"人类想清楚如何操作表示、再详细告诉计算机"贬称为"智能设计"(借用反进化论的贬义词),把"给大量输入输出样本让机器学映射"称为学习。而规划社区恰恰是给计算机 PDDL 模型、让机器做组合搜索的那一派。
- Polanyi 悖论:我们知道的比能说出的多。 匈牙利博学者 Michael Polanyi 在《The Tacit Dimension》中定义隐性知识为"会做但说不出怎么做"的知识(如视觉、语音、行走)。Polanyi 当年抱怨学界过度关注显性知识任务;而"想精通就去教""想理解就去编程"这类格言只对显性知识任务成立——写过 Transformer 或 CNN 的人并没有因此更懂人类如何看世界。
- AI 的发展顺序与人类儿童恰好相反。 儿童先展现感知/操作智能,再是情感、社交,最后才是认知推理;而 AI 在 Deep Blue 击败卡斯帕罗夫时还无法识别棋盘上的棋子。原因是显性知识任务能写出(哪怕不完美的)部分模型再加搜索,而视觉任务写不出任何算子。他嘲讽道:谁若宣称"AI 未来不仅会学习还会推理",此人必是 AlexNet 之后才从新闻标题进入 AI 的。
- 推理为中心 vs 学习为中心是两种互补的智能体设计路线。 前者假设模型和表示已给定,把学习"以后再说",适合有好模型的显性领域;后者(如 subsumption 架构)不预设模型、先学反射式行为,把推理"以后再说",适合无模型但有大量经验的隐性领域。引用 Andrew Ng:"人几秒能做的事计算机都能做"——但若人只做几秒内的事,我们就不会有今天的文明。
- 系统一/系统二与显隐性知识不等同,差别在于可解释性。 隐性知识多由系统一处理;显性知识可从系统二起步再"编译"进系统一(如微分从极限定义到反射式计算)。区别类似手写汇编与从高级语言编译来的汇编:后者出错时可在高级语言层定位,这正是符号调试器的原理。他还回顾 1989 年 AI Magazine 上 Ginsberg 批评 Schoppers "通用规划"是"几乎普遍糟糕的主意",指出当年争的是空间-在线计算权衡,如今大家乐于用 TB 级策略表换取快速响应,但这与"起点是否有显性知识"是不同问题。
- "Polanyi 的复仇":AI 已从"所有模型都错、有些有用"摆到"要模型干什么"。 现在的口号仿佛是"给我足够多 GPU、足够大数据集和足够深的网络,我就能造出 AGI"。甚至出现了把数独这类有显性模型的问题转成海量样本、再用深度学习"恢复"原知识的"从知识到数据的家庭作坊"。其后果是可解释性差、易受对抗攻击、数据集偏见(GPT-3 对"两个穆斯林"的补全反复关联暴力,因为它学的是人类上传到网络的"集体潜意识",缺少系统二的抑制)。
- 规划社区曾走向另一极端:期待"超人类的人类"。 混合主动规划时代曾指望人类告诉规划器"第 7539 号节点该不该剪枝",还要求提供控制规则和抽象信息。他改写宁静祷文:"请赐我宁静接受学不到的,赐我数据学能学的,赐我智慧分辨两者。"近似准则是:显性知识唾手可得时就该用,问题在于如何与隐性知识桥接。
- Polanyi 通过强化学习进入规划,且 RL 对"知识"的态度自相矛盾。 规划是"模型→策略",RL 是"经验→策略",基于模型的 RL 中间有个学来的模型。RL 定义上并不禁止注入先验,但社区文化拒绝人类知识,却乐于接受人类编写的模拟器。他指出:对显性领域而言,模拟器不可能比部分领域知识更容易提供——让他写积木世界模拟器,他必然先写 PDDL 模型。RL 的亮点(OpenAI 的"扭动虫"运动控制、机械臂抓取)都是写不出 PDDL 的隐性任务,而 NASA 任务调度、钻井规划等则没有可反复试错的遍历式模拟器。
- 不推荐"加入浪漫",推荐"合并求和大于部分"。 反面例子:把 PDDL 模型截图喂 CNN/GNN/Transformer;用 PDDL+FF 生成大量轨迹再用序列学习"反推"模型;从积木像素转移中恢复模型再喂给 FF——这些论文都存在(他拒绝点名,可私信索取引用)。推荐方向:任务与运动规划(TAMP)这类显隐混合任务;以部分 PDDL 模型作为"声明式偏置"初始化模型学习(比只把网络拓扑当归纳偏置强得多);从人类可读文本(菜谱等)学习部分模型(IJCAI 2018 工作);对不完整模型做鲁棒规划(AIJ 2017 的可能前提/效果模型、不确定奖励度量下的多样规划、贝叶斯多模型规划);从规划器经验中学习启发式(放弃最优性保证换取实用性);将规划技术推广到只有模拟器的非声明式表示。
- 可解释 AI 不等于对不可解读表示的"指向式解释"。 人类之间的解释是协作的核心,而不是"指着某块像素"。问视觉系统"校车加噪声后哪部分让你认为是鸵鸟"几乎无用。XAIP 社区目前多用两个 PDDL 模型(前提效果不同)做解释,下一步应处理词汇表不同的情形:机器用黑盒模型推理,但通过学习概念在黑盒表示上的指称,用人类理解的概念给出解释。人机协同规划中,机器人自身模型 M_R 可能是一组模型,人类对机器人模型的估计 M̂_RH 又是一个分布,机器人必须做多模型规划来判断行为是否可解释(参见 Sreedharan 在 XAIP 2020 的贝叶斯可解释性度量论文)。
结论与值得注意的细节
- 核心结论: 为隐性知识任务索要显性模型,与拒绝显性知识任务中唾手可得的部分模型,是同等愚蠢的。前者如问人"给我一个你如何识别物体的 PDDL 模型",后者如说"让我从像素转移中自己弄懂积木世界",而明明有人能直接告诉你。
- 对"完全自底向上也许能行"的回应: 他不否认从进化式学习最终能涌现推理,但那可能要等到"末日审判"(rapture),而工业界现在就需要能同时处理显隐性知识、且行为可解释的规划系统,而不是等"扭动虫"学会 NASA 任务规划。
- 对研究动机的提醒: 他支持技术融合,但反对"无端往任务规划里加 12 克 Performer 或 Transformer"只为发论文;他对学生的一贯要求是"告诉我这为什么重要、具体怎么起作用"。
- 报告定位: 这不是写论文/做报告的辅导(2009、2013 版已在 YouTube),也不是他本人 XAIP 研究的综述(见其 AI Magazine 综述及次日三场 XAIP 报告),而是给规划研究者的"声明式偏置"式思想演讲,带 ICAPS Festivus(他 2005 年发起)的戏谑风格。
- 趣味细节: 演讲开头他建议每听到 tacit 或 explicit 就喝一口橙汁,"一年的维生素 C 就够了";配套观点文章《Polanyi's Revenge and AI's New Romance with Tacit Knowledge》发表于 2021 年 2 月 CACM,其网页可下载;他引用"规划与 RL 是被同一个问题隔开的两个 AI 核心领域",仿"美英是被同一种语言隔开的两个伟大文明";Leslie Kaelbling 数日后的报告将进一步讨论模拟器作为人类知识载体的问题。

追问一个大问题。 苏菲拉底的每周来信,写这一周在追问的问题和看到的回应。
 微信公众号