
Turing Award Winner: TPU vs GPU vs CPU, Computer Architecture, RISC vs CISC | David Patterson
节目发布 2026-07-13 · Ryan Peterman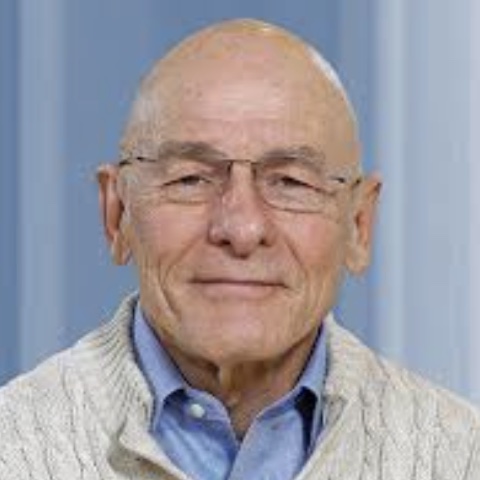 大卫·帕特森
主主持人
本文是图灵奖得主大卫·帕特森(David Patterson)接受一档技术播客访谈的实录。帕特森是加州大学伯克利分校教授,精简指令集计算机(RISC)的开创者之一,近年在谷歌参与张量处理单元(TPU)的研发。谈话从四十年前 RISC 与 CISC 的论战说起,一路谈到 GPU 与 TPU 的设计取舍、摩尔定律的现状,以及他对职业与人生的反思。本文依据现场录音编译整理。
微处理器为何模仿大型机
主持人: 能不能先讲讲 RISC 与 CISC 之争?那场争论究竟在争什么,为什么会那么激烈?
帕特森: 事情要从微处理器的诞生讲起。微处理器是二十世纪七十年代发明的,但一开始基本上是个玩具,装在微波炉之类的东西里。我们这些相信摩尔定律的人认为,晶体管数量每一两年翻一番,总有一天,一块微处理器上的晶体管会多到足以构成一台像样的计算机,到那时所有的计算都会交给微处理器。
可当时在英特尔、德州仪器设计微处理器的人,并不是真正的计算机架构师。他们只是照抄大公司的做法。当时引领架构设计、也就是指令集设计的,是 IBM 和数字设备公司(DEC)这样的龙头企业:IBM 做大型机,DEC 做所谓的小型机。小型机有一台或几台冰箱那么大,大型机则要大得多。这些公司拿摩尔定律多出来的晶体管做什么呢?造越来越复杂的指令。当时的理念是,指令集越复杂,抽象层次就越接近软件,这比停留在较低层次有天然的好处。
而我们这些身处这个领域的人,比如我在斯坦福的朋友约翰·轩尼诗(John Hennessy)和我,并不认为这一定是对的。编译器的工作本来就是把程序设计语言翻译到指令集,为什么不能让编译器来填这个差距?于是问题就变成了:对于正在崛起的微处理器,正确的指令集应该是什么样的?
多音节与单音节的赌注
帕特森: 主流观点站在复杂指令集这一边。打个比方,指令集就像一套词汇,复杂指令集相当于词汇表里塞满了多音节的长词。另一条路,也就是我们所说的精简指令集计算机(RISC),词汇表里全是单音节的短词。可以想见,一个程序如果用简单指令来执行,需要的指令条数更多;用复杂指令,条数更少,但每条复杂指令的执行时间可能更长。所以问题归根结底是:这两个比例到底是多少?
八十年代初这场争论刚开始的时候,火药味非常浓。一部分是在争这些比例会怎样,但很大一部分其实是哲学层面的:把指令集的层次降下来,让程序设计语言和指令集之间的鸿沟变大,你们不是在伤害整个软件产业吗?争论的激烈程度正来源于此。
几年之后尘埃落定,我们开始拿到数据。结果是,一个程序用简单指令来写,大约要多执行百分之三十到四十的指令,但这些指令可以跑得快四五倍。两相抵消,RISC 相对 CISC 有大约三到四倍的加速潜力。
凭直觉设计的年代
主持人: 你刚才提到那种哲学上的分歧,那个鸿沟。为什么这会引起争议?
帕特森: 很遗憾,我得说七十年代、甚至八十年代的计算机体系结构,很大程度上是靠直觉、靠感觉在做设计:我觉得这样做是对的,就这么做了。连当时的教科书都像产品目录,这里是一台计算机,罗列它的全部特性,那里是另一台计算机,再罗列一遍。这种局面很让人不满,因为这类争论按理说应该能用科学的方式、用数字来裁决。可没有数据,争论就变成了「一个针尖上能站几个天使」那样的经院辩论。你可以做定性的争辩,却没办法把争论了结。既然没有定量了结争论的手段,大家就只好一直吵下去。
ARM 如何定下胜负
主持人: 那 RISC 与 CISC 这场战争,最后有一方赢了吗?
帕特森: 我最近正好在网上看到有人重新回顾这段历史,他的结论是:CISC 赢了。这个看法相当短视。在个人电脑时代,软件以二进制形式发行非常重要。x86 一旦确立地位,个人电脑上的软件全都以二进制发行,这就很难撼动,成了更换指令集的巨大障碍。所以个人电脑基本上是由 x86 架构定义的。
但同样是八十年代,英国有一家公司想做个人电脑,叫 Acorn。他们决定要有自己的指令集架构、自己的芯片,因为当时市面上能买到的芯片速度都不够快。他们受到我们伯克利那几篇论文的影响,做出了所谓的「Acorn RISC 机器」(Acorn RISC Machine)。精简指令集有一个好处:它更简单,占用的资源更少,执行起来耗的能量也更少。几年之后,苹果想为自己的一款个人设备找一块微处理器,那款设备叫牛顿(Newton),算是 iPhone 的早期先驱。苹果找到这家公司说:「我们很喜欢这块芯片,不过把 Acorn 这个名字去掉吧。」于是缩写 ARM 保留下来,全称改成了「先进 RISC 机器」(Advanced RISC Machine),苹果把它用在了牛顿上。
牛顿在商业上并不成功,但它证明了 RISC 架构在移动设备上的优势。又过了几年,诺基亚推出 GSM 手机,那是最早流行起来的手机之一,他们选用了 ARM。从那以后,ARM 就统治了所有移动设备。我刚查过,到今天为止,采用 ARM 技术的微处理器已经出货三千五百亿颗。所以今天,计算机里百分之九十九的处理器都是 RISC,连个人电脑也不例外:苹果已经从 x86 架构切换到了 ARM。也就是说,即使在个人电脑领域,RISC 架构也已举足轻重。它还在向云端渗透。云端长期以来由 x86 服务器架构定义,但亚马逊、微软、谷歌现在都在开发自己的 ARM 处理器,RISC 处理器在云端越来越多。所以我要说,眼下 x86 架构的市场在萎缩,而 RISC 架构的市场在突飞猛进。
主持人: 既然有百分之九十九这个数字,怎么还会有人说 CISC 赢了?
帕特森: 如果一个人写历史时把「计算机」定义为个人电脑,或许再加上服务器,然后写到两千年前后就停笔,那故事到那里结束,看上去确实像是 CISC 赢了。可一旦进入后个人电脑时代,我不明白怎么还能得出那个结论。
x86 内部翻译的代价
主持人: 你提到了能耗。所以 RISC 在某些场合更有道理,比如移动设备?
帕特森: 在云端也一样。现在所有人都在意能耗,一切都受能量约束。当然,今天我们面对的不再是几百万个晶体管,而是几十亿个,所以指令集本身的影响相对小了一些,芯片上有太多东西在同时进行,可以把这部分开销藏起来。x86 架构为了竞争,做的事情就是在硬件里把 x86 指令翻译成 RISC 指令。你得为这个翻译步骤付出额外开销,才能拿到 RISC 指令,然后 RISC 阵营的任何好点子,x86 都能照用。从财务上讲,这笔额外开销是值得的,因为个人电脑软件积累的价值太大了。英特尔在两千年代初这么做非常合理,是个绝妙的商业决定。
主持人: 有没有什么小众场景,CISC 是合理的?这是一种工程上的权衡,还是说 CISC 客观上就更差?
微程序解释器的包袱
帕特森: 要回答这个问题,我们得往下再深一层,看看设计计算机时究竟在做什么。难点在控制逻辑。早期的控制逻辑相当随意,你把逻辑门拼在一起,拼到能工作为止。计算机先驱莫里斯·威尔克斯(Maurice Wilkes)想出了一种更优雅的设计方法:把所有控制信号当作一块存储器的输出,再用一个部件记录当前在存储器里的位置,依次发出控制信号。他把这些控制信号看成指令,称之为微指令,把编排微指令的工作叫做微程序设计。
以六十年代的技术水平,这么做相当合理,IBM 于是造出了所谓的微程序计算机。它本质上是一个解释器,用非常简单的指令去解释上层那套复杂得多的指令集。代价是解释的开销。计算机科学里有个经典结论,解释比编译大约慢五到十倍。但考虑到当时存储技术的延迟,加上可以用只读存储器来实现,这在六七十年代是说得通的。到了一九八零年前后,问题就来了:这还是个好主意吗?我们还应该在处理器里放一个微码解释器吗?另一条思路是,既然里面有个微码解释器,为什么不直接编译到那些指令上?这已经很接近 RISC 的想法了。当时的微指令有一百来位宽,非常复杂。如果把它做得不那么长,更自然一些,就可以跳过解释这一步。
回到你的问题,从这个层面看,今天还会有人发明一套复杂到需要微码解释器的指令集吗?大概不会。你可以这么做,没有什么阻止你,但你不会想设计一套非得靠微码解释器才能实现的指令集。也许在某些极小的应用里,芯片上只有几千、几万个晶体管,微码解释器还有用武之地。但我想,过去二十年里没有任何人发明过需要微码解释器的指令集。
编译器与寄存器分配
主持人: 你多次提到编译器,它似乎是让 RISC 行得通的关键一环。能讲讲编译器的角色吗?它是怎样协调软件与硬件的关系的?
帕特森: 你用 C、C++ 或者 Python 这样的语言写程序,但生成的代码质量取决于编译器。举个具体例子。构造计算机时,设置寄存器很有用,而寄存器在汇编语言或机器语言层面是可见的,可能有八个、十六个或三十二个,供在那个层次编程的人使用。过去,编译器很难高效地分配寄存器,因为计算机不够快,我们也没有相应的算法,能盯着一段代码或一个子程序,判断怎样使用寄存器最有效率。
C 语言就是为系统编程发明的。在此之前,操作系统是用汇编语言写的,说出来你可能不信。Unix 的两位作者肯·汤普森(Ken Thompson)和丹尼斯·里奇(Dennis Ritchie)证明,用一门相当底层的语言,也能获得高级语言的好处:人更容易理解,更容易调试。但因为编译器的寄存器分配做得太差,他们不得不加入一个功能,让程序员来提示哪些变量该放进寄存器。让程序员自己出面更省事:机器有八个寄存器,我要这六个变量放在寄存器里,别留在内存里,内存太慢了,寄存器快得多。
所以 RISC 与 CISC 之争的一个重要部分,就是编译器算法正在进步,它们能处理这些低层次的指令,能高效地分配寄存器。这是当年支持简单架构的又一条理由。我们在 RISC 架构里做的事情是:既然寄存器这么重要,寄存器分配这么重要,那么让编译器省事的办法之一,就是多给它一些寄存器。当时的 CISC 架构通常有八个或十六个寄存器,我们放了三十二个。理由是,既然少量寄存器很难高效利用,那就给足。即使编译器不够聪明,寄存器也够用。而且拜摩尔定律所赐,在机器里多加寄存器并没有贵多少。
编译器不用的复杂指令
主持人: 我在你的一场演讲里看到,编译器为 RISC 优化代码更容易,而 CISC 里那些复杂的大指令,编译器几乎从来不用。这是编译器的缺陷吗?
帕特森: 回到那个年代,当时的论点是:更复杂的指令能抬高抽象层次,缩小鸿沟,让编译器更轻松。但这是个哲学论点,并不是编译器的人能够落实的东西。提出这个论点的不是做编译器的人,而是架构师。
我们做早期 RISC 与 CISC 研究时去看实际的程序,结果发现编译器根本不用那些指令。常见的情形是,架构师设计出一条复杂指令,编译器的作者说:「我们不需要这个。」我们找到了不少这样的例子。比如过程调用的入口,架构专门内置了一条指令,把架构师以为编译器想要的全部工作一并做掉,而编译器的设计者说:「我们用不着,用几条单独的指令来做,比用你那条复杂指令还快。」
于是局面就成了这样:你为了拥有这些复杂指令,付出了微码解释器的额外开销,而编译器根本不去用它们。这是一个荒谬的处境。创业公司为什么会出现,科学上的转折点为什么会出现,道理是一样的。当我们把摩尔定律之下的所有技术摊开来看:高速缓存这样的新想法,编译器对复杂指令的实际使用情况,更高效分配寄存器的能力,把方向从微程序指令集架构转向更简单的架构,是合乎情理的。
登纳德缩放的终结
主持人: 我们谈指令集的时候,默认谈的是通用计算机,也就是 CPU。现在大家谈得很多的是 GPU,也许还有别的计算形式。那些机器也有指令集吗?
帕特森: GPU 在两千年前后出现,我们称之为领域专用架构。GPU 是图形处理单元,只有一项任务,不需要做通用处理器必须做的所有事情。它不必支持虚拟内存,甚至不必支持编译器,这对架构来说是相当激进的想法。它只为图形服务。英伟达和其他做 GPU 的公司当时的目标是给游戏和电影渲染图形,那是个小众产品。
计算机产业的走势由两条定律推动。一条是我反复提到的摩尔定律,另一条不那么出名,叫登纳德缩放(Dennard scaling)。有个有意思的问题:既然摩尔定律让芯片上的晶体管越来越多,每一两年翻一番,芯片为什么没有越来越烫?答案来自鲍勃·登纳德(Bob Dennard)的一个观察:增加晶体管的同时,人们也会降低阈值电压,也就是区分零和一的那个电压,而电压的影响是平方级的。于是晶体管数翻番,阈值电压下降,微处理器的功耗就一直维持在二三十瓦。我和约翰后来写了一本教科书,我查了一下,第一版是一九九零年出的,前三版根本没有把功耗当作一个问题来讨论。第三版是两千年出的,功耗仍然不是一个话题。因为登纳德缩放一直在起作用,微处理器越来越快,功耗却始终停留在几十瓦。
大约在二零零五年,登纳德缩放失效了。这是一个冲击。英特尔有一代微处理器就因此失败,功耗压不下来,太烫了。这迫使我们转向多核。在此之前,对程序员、对所有人来说,最省事的方案是一颗非常精巧的处理器包办一切,但这条路走不下去了。于是从一颗精巧的处理器变成两颗、四颗、八颗更简单的处理器。要兑现摩尔定律的潜力,就得靠程序员把代码并行化。
这种状态又持续了大约十年,然后摩尔定律开始放缓,通用微处理器几乎不再进步。它还有一点改善,但不再是戏剧性的飞跃。八十年代、九十年代、两千年代,你有一台笔记本电脑,朋友的笔记本可能比你的快四倍,你会嫉妒。性能变化太快,你会扔掉完好无损的硬件,就因为朋友的机器快太多。到了二零一零年代,这一切都结束了。你不会再因为新机器快得多而扔掉旧笔记本,只会等它坏了、变慢了才换。可程序员已经习惯了每隔几年性能就大幅提升,因为这样他们就能往软件里加更多功能。
那么架构师还能做什么?多核这一招在二零零五年前后已经用过了。于是到了二零一五年前后,思路变成了做领域专用架构,就像 GPU 那样。如果你告诉我,我只需要运行一小类程序,不必运行所有的操作系统和其他一切,那我确实可以重新调配资源,把这一类事情做得高效得多。有些事做得很好,另一些事要么做得很差,要么干脆不做。
机器学习成为那个领域
帕特森: 接下来的问题是:选哪个领域?非常巧,就在技术走到这一步的二零一二到二零一五年,机器学习和人工智能爆发了。该选哪个领域,答案不言自明,就是机器学习和人工智能。我在谷歌工作,但我想公平地说,谷歌是第一家真正看到机器学习潜力的大公司。他们押注,或者说担心,需求会把他们淹没,必须做定制硬件。谷歌二零一六年推出的张量处理单元(TPU)震惊了世界,让大家意识到我们应该为机器学习专门设计硬件,而且在这一个领域,性能可以继续大幅提升。
三种处理器的分工
主持人: CPU、GPU、TPU 这三者在高层次上有什么区别?
帕特森: CPU 必须是通用的。直到今天,CPU 里的通用核心,每一个都和二十年前的处理器很相似,设计上没什么意外,只是核心数很多,现在的 CPU 可能有五十到一百个核心。
图形处理的关键是内存系统要有很高的性能,所以 GPU 走了多线程的路线。它有硬件线程,发出一个内存请求之后,硬件切换去做别的事,等数据从内存回来再继续。这就是高度多线程的架构,它对图形处理很有效。图形还有一个特点,不需要很强的浮点运算,确切地说,不需要很宽的浮点。三十二位浮点对图形绰绰有余,十六位也行。所以 GPU 在多线程架构上推进十六位和三十二位浮点。由于它是自成一体的东西,不在计算机体系结构的主干上,它有一套自己的术语。我们的教科书里有一张类似罗塞塔石碑的对照表,一边是英伟达描述 GPU 的术语,另一边是这些术语在主流处理器设计里的对应说法。
所以 GPU 曾经是一种小众产品,恰好单精度浮点很快,半精度也很快,而且很便宜,几百美元一块。于是有人开始琢磨:对某些应用,如果我能把问题伪装成生成图像,就能用这些便宜的 GPU,它每一美元的浮点性能比任何东西都高。人们开始这样折腾。
英伟达的创始人兼首席执行官黄仁勋很喜欢这个想法。二零零六年,他出资开发一门程序设计语言,来驾驭这种为图形设计的多线程硬件架构,让它更容易编程。这就是 CUDA 的由来,我记不清它的缩写展开是什么了,本质上是一门为多线程 GPU 架构服务的专有语言。它类似 C,但不能直接拿 C 程序编译运行。人们确实喜欢它,至少比把程序改造成图像生成强多了。黄仁勋的愿景是,让那些在地下室打游戏的少年学会给这些东西编程。他还盯上了几个市场,比如能源部实验室的流体力学计算,他为这些领域构建专用库,用 GPU 去做图形以外的专用计算。这就是 GPU 的渊源。
从一开始就有人用 GPU 做机器学习,因为它的单精度浮点性能远超 CPU,处理器数量多得多,潜在性能大得多。突破性的时刻在二零一二年。机器学习界里,神经网络这一支只有少数拥护者,很多人不相信它。那年有一场图像识别竞赛,所谓的 AlexNet 击败了所有对手,这是机器学习和神经网络历史上的标志性事件。做出 AlexNet 的那个人在多伦多大学上过 CUDA 课程,学会了怎么用它,于是想,既然要做,就在 GPU 上做。廉价而快速的 GPU 让他能探索大得多的空间。他是参赛者里唯一用神经网络的,把对手打得落花流水。几年之内所有人都转了过来,不但改用神经网络,而且改用 GPU。所以 GPU 的血统是图形引擎,但更可编程,然后被用到了机器学习上。
TPU 的取舍
帕特森: 谷歌入场的时候,选择从一张白纸开始。他们不关心图形。神经网络的核心是矩阵乘法,就是它。于是他们设计的处理器里有一个巨大的矩阵乘法单元,这是主体,然后把不需要的东西统统扔掉。通用计算芯片上很大一部分面积是三级高速缓存,目的是避免把时间都耗在访问相对缓慢的内存上。而对机器学习来说,内存访问的时机是事先知道的,可以安排好,硬件缓存就没有意义了。他们只放了一块由软件管理的存储器,数据会按时传进来。这是一些创新。
他们还在浮点格式上创新。科学计算非常在意精度,大多用六十四位浮点,指数不到十位,剩下五十多位都是尾数。谷歌意识到,机器学习不需要那么高的精度,需要的是范围。于是谷歌做出了第一种指数位比尾数位还多的浮点格式,这是个激进的想法。它叫 bfloat16,全称 brain float 16,因为做这件事的是谷歌大脑(Google Brain)研究组。
所以这个架构有窄浮点格式,有大矩阵乘法单元,只有一个处理器,和其他产品不同,它只做机器学习。它把整个领域的人都震住了:推理性能比同期的 GPU 高三十倍,比 CPU 高八十倍。谷歌在内部部署一年多之后,在年度活动上宣布了这件事,所有人都坐不住了。英特尔开始收购公司,英伟达开始为机器学习修改设计,其他竞争者、各家超大规模云厂商都开始自己干。我认为 TPU 的发布是这里的分水岭。
主持人: 这听上去像是专用化的层级,CPU 最通用。
帕特森: 是的,但如果登纳德缩放还在,如果摩尔定律和登纳德缩放都还在,通用处理器今天会走到哪里?我们应该有一百太赫兹的微处理器了。如果能造出一百太赫兹的微处理器,我们就会那么做,GPU 会依然是个小众产品。那会水涨船高,皆大欢喜。可这已经是遥远的历史了,我们二十年没能做到。二零零五年就有两三吉赫兹的微处理器,今天差不多还在那里,几乎没有进步。所以我们做不到。CPU 依然有它的用武之地,操作系统、编译器这些东西需要它,它是正确的方案。但其他事情都专用化了。用产业的话说,现在巨量的投入都在往 AI 加速器、往 AI 上砸,钱都投在那里。于是每一个处理器设计者面对的问题是:我的处理器设计在这个 AI 宇宙里处于什么位置?为了这个重要的应用,我该怎么改?
摩尔定律死了吗
主持人: 你说摩尔定律在放缓。我看过吉姆·凯勒(Jim Keller)的一场演讲,他说摩尔定律没有死。说它放缓,这个说法有争议吗?
帕特森: 在真正的工程师那里没有争议。摩尔定律非常简单:一块芯片上的晶体管数量,最初说是每年翻一番,后来他修正为每两年翻一番。你只要去看,芯片上的晶体管数翻番了没有?没有。我想人们误以为,不再遵循摩尔定律就意味着技术不再进步,这不是一回事。技术只是不再以摩尔预测的速度进步。摩尔定律之所以了不起,是它持续了五十年,而且指引了半导体制造业的投资:我们得每一两年让晶体管数翻番,怎么做到?要造什么设备?它是整个行业的指导方针,这很不寻常。
现在的情况是,技术的某些部分还在进步,某些部分完全不动了。芯片上有一个很重要的部件是静态随机存取存储器(SRAM),它几乎不再进步。逻辑门还在进步,如果你做的是加法器、乘法器,这些部件还在变好。进步不再是均匀的了。我们还在用越来越奇特的封装来交付性能。过去一直是单芯片最好,所有东西放在一块芯片上就行。现在有了小芯片(chiplet)的思路,把多块芯片封装在一起。最新的 GPU,我想还有最新的 TPU,是把两块所谓的全光罩尺寸的裸片封装到一起。全光罩尺寸是半导体上能造的最大面积,光刻机步进重复,过去一个光罩里能放很多颗芯片,现在只放一颗。两块最大光罩的裸片组成一个节点,靠的是封装。所以从外面看,你可以说,看这么多晶体管,摩尔定律还在继续。但看看芯片内部,你就知道那已经放缓了。
我想这在一定程度上是情感问题。在半导体制造行业,很多人被问到你是做什么的,回答是「我造摩尔定律,我维持摩尔定律」。几十年都在干这个,突然有人说摩尔定律结束了,那就等于说你的职业生涯结束了。所以有情感的一面。但看数据就好,数据不支持凯勒的说法。我也没有说技术不再进步,技术在继续进步,尤其是领域专用架构。可如果你看通用架构,或者看其他存储技术,过去 DRAM 的密度每三年提高四倍,像钟表一样准,现在提高四倍可能要十年。有大量证据表明摩尔定律已不再适用。
封装、低位宽与骨架
主持人: 现在有没有某种新版本的摩尔定律,或者类似的东西,在指引微处理器的设计和架构?换个问法,英伟达和谷歌都在持续推出快得多的机器学习处理器,进步惊人。他们在做什么?
帕特森: 一部分是我说的封装,让你能塞进更多晶体管,同时把它们放得更近,因为距离很重要。一部分是在浮点格式上创新。超级计算机用六十四位,现在不但不是六十四位,不是三十二位,甚至不是十六位,八位和四位浮点都在用,数据类型在不断变窄。还有所谓的矩阵乘法指令,把这些能做重要专用计算的强大单元做得更大、更快。这些是正在发生的事情。但我们没有一条简化的指导原则贯穿其中。你必须了解技术的每一个部分,判断它进步得多快,能不能兑现,然后把这些拼起来下注。
我们刚有一篇论文通过审稿,很快会放到 arXiv 上,讲的是谷歌 TPU 这一系列。很了不起的一点是,谷歌 TPU,特别是训练用的 TPU,基本架构设计一直相当稳定。东西变大了、变快了,但如果你看它的设计,回到第一代训练 TPU,那张框图到十年后的今天仍然成立。二零一五年前后设计它的那些人干得真漂亮。主要部件还是那几样:一个大矩阵乘法单元,所谓的高带宽内存,一个配合矩阵单元的向量单元,基本构件都还在。
基准测试与软件护城河
主持人: 在你研究 CPU 的年代,基准测试在衡量架构性能上起了巨大作用。在 AI 浮点运算这个新领域,GPU 有大家公用的基准吗?也能用于 TPU 吗?
帕特森: 我和几位朋友参与推动了 MLPerf。它的灵感来自 SPEC CPU 基准。当年几家互相竞争的公司都声称自己比别人强,后来意识到这对行业没有好处,于是商定了一套共同的基准。MLPerf 现在由一个叫 MLCommons 的组织运营,目的也一样:既然要比较,就别在基准是什么这件事上争吵。这是一项认真的努力。
有意思的是后来的发展。设计有两部分,一部分是硬件架构,另一部分是机器学习库,实现这些应用需要的大量功能,而且库还会针对特定应用重写,而不只是提供通用库。这成了英伟达的一大优势,因为它是一家大公司,有大量工程师可以去写这些库。所以结果并不是一场中立的评测。比的是架构加上配套的库,还有编译器,尤其是每次都要量身定制的库。英伟达每发布一个新架构,就会修改一套库,让新架构跑得特别好,或者让应用跑得特别好。这是很强的组合。商业上大家说英伟达有「CUDA 护城河」,一部分是 CUDA 这门语言,但很大一部分是英伟达写的那些库。这让创业公司很难与英伟达竞争,一方面是他们在软件上投入不够,另一方面是英伟达的工程师就是比他们多得多,能把库调得更好。所以是库加架构构成了这个强大的优势,也是大多数人都用 GPU 的原因。
谷歌能开发自己的库。他们工程师没有那么多,比英伟达更依赖编译器,但也有一套自己的库。不过直到最近,谷歌的这些东西都只在内部使用,或者通过云服务使用。创业公司因此很吃力。这也是 MLPerf 没有那么普及的原因:不是所有人都跑它,因为英伟达跑得实在太好,远超所有人。创业公司没有那么多工程投入去打磨库,在 MLPerf 上很难展示自己的实力。
「糟糕职业」背后的清单
主持人: 你有一场很受欢迎的演讲,讲「如何拥有糟糕的职业生涯」,其实是把好建议反过来讲。能不能概括一下,你最希望人们记住的三件事?
帕特森: 说起来有一段渊源。我职业生涯早期,一位好友和我商量,怎么教研究生做好一场报告。我们觉得反过来讲「如何做一场糟糕的报告」会很有趣:如果你不想讲砸,这些就是要避开的坑。后来我又做了「如何拥有糟糕的职业生涯」,主要面向学术界的研究者。再后来是「如何建一个糟糕的研究中心」「如何建一个糟糕的实验室」。最近我在讲的是「如何让 AI 留下糟糕的碳足迹」,这是最新的一场。
不过可能更有用的是,我在演讲结尾通常会回顾自己的职业生涯,谈谈学到的东西。我最近写了一篇文章,叫《我职业生涯前五十年的人生教训》,分成职业建议和个人建议两部分。
个人这边,我要说:如果你有家庭,把家庭放在第一位。我们发明的技术让你太容易把工作带回家,忽略家人。我刚到伯克利的时候,有一次从硅谷回来,深夜送一位资深教授回家,他说:「戴夫,如果能重来一次,我希望多花点时间陪家人。」我从来不想说出这句话。没有人在临终时说,我真希望多在办公室待一会儿。让事业压过家庭的需要,永远是容易的,所以你得时刻记住这一点。
再说说财富。我是五十年代长大的,那时候的观念是,要快乐就得富有。但富有和快乐其实是两个不同的目标。我做决定时一律朝快乐这边倾斜,而不是财富,我对此感觉很好。就算到现在我也会问,为什么要选一样让我富有却不快乐的东西?你为什么要那样做?而我们这个行业碰巧财富也不少,所以追求快乐并不意味着要吃苦。
还有,玩得开心很重要。小孩子不用人教就会玩,可成年人太忙,觉得没时间玩。但你只能活这一次。我现在踢足球,骑自行车来参加这场访谈,举重,冲浪,和妻子、家人、儿子一起做事。玩很重要。
重要但不紧急的事
帕特森: 职业这边,有一条建议来自《高效能人士的七个习惯》那本书的作者。他画了一个四象限,一个维度是紧急与不紧急,另一个是重要与不重要。我们的技术,电子邮件、短信之类,都在诱使你盯着紧急的事,但你真的不该把大量时间花在那些不重要却紧急的事上。你需要自律,专门留出时间做重要而不紧急的事。不把这些时间圈出来,你可能什么都做不成。我在谷歌能看到别人的日程表,有些经理从早上八点到下午六点,每半小时都排满了,一周五天。我不明白他们哪来的时间思考和反省。
另一条职业建议是这样来的。有一天早上我醒过来,仿佛上帝对我说话,我像被雷劈中一样。那句话是:重要的不是你开了多少个头,而是你做完了多少件事。听起来相当显而易见,但我当时并不是这么做的,手上同时有很多事。从那以后,我一次只有一件主线。我和轩尼诗写教科书的时候,那就是主线;我当系主任的时候,那就是主线,旁边只做一点小事。约翰·轩尼诗也写过一本书,基于他当斯坦福校长的经历谈职业建议。他在书里说,人们只会因为你一生做过的五六件事记住你,而不是几百件小事。要给自己一个机会,做出几件真正自豪的事,最好把精力集中在少数几件上,指望其中有些能成大事,而不是把自己分散到许多事情上。有兴趣的话,搜「人生教训 大卫·帕特森 前半个世纪」,能看到完整的清单,一共十六条。
人比项目更值得在意
主持人: 你说不想回顾人生时觉得陪家人的时间不够。我从没听过有人说相反的话。为什么会这样?为什么所有人回头看,都不后悔陪家人太多?我猜总得有一个人会说:「我陪家人陪太多了,我的事业受损了。」
帕特森: 这是个相当哲学的问题:人生究竟是为了什么?什么叫成功?你得自己想清楚它对你意味着什么。如果你有财务目标,要当百万富翁、亿万富翁,并以此评判自己的人生,那好,祝你好运,这很难做到。
我快读完博士的时候,读了斯特兹·特克尔(Studs Terkel)的《工作》。他采访了各行各业的人,请他们回顾自己的职业,喜欢什么,不喜欢什么,有什么感受。我从中读出的是:和人打交道的人,牧师、教师、医生,对自己的职业感觉很好;而做那些转瞬即逝的东西的人,比如技术产品、飞机之类早已消失的东西,感觉就没那么好。他们真正在意的是共事过的人。前不久我和这里一位退休的工程学院院长一起去开会,他说:「戴夫,回头看,重要的不是项目,而是共事的人。」我心想,这我很早以前就知道了。这是一个上了年纪的人给出的忠告:你会更在意共事过的人,你帮助过的人会更重要。
关于个人幸福还有一点。心理学家过去只研究精神失常的人,后来开始研究人为什么快乐,而且他们知道原因:有一份你喜欢的工作,有朋友和家人,帮助别人,帮助别人会让你快乐,这是有定论的;还有某种精神层面的东西,不一定是正式的宗教,比如接触自然,感受自然的壮阔。让人快乐的清单是清楚的。而这个世界上满是不快乐的亿万富翁。如果钱能让人快乐,这些极其富有的人为什么对什么都那么愤怒?这就是我传下来的建议。
勇气与树敌
主持人: 你有一场演讲里有一页叫「对我管用的东西」,其中有一条很特别:你说勇气是你职业生涯里很重要的一部分。这不常听到。为什么勇气对职业这么重要?
帕特森: 这可能部分出于我个人的性格。我在班里是年纪最小的孩子,个子也小,发育得晚,所以一直很小。父母鼓励我去练摔跤。摔跤给你身体上的自信,我在高中和大学练了很多年。
从技术上讲,做事要有勇气,和一句老话是一致的:幸运眷顾勇者。这句忠告有两千年了。要想清楚这件事很难。海伦·凯勒写过,即使你处处求稳,照样会被逮住。所以不管怎样你都可能失败。如果你冒大险,有可能成功;如果不冒险,求稳妥,多半不会成功。幸运眷顾勇者,而这需要勇气。
对我来说,在智识上也是如此。如果有什么不对的东西,我觉得我必须站出来面对它。说来讽刺,这也来自我性格里摔跤的那一面:看到有人被欺负,我会站出来阻止。在智识上我感到同样的责任,如果有人在做糟糕的论证,或者在做不该做的事,我们需要站出来。我对此感觉很好。需要提醒的是,我的一位资深同事看出了我这个性格,他对我说了一句老话:朋友来来去去,敌人却越攒越多。想想看,高中同学里一时的朋友你会渐渐忘掉,可一个真正讨厌你的人,你永远不会忘记自己讨厌他。所以,在重要的时候要站出来,但树敌要小心,因为他们会跟你很久。
主持人: 你说的「技术上出了问题」,是指有人说错了吗?
帕特森: 是指论证站不住脚,无论是政治上还是技术上的弱论证。我真心喜欢有一个思想的市场,通过争论把想法磨得更锋利。如果一个论证似是而非,哪怕它出自公司的领导者,就是说不通,我觉得有人站出来指出来,对公司更好,而不是任由它蒙混过去。这有点对抗性,但只要大家都同意这是为了更大的善,我们要把正确的想法摆出来,那就来争论这些想法,把它们打磨得更强。我认为这在科学、工程里很重要,在生活里也一样。眼下这个国家正在发生很多令人担忧的事,我肯定站了出来,写过评论文章,谈我认为错误、需要纠正的事情。如果人们害怕这么做,害怕在出现错误时站出来阻止,就很难对未来保持乐观。
乐观与九个词
主持人: 你在演讲里还提到乐观,讲了一个故事,不知道你愿不愿意再讲一次。
帕特森: 当然。在工程上,你很难事先知道对错,但我认为你需要乐观,需要积极的心态,因为可能出错的事太多了。我有个自己的故事来说明这一点。回到高中,我十六岁,在和一个很漂亮的女孩约会。我鼓起勇气问她,我们能不能确定关系,当时的说法叫「稳定交往」。她看着我,她也十六岁,跟别的男孩约会过,觉得我们都还太年轻。她说:「戴夫,你人这么好,我不知道该怎么说不。」对我这个讲逻辑的人来说,这听起来像是同意了。于是我抱住她说:「太好了。」她心里想的是,以后再慢慢让他死心。可我们已经结婚五十九年了,她到现在还没让我死心。这就是乐观得到回报的例子。
主持人: 听到一段这么长久的健康关系,大家都会想知道你是怎么做到的。
帕特森: 我过去常对人说,去参加婚礼,你会发现婚礼誓词写得真好,可没有人记得住自己的誓词。我以前说「记住你的誓词」,没人记得住。所以我们把它浓缩成九个有魔力的英文单词,其实就是三句话,都以「我」或「你」开头,三句都得说:我错了,你是对的,我爱你。就这九个词。这对关系中的双方都适用,不只是一方。三句都要说,不许替换,「我错了,你是对的,你是个混蛋」是不行的。记住这九个词,能帮你拥有一段像我和妻子那样长久的关系。
回到起点的忠告
主持人: 最后一个问题。带着你今天的全部经验,如果能回到刚入行的自己面前,你会给自己什么建议?
帕特森: 我刚到伯克利的时候有冒名顶替综合征。我是加州大学洛杉矶分校的研究生,忽然成了伯克利的教授,这让人很有压力。但过了一阵我想,我大概拿不到终身教职,那不如好好享受。所以我觉得我当时的心态已经是对的。第一年很煎熬,一边应付冒名顶替的感觉,一边学着当伯克利的教授,但之后我处理得不错,陪孩子的事一件也没落下。
这个问题还有另一个版本:有没有什么事我想重来一次?有一件。我当过体系结构学界的主席,就是 SIGARCH,它每年办一次会议。那是九十年代,我是主席。我当时不知道,在这些会议上有男性在骚扰年轻女性。我压根没往那里想:像我这样的人,年轻人,没人会干这种事,只有白痴才会,这不可能发生。可它确实在发生。我真希望当时有人跟我说一声,因为我会去纠正那些人,我会威胁他,敢这么干就要他的命。唯一让我稍感安慰的是,著名的计算机架构师萨丽塔·阿德韦(Sarita Adve)说她当时也不知道。五到十年之后,这件事才逐渐清楚,也才有了处理机制。这是我唯一想回到过去改变的事:我会弄清楚状况,去纠正那些男人,我相信那能制止他们。
主持人: 非常感谢你今天抽出时间。
帕特森: 谢谢你的采访。
一句话概括
图灵奖得主 David Patterson 回顾 RISC 与 CISC 之争的来龙去脉,解释为何 RISC 最终赢得 99% 的处理器市场,并梳理登纳德缩放失效、摩尔定律放缓如何把行业推向 GPU/TPU 这类领域专用架构,最后分享职业与人生建议。
核心要点
- RISC 与 CISC 之争本质是"指令复杂度 vs 执行速度"的比值问题。 1970 年代微处理器只是玩具,Intel、TI 等厂商模仿 IBM 大型机和 DEC 小型机,用摩尔定律增加的晶体管堆砌越来越复杂的指令,理由是"抬高抽象层次、缩小与软件的差距"。Patterson 和 Hennessy 认为编译器可以填补这个差距。几年后数据出来:RISC 程序需要多执行约 30%~40% 的指令,但每条指令快 4~5 倍,净收益约 3~4 倍加速。
- 早期争论激烈是因为当时的体系结构缺乏定量方法。 1970~80 年代的设计靠直觉和"感觉",教科书像产品目录,只罗列各机器特性。没有数字就无法裁决,争论沦为"针尖上能站几个天使"式的哲学辩论,这也是后来 Hennessy 与 Patterson 推动定量方法的动因。
- "CISC 赢了"是只看到 2000 年前 PC 时代的短视结论。 x86 靠二进制软件分发形成了难以撼动的生态。但英国 Acorn 受伯克利论文影响做出 Acorn RISC Machine,Apple 为 Newton 采用后改名 Advanced RISC Machine 即 ARM,随后 Nokia GSM 手机采用,ARM 从此统治移动设备,累计出货约 3500 亿颗。如今 99% 的处理器是 RISC,Apple PC 已转向 ARM,Amazon、Microsoft、Google 也在云端自研 ARM 处理器,x86 市场在萎缩。
- x86 的存活方式是在硬件里把 CISC 指令翻译成 RISC 微操作。 Intel 在 2000 年代初这样做,付出了翻译开销,却能借用 RISC 的所有好处,靠 PC 软件生态的价值抵消成本。深层看,CISC 依赖 Maurice Wilkes 发明的微程序解释器,解释比编译慢 5~10 倍,在 1960~70 年代内存技术下合理,但到 1980 年已无必要。近 20 年没人再设计需要微码解释器的指令集,仅在数万晶体管的微型应用中或许还说得通。
- 编译器进步是 RISC 成立的关键前提。 早期编译器寄存器分配能力差,C 语言甚至要让程序员用 register 提示哪些变量放寄存器。RISC 的应对是干脆把寄存器从 8 或 16 个增加到 32 个,让编译器"即使不够聪明也够用"。研究还发现编译器基本不用 CISC 的复杂指令,例如过程调用专用指令,编译器作者反而说拆成简单指令更快,于是出现"为解释器付出开销、指令却没人用"的荒谬局面。
- 登纳德缩放失效是架构分岔的真正转折点。 晶体管翻倍的同时阈值电压下降,功耗按平方效应抵消,因此微处理器长期维持在 20~30 瓦,Hennessy 与 Patterson 的教科书前三版直到 2000 年都没把功耗当议题。约 2005 年缩放停止,Intel 某代产品因发热失败,业界被迫从单个复杂核心转向 2、4、8 个简单核心,并行化的负担转嫁给程序员。约 10 年后摩尔定律也放缓,通用处理器几乎停滞,2005 年的 2~3 GHz 至今基本没变。
- 领域专用架构在 2015 年前后与机器学习的爆发恰好相遇。 GPU 原本是 2000 年左右为游戏和电影图形做的利基产品,不支持虚拟内存和编译器,靠硬件多线程掩盖内存延迟,用 16/32 位浮点,售价数百美元。2006 年黄仁勋资助开发 CUDA 让其可编程。2012 年 AlexNet 作者因在多伦多大学上过 CUDA 课程而用 GPU 训练神经网络,碾压竞争对手,此后整个领域转向神经网络加 GPU。
- TPU 是白纸重来的设计,性能差距震动了业界。 Google 意识到神经网络核心是矩阵乘法,做了巨大的矩阵乘法单元,去掉三级缓存改用软件调度的暂存内存,因为访存模式已知。还首创指数位宽于尾数位的 bfloat16,因为 ML 需要范围而非精度。2016 年发布时推理性能约为同期 GPU 的 30 倍、CPU 的 80 倍,随后 Intel 大举收购、Nvidia 改设计、各超大规模厂商纷纷自研。TPU 训练架构的基本框图从 2015 年沿用至今,核心仍是矩阵单元、高带宽内存和向量单元。
- 摩尔定律已放缓,这对真正的工程师并无争议。 摩尔定律的定义就是芯片内晶体管每 1~2 年翻倍,它曾指导整个半导体行业 50 年的投资方向。如今改进不再均匀:逻辑门仍在进步,SRAM 几乎停滞,DRAM 密度从每 3 年提升 4 倍变成约 10 年一次。最新 GPU 和 TPU 把两颗满掩膜版尺寸的裸片封装在一起,从外部看晶体管仍在翻倍,但芯片内部早已放缓。Patterson 认为 Jim Keller 说"摩尔定律没死"更多是半导体从业者的情感因素,数据不支持。
- 现在的性能增长靠封装、窄数据类型和更大的矩阵单元,而 Nvidia 的真正护城河是库。 浮点从 64 位一路降到 8 位甚至 4 位。MLPerf 仿照 SPEC 建立了统一基准,但结果取决于"架构加为每次新硬件定制重写的库"。Nvidia 工程师数量远超初创公司,因此后者难以在 MLPerf 上展示实力,这也是很多厂商不跑 MLPerf 的原因。Google 靠更多依赖编译器来弥补库工程师不足。
结论与值得注意的细节
- Patterson 的判断是:如果登纳德缩放和摩尔定律仍在,今天应该有 100 THz 的通用处理器,GPU 依然会是利基产品。正因为通用路径走不通了,CPU 才退守到操作系统和编译器等必须通用的领域,资金全部涌向 AI 加速器,每个处理器设计者都得回答"我的设计如何融入 AI 世界"。
- 关于 GPU 术语,他们的教科书专门做了一张"罗塞塔石碑",把 Nvidia 自创的术语对应到主流体系结构术语,反映 GPU 曾长期游离于主流架构之外。
- 职业建议部分:写过《如何拥有糟糕的职业生涯》系列演讲,最新一篇是《如何给 AI 一个糟糕的碳足迹》。核心是家庭优先、选择幸福而非财富、留时间玩乐、按"重要但不紧急"来分配时间,以及"不在于开始多少事,而在于完成多少事",一个人一生只会因五六件事被记住。
- 他强调勇气:来自摔跤训练的自信让他习惯在论证薄弱时站出来反驳,哪怕对方是公司领导。但也引用告诫"朋友来来去去,敌人不断积累",树敌要谨慎。
- 唯一想改写的过去:1990 年代任 SIGARCH 主席期间不知道会议上有男性骚扰年轻女性,若当时有人告知,他会直接制止。
- 婚姻 59 年的秘诀被他压缩成九个英文词、三句话:我错了,你是对的,我爱你。三句必须全说,不能替换。

追问一个大问题。 苏菲拉底的每周来信,写这一周在追问的问题和看到的回应。
 微信公众号