
CHM Live | The Great Chatbot Debate: Do LLMs Really Understand?
节目发布 2025-03-27 · Computer History Museum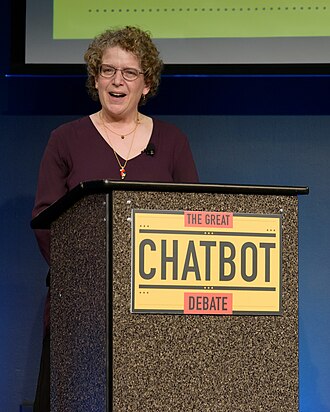
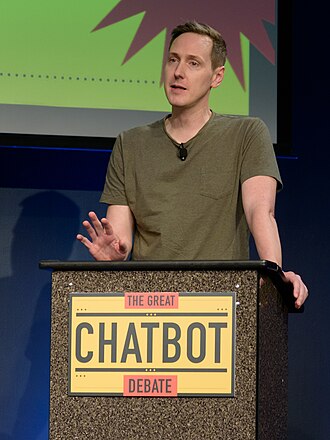
2025 年 3 月,计算机历史博物馆(CHM)与《IEEE 综览》(IEEE Spectrum)联合举办「聊天机器人大辩论」,辩题是「大语言模型真的理解吗」。反方是华盛顿大学语言学教授、《论随机鹦鹉的危险》合著者艾米丽·M·本德,正方是 OpenAI 技术团队成员、《通用人工智能的火花》作者塞巴斯蒂安·布贝克,《IEEE 综览》高级编辑伊莱莎·斯特里克兰担任辩论主持。本文依据现场录音编译整理。文中「主持人」指博物馆活动主持人,辩论环节的提问者标为「斯特里克兰」。
开场:聊天机器人的展览
主持人: 晚上好,各位。今晚来了这么多人,欢迎大家来参加这场「聊天机器人大辩论」,也感谢全国乃至全世界正在观看直播和回放的朋友。无论你站在哪一边,是「人工智能」的信徒,是怀疑派,还是压根不知道大语言模型是什么,今晚都会是一场精彩而热烈的活动。首先要感谢今晚的赞助方帕特里克·J·麦戈文基金会,正是他们的慷慨支持,以及各位会员的支持,让我们的工作得以进行。也要感谢豪斯家族酒庄为会前酒会提供的葡萄酒。今晚的活动由我们与《IEEE 综览》联合主办,整个筹备过程是一次真正的协作,感谢伊莱莎和她的团队。
第一次来博物馆的请举手。很好,希望大家还会再来。楼下正在展出「聊天机器人解码」(Chatbots Decoded),它把今晚讨论的话题变成了可以互动的展品,你可以用自己选择的语言和一个机器人对话。在计算机历史博物馆,我们的使命是解码技术:它的计算过往、数字当下,以及对人类未来的影响。今晚的节目正是这一主题的体现,我们要探讨并辩论,「人工智能」究竟有多智能。
今晚双方都是重量级人物。一方是华盛顿大学的艾米丽·M·本德,她是计算语言学实验室主任、语言学教授,兼任计算机科学与工程学院和信息学院的客座教授。她以对 AI 语言模型的批判立场著称,是《论随机鹦鹉的危险》(On the Dangers of Stochastic Parrots)一文的合著者,新书《AI 骗局:如何对抗大型科技公司的炒作并创造我们想要的未来》将于 5 月 13 日出版,请记得预订。另一方是 OpenAI 的塞巴斯蒂安·布贝克博士,他目前是 OpenAI 技术团队成员,此前担任微软 AI 副总裁和杰出科学家,在微软研究院工作了十年,更早时是普林斯顿大学助理教授。他 2023 年的论文《通用人工智能的火花:GPT-4 早期实验》(Sparks of Artificial General Intelligence)在《纽约时报》《连线》等媒体引发了广泛讨论。今晚在八角笼里执裁的,是《IEEE 综览》高级编辑伊莱莎·斯特里克兰,她长期报道 AI、生物医学技术和其他前沿技术,常在播客露面,从西南偏南到今晚的博物馆,主持过许多活动。下面请她为今晚的辩论开场。
火花对阵鹦鹉
斯特里克兰: 大家好,感谢各位到场。先用一分钟介绍一下《IEEE 综览》:我们是 IEEE 的旗舰刊物,IEEE 是电气与计算机工程师的专业组织,全球有五十万会员。我们有月刊,也有对所有人免费开放的网站,上面有各种精彩的技术报道。
当《IEEE 综览》开始和博物馆商量办这场辩论时,我立刻知道自己想在台上看到什么:火花对阵鹦鹉。反方人选,我想不出比艾米丽·本德更合适的人。她关于随机鹦鹉危险的那篇论文写于 ChatGPT 问世前几年,就已点燃了关于语言模型风险的激烈争论,如今看来非常有先见之明。这些年我采访过她几次,她有一句话一直留在我心里:我们理解语言的方式,是去想象正在对我们说话的那个人的心智。所以当我们遇到合成文本时,我们是在想象一个并不存在的心智。我觉得这个视角很有意思。
正方,我想请的是塞巴斯蒂安·布贝克,他写了《通用人工智能的火花》那篇预印本,分享了对 GPT-4 的早期实验。论文发布前后,我在一档播客里听他谈到 OpenAI 早先的模型和 GPT-4 之间的差别。他说,最大的问题是早先的模型并没有真正掌握「猫」或「狗」这样的概念,而到了 GPT-4,他清楚地看到它确实理解了某些东西。
所以我认为他们是最理想的辩手,很幸运两位都答应了。
从图灵测试到 Eliza
斯特里克兰: 先简单回顾一下历史,说说这些技术是怎么运作的,以及眼下正在发生什么。大家大概都听过图灵测试。二十世纪五十年代,著名计算机科学家艾伦·图灵提出了一个思想实验:假如一位人类评判者通过计算机界面同时与一个人和一台机器聊天,而他分不出哪个是哪个,那就说明这台机器至少把人模仿得足够像,足以展现出智能行为。图灵没有直接说它就是智能的,只说它展现了智能行为。在当时,计算机能通过这项测试被认为是纯粹的幻想。
时间来到 1966 年,麻省理工学院教授约瑟夫·魏岑鲍姆造出了第一个聊天机器人,巧的是,它也叫 Eliza。它模仿心理治疗师,把你说的话反射回去。你说「我工作压力很大」,它就问「你为什么工作压力很大」;你说「我很生我妈妈的气」,它就说「多讲讲你为什么生妈妈的气」。不过是些简单的脚本。但有意思的是,人们给这些脚本赋予了智能和情感。魏岑鲍姆的秘书和 Eliza 聊天时,甚至要请他离开房间,因为她想为这些私密谈话保留隐私。
之后是几十年的缓慢进展,我不打算把 AI 的整部历史讲一遍。直到 2010 年代,我们才有了 Siri 和 Alexa 这样勉强算得上像样的语音助手,但它们带来的挫败常常多于帮助。同样是 2010 年代,AI 领域开始了一场革命:一种叫人工神经网络的技术,长期被视为死胡同,却突然复兴了。
神经网络与大语言模型
斯特里克兰: 简单说,神经网络是一类机器学习模型,灵感松散地来自大脑的运作方式。它由一层层相互连接的节点(或称神经元)构成,负责处理信息;神经元之间的连接带有权重,网络从数据中学习时会调整这些权重。神经科学里有句话,「一起放电的神经元会连在一起」,意思就是,学习过程中最活跃、联系最紧密的那些连接会得到强化。2010 年代的变化在于,这些机器突然有了海量数据可学:社交媒体上的所有图片,Reddit、社交网络和书籍里的所有文本。于是它们的能力跃升了一大截,先是在计算机视觉领域,然后是文本处理,也就是自然语言处理。
这催生了大语言模型(LLM)。它们建立在神经网络之上,能生成像人写的文本,因为它们读过太多这样的文本,基本上读遍了整个互联网。在训练过程中,模型摄入这些数据,学会识别其中的模式,比如哪些词和短语常常一起出现。这让模型能够预测句子里接下来是什么,或者根据你给的输入、提出的问题和提示,生成相关的回应。所以一个大语言模型可以前一分钟讲解量子物理,下一分钟用苏斯博士的风格写诗,再下一分钟写一道茄子食谱。它见过所有这些东西,于是基本上能做到它见过的一切,甚至更多,而那个「更多」正是有意思的部分。
但大家可能也见过,大语言模型常常犯令人尴尬的错误。比如一年多前谷歌的聊天机器人建议人们为了健康每天至少吃一块小石头,还建议往披萨里加八分之一杯胶水,防止配料掉下来。看到这样的事情,你难免会问:这里面到底发生了什么?
推理模型与过河谜题
斯特里克兰: 再说说当下。过去几个月,出现了一批强大的新模型,叫大推理模型。这算是大语言模型之上的升级:它们用思维链推理把一个问题拆成许多步骤,逐步执行,这似乎减少了错误,让模型不那么容易产生「幻觉」或失误。
变化究竟有多大,看一眼很有意思。我今天为了好玩自己试了一下。大家大概听过那道著名的谜题:一个人带着一棵卷心菜、一只羊和一头狼要过河,船上只能载他和一样东西。要怎么一次一样地运,才能不让羊吃掉卷心菜、狼吃掉羊?有意思的是,语言模型对这道题烂熟于心,因为它们见过。你换成老鼠、奶酪和猫,它们照样答得出。但如果你用很简单的方式改动一下题目,往往就能把语言模型绊倒。我今天问 ChatGPT:一个人和一只羊要到河对岸,他们有一条船,该怎么过去?它回答说:这个人带着羊过河,把羊留在对岸,然后独自返回原来这边去取船,现在人和船都在原来这边,而羊安全地在对岸。我指出这个人并不在正确的那一边,它说:抱歉,人和羊应该一起上船过河,人把羊留在远岸,独自带船回到原来这边,然后再自己划过去。你看,它像是在努力把碎片拼起来,但就是拼不对。然后我把一模一样的问题拿去问 OpenAI 的推理模型,它只说:让人和羊一起上船,划到对岸,就完事了。可以看出,这些模型的运作方式正在发生某种变化。
今天还有一件事在发生,就是 AI 智能体(agent)。它们是建立在语言模型之上的系统,能替你采取行动:帮你订餐厅,找去巴黎最好的航班,或者在亚马逊上搜最便宜的鞋。
辩题:何谓真正理解
斯特里克兰: 在这样的背景下,我们今晚面对的问题是:大语言模型真的理解吗?我们应该花点时间想想「真正理解」是什么意思,因为定义很重要。就人类而言,说一个人理解某个概念,通常是指他对它有深刻而直觉的把握,不只是知道事实、能复述信息,而是能在各种情境下运用知识,能感知意义和意图,并把这些想法与自己的世界模型联系起来。
至于大语言模型,问题就是这些 AI 系统是否具备类似的理解:它们真的理解自己说的话吗?还是只是在模仿训练数据里见过的模式,并无真正的领会?这就是今晚辩论的核心。如果大语言模型真的理解,那会改变我们与技术的互动方式,我们会让 AI 更深地嵌入日常生活。反过来,如果它们只是模仿模式,那我们在使用、整合和依赖它们时,也许就得更谨慎。
今晚的流程是:两位辩手先各自做开场陈述,然后进入我提问、他们互相提问的辩论环节,接着是现场和线上观众的问答,最后是结辩。辩论结束后,请大家再次参加 Slido 投票。还没投的现在就可以投,这样我们能知道辩论开始时观众站在哪里,结束时再看一次。听辩论的时候,请同时考虑两种视角,保持开放心态,批判地审视双方提出的证据和推理。这不只是一场技术辩论,也是一场哲学辩论,触及智能与理解的本质,触及在这个与机器交互的时代,做人意味着什么。
有请两位辩手上台,艾米丽和塞巴斯蒂安。刚才在休息室我们抛了硬币,艾米丽赢了,她选择先做开场陈述。
本德开篇:形式与意义
本德: 谢谢。感谢各位到场,感谢计算机历史博物馆组织这次活动,也感谢线上正在观看或将来观看的朋友。在开场的十分钟里,我要做四件事,依据的是我从二十世纪九十年代起研究和教授语言学与计算语言学所学到的东西。语言学在这里至关重要,因为它研究的正是语言如何运作、我们如何运用语言,而这两点都是回答「大语言模型是否真正理解」的关键。
四件事是:第一,给「理解」提供另一个定义;第二,讲讲什么是语言模型,它这些年是怎么发展的;第三,论证语言模型的整个发展过程中,没有任何环节让它们接触到语言这道「形式加意义」等式里的意义那一半,而没有意义就没有理解;第四,谈谈人是怎么理解语言的,以及这套机制为什么让我们容易陷入「大语言模型能理解」的幻觉。
说这些的时候,我会尽量避免拟人化的用语。我不会说大语言模型「努力」做什么或「试图」做什么,不会说它们「提问」或「回答」,至少会尽力不说,因为那会把水搅浑。同样,我提到「人工智能」或「AI」时一律加引号,因为它并不指代一套定义清楚的技术。总的来说,更好的做法是谈「自动化」,然后再谈我们在自动化什么,以及为什么要自动化它。
第一点,什么是理解。在我和亚历山大·科勒 2020 年发表的那篇论文(有时被称为「章鱼论文」)里,我们给理解下了一个技术性定义:理解就是从语言的形式(你听到的声音、看到的手语、读到的文字)映射到语言之外的某种东西。这个定义非常窄。按这个定义,你让语音助手开灯,它照做了,它就理解了这条指令。所以造出能完成这种映射的自动化系统,是可能的。
但人类使用语言时,通常远不止于此。比方说,我说「看那边那只鹦鹉」。单凭词语和语法,你就能知道我在把你的注意力引向某处,而且那里很可能有一只鹦鹉。但你在理解时投入的其他一切,还会让你知道:我希望你去看我称为鹦鹉的那个东西,而且我要么相信它确实可以被合理地叫做鹦鹉,要么在装作相信。这是我们日常所做的那种非常丰富的理解的一个例子。
假如我换成日语说这句话,不懂日语的人大概听不出什么。但如果是面对面,你能看到我的手势和目光,你可能会猜到我在把你的注意力引向某样东西。你朝那边看去,如果那里有一只鹦鹉,而且是最显眼的东西,你或许会猜到我刚才用的某个词就是日语里的「鹦鹉」(顺便告诉大家,是「オウム」)。这甚至能帮你开始学日语。但所有这些推断、所有这些意义,都不是从词语里来的。除非你懂日语,否则那些词对你毫无帮助,我相信在座肯定有人懂。在这种共处一地的情境里,因为你是一个人,带着全部的语境理解,你才能利用这些线索开始学日语。关键在于,大语言模型不会有这些。这一点至关重要。
从 T9 到 LLM
本德: 第二点,语言模型。这其实是很老的技术,可以追溯到克劳德·香农的工作,再往前是马尔可夫。在座很多人大概还记得手机上的 T9 输入法,「九键打字」:你按数字键,每个数字对应三四个英文字母,但输入四五个数字的序列后,词典里可能匹配的词只有那么几个,界面就按这些词在某份训练数据里的频率排好序给你。它很烦人,因为 home 和 good 对应同一串按键,不管你前面打的是「I'm coming」,出来的永远是 good,因为它在语言模型里更常见,而那个语言模型不过是一份词频统计。这是最基本的一元语言模型(unigram)。要让它更复杂,可以统计一个词在前面一到 n 个词的语境下出现的次数。这一直是自动转写和机器翻译技术的重要组件:先由一个组件说,给定这段声音序列,或者给定这串法语,可能对应哪些英语词,得出一批候选,然后请语言模型按「哪个最像训练数据」重新排序。这就是九十年代到两千年代的语言建模。顺带一提,它对拼写检查也很有用:从输入的字符出发,经过一两次替换、删除或插入能得到哪些词?按单纯的词频排序,或者按语境下的可能性排序。一旦语言模型能捕捉更多模式,它就能说,「这里的 there 用错了」,把这类错误挑出来。
在所有这些场景里,我们用语言模型回答的问题都是:在这个应用产生的一批候选字母串中,给定训练数据,哪一串最有可能?我们始终只和词的形式打交道,从不涉及这些词能用来指称什么,或者正被用来指称什么。
在这个背景下,今天所谓的 LLM 有两大区别。第一,机器学习架构有了进展,能够利用如今可以构建出来的巨型数据集(收集方式是有问题的,并未取得同意,但确实构建出来了)。这些架构在利用更大训练集的同时,建模的词间关系也远远超出「有四个前文词,给词表按可能性排序」的水平:它对哪些词在什么关系下、在多长的文本跨度上倾向于共现,建模得精细得多。同样重要的是,训练数据是不公开的,只有少数例外,比如艾伦人工智能研究所(AI2)对训练数据就相当公开。第二个大区别是,这套系统被翻了个面。我们不再用它回答「这几串候选拼写里哪一串最可能」,而是让它反复回答「下一个可能出现的词是什么」,一遍又一遍。
这是两大区别。还有两个小区别。一是额外的训练,比如基于人类反馈的强化学习(RLHF):大量数据标注工人看系统的输出,比较「这个更好,那个更好」,或者简单打「好」「坏」,让系统设计者把概率朝着标注工人点赞的词去塑形。二是输入和输出之间加了一些额外的处理步骤。比如扫描用户输入里的算术题,把它交给计算器,以免出现「明明是计算机却不会算数」的尴尬输出。有时用户输入会被转成网络查询,取回文档,再连同一段「生成摘要」的系统提示一起输入,这就是所谓的检索增强生成(RAG),实际上是把取回的文档做成一份纸浆拼贴,同时打消用户去原始语境里亲自阅读这些信息的念头。此外还有系统提示本身:你在 ChatGPT 输入框里打的字,并不是进入系统的唯一输入,外面还裹着一整段提示,每次还会把对话历史也塞进去,而你之后只看到那一小段输出。界面里藏着很多东西。
意义是我们赋予的
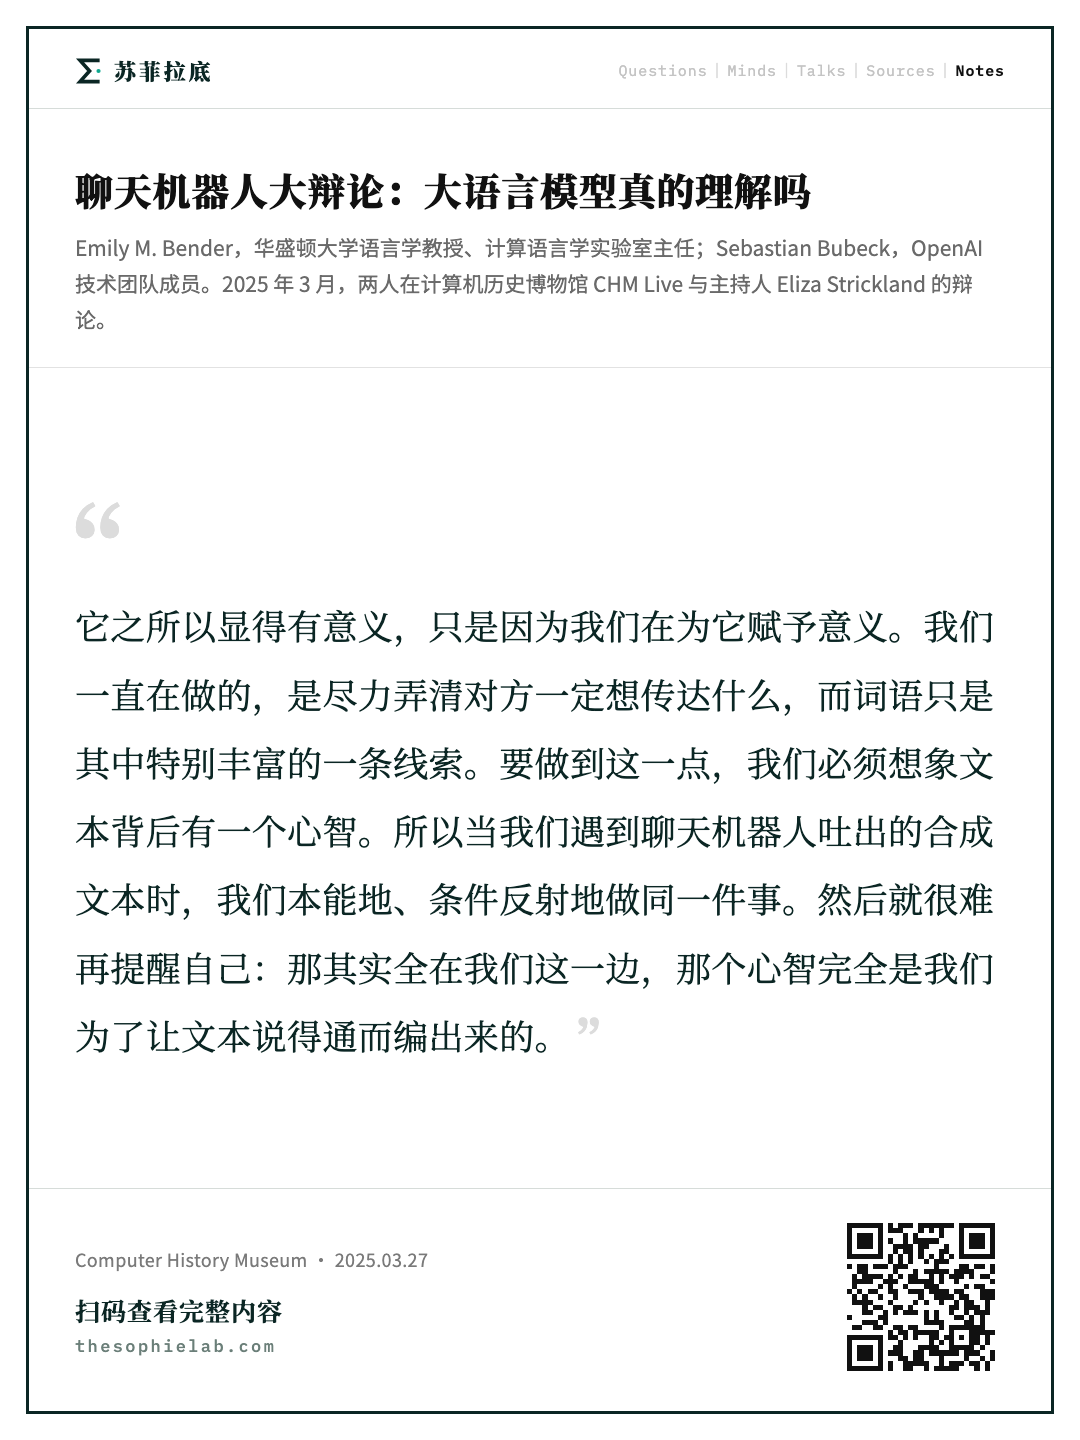
本德: 所有这些的结果,是看起来连贯的文本,按照做 RLHF 的标注工人的偏好被塑造得讨人喜欢。但它本质上仍然是反复回答「下一个可能的词是什么」的产物。那它为什么看起来像在理解?答案是:它之所以显得有意义,只是因为我们在为它赋予意义。你可能以为,理解你听到或读到的东西时,意义就在词语里,你只是把词拆开,把意义取出来。但语用学和心理语言学的研究告诉我们,事情并不是这样发生的。我们一直在做的,是尽力弄清对方一定想传达什么,而词语只是其中特别丰富的一条线索。
要做到这一点,我们必须想象文本背后有一个心智。所以当我们遇到聊天机器人吐出的合成文本时,我们做的是同一件事,本能地、条件反射地去做。然后就很难再提醒自己:那其实全在我们这一边,那个心智完全是我们为了让文本说得通而编出来的。
总结一下。「大语言模型能理解」这样非同寻常的主张,需要非同寻常的证据。提出这个主张的人还必须定义「理解」,而且这个定义要以我们对人类如何理解语言的知识为依据,还必须可证伪。隐瞒训练数据,甚至连数据里大致有什么都不说,是反科学的,因为这让人无法推断训练数据加上输入是如何得出输出的;也是反社会的,因为这让我们无法判断什么时候用这些东西是合适的。任何「文本进、文本出」形式的测试,在我们看来都可能像是系统在回答问题、在推理、很聪明,但我们要当心,这些测试真正检验的只是系统对训练数据词语分布的拟合程度,以及训练数据与测试情境的接近程度。所以,一句话:大语言模型理解吗?断然不。
布贝克开篇:观者之眼
布贝克: 大家好。我的看法会和艾米丽相当不同。我想先承认,今晚辩论的问题本身有点怪。我的意思是这样:前几天我在听一场像今晚这样的讲座,讲的是物理,一位哈佛教授在讲爱因斯坦的广义相对论,他在讲的过程中说,「爱因斯坦显然对广义相对论一无所知」。这对我来说非常重要:理解在观者眼中。我自己在研究领域里也有过很多次这样的体验,觉得某些研究者好像不太明白发生了什么。但他们当然明白,拜托,他们是这个领域的研究者。我想说的是,判断某人或某物是否理解,有不同的门槛、不同的层级。这是第一点。
第二点,正如伊莱莎和艾米丽所说,我们需要给理解下个定义。我完全同意。问题是,人类为「理解」的含义争论了几千年,先剧透一下:今晚我们不会把它弄清楚。我们谁都没有一个能涵盖这几千年工作的必杀定义。这一点很重要。
既然我不打算给大家一个理解的定义,我想回到有数字、有确凿数字、我们能非常精确地把握的东西:基准测试(benchmark)。基准是评估过去几年进步速度的好办法。我想花几分钟,和在座各位一起盘点一下我们这几年走了多远,然后再回到理解的问题。
基准分数的暴涨
布贝克: 两年半前,GPT-4 和 ChatGPT 问世前夕,我在一个关于神经网络数学理解的研讨会上,谷歌的一位同行给我看了他们刚训练的模型 Minerva,一个数学模型。这个模型能解出一道高中水平的题,我完全被震住了。那不过是一道关于直线相交的简单题,真的没有任何难度,但两年半前我为此震惊。今天,我们的系统正在角逐数学奥林匹克竞赛的金牌。我认为承认这一点很重要,而且这与我们给理解下什么定义无关。这就是我们正在目睹的进步速度。
拿 MATH 基准来说,它是高中竞赛水平的题目。两年半前,聊天机器人能拿大约 20%。到去年初,它已经完全饱和,模型太强了,这个基准没法再用,只好废弃。还有一个曾经非常流行的基准叫 MMLU,测的基本上是高中水平的科学问题理解。它曾是一个极其重要的基准,大型科技公司的 CEO 们都在谈它,谁多了 2% 或 5% 都能撼动全球市场,马克·扎克伯格三天两头提起它。现在你完全听不到了。为什么?因为它也完全饱和了,模型在上面太好了。于是我们不断推出更新、更难的基准。眼下大家争相刷高的最新基准叫 FrontierMath(前沿数学)。顾名思义,这些是非常高深的数学研究问题,不是未解难题,但也是你会拿去问数学系低年级博士生的那种题。这个基准大约四个月前推出时,OpenAI 当时最新的推理模型 o1 只能答对 4%。大家都很满意:终于有一个超出模型能力的基准了。一个月后,我们发布了 o3,其实是 o3-mini,一个更小的模型,它拿到了 30%。我甚至不知道地球上有没有哪一个人能独自解出这些题的 30%。这就是我们所说的进步速度。
省下三天的 o3-mini
布贝克: 不过说实话,我个人并不喜欢基准测试。两年前写《通用人工智能的火花》,整篇论文的要点就是我们需要摆脱基准,因为,我想在这一点上我们会有共识,基准无法展示理解。无论你把基准设计得多好,都很难从中提取出理解。在我看来,理解要靠与系统互动来判断,同时非常小心地不把看到的输出拟人化,而是真正去探究,追问一些试探性的问题,看看理解能走多远。因为理解不是一个二元的概念,不是零或一,它是一个连续的量:你理解到什么程度?
所以我想回到一种更务实的理解观:这些系统能为你做什么?它们能不能以某种方式帮你理解新的东西?在这一点上,我想请每个人回想自己与这些模型打交道的经历。和两年前相比,如今的好处是在座每个人大概都用过聊天机器人。所以你自己就能判断它们是否理解,判断它们有没有以某种方式帮到你。我说说我自己的经历。最近我用 o3-mini 问了一个数学研究问题,我确定网上任何地方都没有答案。我怎么知道?因为那是我自己思考过的问题,我甚至为它写了一篇论文,只是一直没时间发表,它就躺在我的 Dropbox 里,大概只有另外两个人看过。我想没有人知道答案。我把这个问题拿去问 o3-mini。如果你感兴趣,它是一个关于轨迹长度的优化问题,细节无关紧要。重点是,o3 当然没有解出来,那要求太高了,我根本没抱这个希望。但它给出了一个建议,指出这个问题与另一个领域的联系,而这个联系我本人花了三天才发现,这个模型对着问题推理和思考两分钟,就找到了。这是否意味着它理解?很难说。它是否极有帮助,是否加快了我的工作,让我可以把那三天花在别的事情上?绝对是。这就是我想把讨论引向的方向。
我还想补充一点,是有利于「缺乏理解」,或者说「理解究竟是什么」这一面的。这里要回到哲学家关于理解含义的争论。我认为有一种可能:说到底,理解是一段属于人的旅程,关乎的是我们自己的理解。所以我说,与其问「聊天机器人理解吗」,不如问「聊天机器人是否帮你理解了更多东西」。举个例子,在数学领域,完全有可能在未来几年内,这些模型做出突破,发现新东西,证明没有任何人证出来的新定理。但数学界可能不会接受。它会承认定理被证明了,但会说,而且我认为说得对,我们仍然不理解它。只有当一个人能完整掌握整个证明时,我们才会承认我们理解了。我的开场陈述就到这里。
AAAI 调查与 AGI 之路
斯特里克兰: 我们开始吧。第一个问题是关于美国人工智能促进协会(AAAI)本月早些时候发布的一份报告,其中调查了 475 位 AI 研究者。大约 76% 的受访者认为,扩大现有方法的规模不太可能或极不可能实现通用人工智能(AGI);80% 的受访者认为,当前公众对 AI 能力的认知与现实不符。这和我们讨论的理解问题有些相邻,但我很想知道两位怎么看这些结果,因为它显示研究界对技术目前所走的路线能否通向伟大成就,有相当程度的怀疑。塞巴斯蒂安,先从你开始。
布贝克: 这确实是个很有意思的问题,因为过去几年最让我震惊的一件事,就是学术界和研究者群体几乎是最慢理解正在发生什么的人。也许这有充分的理由。大语言模型的问题在于,至少从我们对这些对象的数学理解来看,它完全违背了我们自以为了解的关于神经网络和人工智能的一切。作为一个研究群体,我们从来没想过 ChatGPT 这样的东西是可能的。所以很多怀疑残留下来,这是第一点。第二点,「扩大规模」到底指什么?正如你在开场时说的,现在有了新的推理模型,它们是在沿着另一条轴扩展规模。对我来说这都是一回事,我不区分这些不同的方法,从某个抽象层面看它们完全相同。但它确实不是从 GPT-1、GPT-2、GPT-3 到 GPT-4 那种纯预训练范式,而是一种略有不同的扩展范式。所以受访者也许是在说,经典的预训练路线不会把你带到 AGI。这一点我完全同意,绝对同意。但作为人类整体,我们是否走在通往 AGI 的路上?是有可能的。
斯特里克兰: 艾米丽,你的看法?
本德: 先说第二个问题,我认为那是个像样的问题。问「炒作是否与我们实际拥有的功能相符」,拿这个问题去问人是合理的,而构建这些系统的人也许正处在回答它的好位置上。所以这个结果不让我意外,它符合我对现实的看法。第一个问题作为调查题则是坏掉的,因为 AGI 没有定义。除非那份调查给出了一个具体定义让受访者据此回答,否则这是一道失败的调查题。我还要说,我非常反感研究者话语里常见的一种套路,记者和 CEO 有时也这么说:未来存在某个 AGI 出现的时刻,问题只在于我们是否走在通往它的正确道路上、跑得有多快。我在两个方面反对这种说法。首先,没有理由相信这个未经定义的东西必然存在于未来。其次,科学不是这样运作的。科学不是选一条路然后沿着它猛跑,它是一项集体事业,人们分头探索,彼此告知发现了什么。塞巴斯蒂安,这也正好回应你刚才说的:如果一个自动系统产出了定理证明,而数学界无法理解它,这算不算证明了定理?我认为这直接指向一个事实,一切学术都是对话。你独自做了一件让自己满意的事,那还不是科学,也不是学术。
布贝克: 但还有在现实世界里做成事情这回事。比方说,你在化学里发现了某个新公式,能据此造出新的化合物,这就是确凿、具体的证据,证明你做成了。你不需要谈论它,你拥有它,能用它造出新东西。所以这种务实的视角,看它们能为你做什么,很重要。举一个极其具体的例子:假设我想做一个应用,我让其中一个模型替我做。我不是说现在就能做到,但假设将来我只用自然语言说明我要什么,第二天回来,砰,应用就在那里,也许已经装到我手机上了,一切就绪。模型在做出它的过程中理解了吗?某种意义上,我不在乎。它替我做成了一件事。
只看有用就够了吗
斯特里克兰: 那你在乎它是否理解吗?问题出在哪里?
本德: 我在乎它们是否理解,是因为围绕它的许多话语,比如「它能当机器人治疗师、机器人律师、机器人家教」,其前提都是它「似乎在理解」这种观感,或者说这种氛围。这非常成问题。我一向拒绝被称为 AI 研究者,我对那没兴趣。我是计算语言学家,本来安安静静地做语法工程,然后这一切发生了,我意识到语言学在这里真的有很多话要说。别人也许为理解的定义挣扎了几千年,但我们是有定义的。
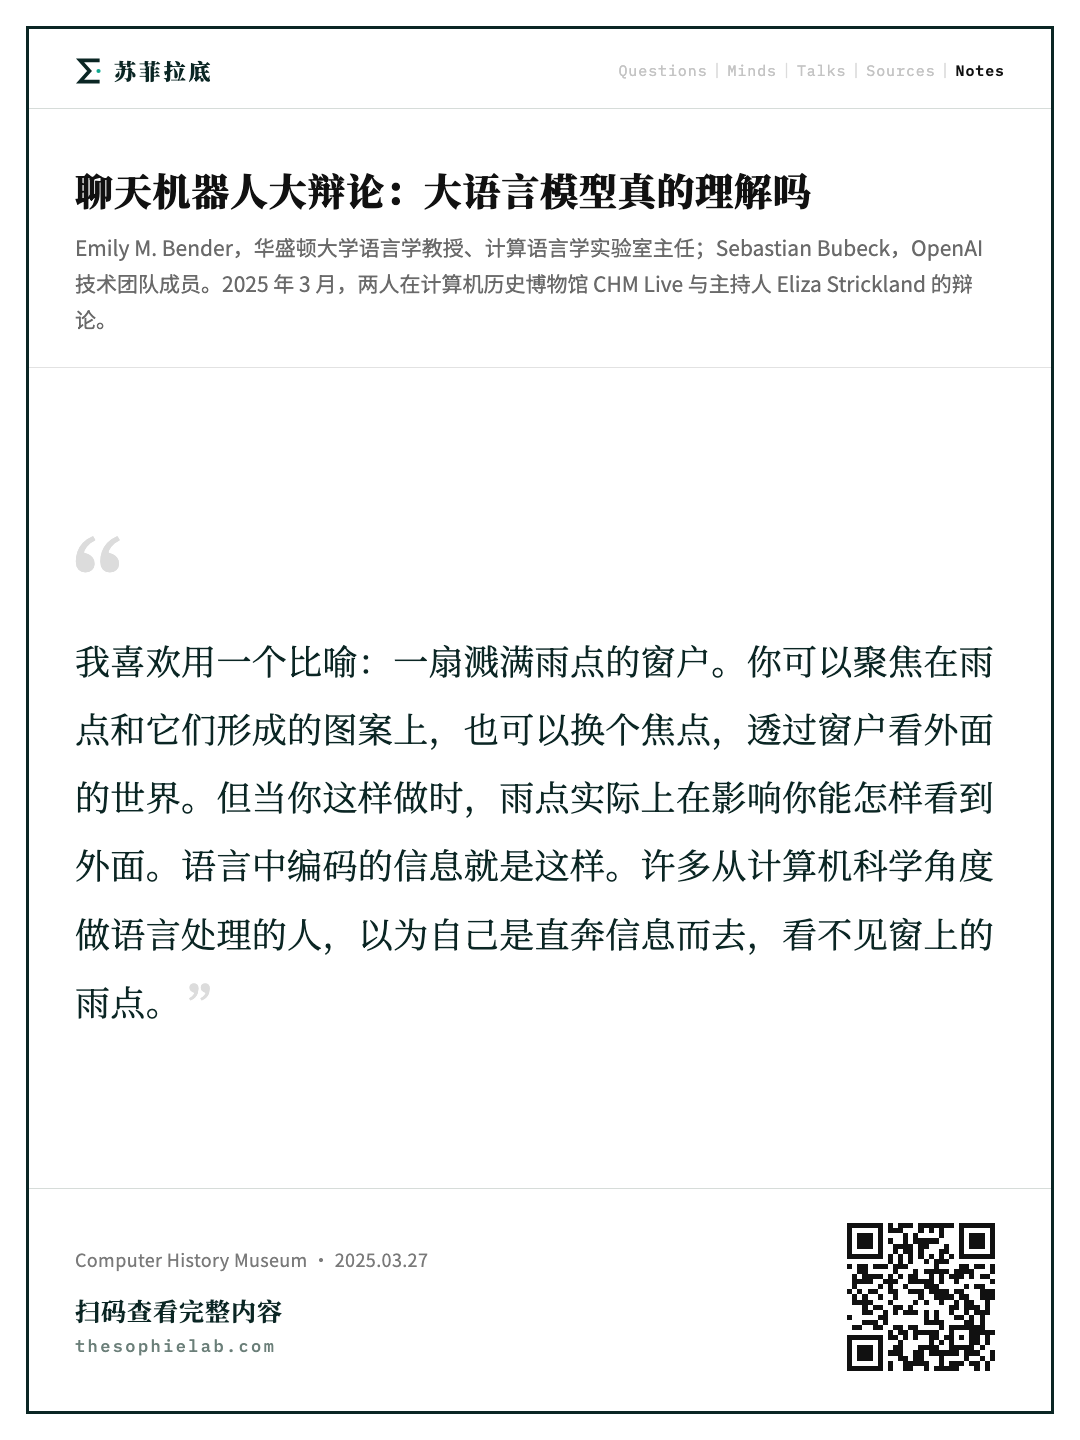
语言学还有一件极其重要的事:语言这一部分,与被谈论的世界或想象中的世界,并不是一回事。因为我来自西雅图,我喜欢用一个比喻:一扇溅满雨点的窗户。你可以聚焦在雨点和它们形成的图案上,也可以换个焦点,透过窗户看外面的世界。但当你这样做时,雨点实际上在影响你能怎样看到外面。语言中编码的信息就是这样。语言学家关注语言的结构,以及这种结构如何让我们看到其中的信息。而我注意到,许多从计算机科学角度做语言处理的人,以为自己是直奔信息而去,看不见窗上的雨点。所以「某个东西是否理解」这个问题非常重要,因为它让我们停下来评估,任何一个具体应用究竟是不是个好主意。
布贝克: 我想回应一下。我会强烈建议任何掌权者不要凭氛围做决策,那不是好主意,他们不该那么做,谁都不该。我同样会建议他们不要根据「这个系统是否理解」来做决策,哪怕有一个完美的理解定义,那也不是一条可行的路。在这种情况下,比如你说的机器人医生、机器人律师,我们必须做的是建立基准,建立测试。就像我们用考试来检验一个人是否有能力成为医生或律师、是否准备好了一样,我们也应该开始为 AI 系统建立这类测试,而这些测试的性质会与人类的考试大不相同。我很讨厌有人拿美国医师执照考试(USMLE)去测聊天机器人,那是胡闹,毫无意义。系统能通过 USMLE,并不等于你测出了它能当医生。这不合理,因为你对人有太多默认假设,比如假设他记得自己昨天做过什么,聊天机器人可不记得。所以你需要设计新的测试。而这正是我认为把人推离这个领域有些危险的地方:我们其实需要更多人来思考这个问题,我们需要建立这些测试,才能为大规模部署找到一条扎实的路径。
ARC 挑战与基准局限
斯特里克兰: 说到新测试和基准,我想听听两位对 ARC 挑战(ARC Prize)的看法。ARC 是「抽象与推理语料库」的缩写,旨在衡量通往通用人工智能的进展。它有意思的地方在于,题目对人来说并不太难,通常是一些彩色图案,图案的排布背后有某种逻辑,你得找出规律,再把它应用到另一张网格上。它的设计意图是挫败靠记忆的系统,真正考查抽象推理和泛化能力。第一版 ARC,我记得 OpenAI 的 o3 拿到了 87%,主办方差不多说「这一版完成了」。但他们今天刚推出新版,据说 o3 在上面只有大约 4%。这看起来至少是一个新的前沿。你们认为这类测试能评估理解吗?先从你开始。
布贝克: 这确实很有意思,让我先把故事讲一遍。有一个基准叫 ARC-AGI,它的创建者大致宣称,一旦有系统能解决它,那就是我们通往 AGI 之路上真正的里程碑,也许还不算 AGI,但会是一个重大里程碑。此前所有模型都卡在 30% 左右,人类大约在 80%。然后去年底 o3 来了,拿到 85%,直接碾压了这个基准。而且,不透露 o3 内部任何细节,我可以说这对这个基准是真正的泛化。这一发生,就又出现了移动球门的情形:「不对,那不是我们真正的意思,那不算真正的理解。」于是他们推出了 ARC-AGI-2,o3 在上面确实只有可怜的 4%。我得说我今天看了看,很多题我自己也解不出来,题目有点定义不清,也许他们会再打磨,我们会发现并非一切都完美。我认为这引向一个更大的问题,也回到我之前的观点:建立基准是一项艰难的任务,是真正的苦工。作为一个社会,为人类建立测试是一份全职工作,我们的整个教育体系就是围绕这个建立的。而我们必须为 AI 重新发明整套体系。所以在这一个例子上押太多,无论正面还是负面,都不太妥当。
斯特里克兰: 艾米丽,很想听你的看法。
本德: 关于基准我有很多话要说。我 2021 年和黛博拉·拉吉等同事发表过一篇论文,叫《AI 与「包罗万象」基准》,我们发现自然语言处理和图像处理领域某些基准的用法,与一本很棒的儿童读物《格罗弗与包罗万象博物馆》有绝妙的对应。故事里,格罗弗走进这座博物馆,有一间放又长又细的东西的屋子,一间放很重的东西的屋子,一间放怕痒的东西的屋子。他把这些屋子走遍,快到结尾时说:「嗯,我在这座博物馆里看了很多东西,可我还没看到世界上的一切。」然后有一扇门,门上的牌子写着「其他一切」。格罗弗推开门,当然就到了外面的世界。要点在于,任何给定的一组东西都只是一种选取,只是一个样本。自然语言处理的一个真正陷阱是,我们用语言谈论一切。所以当我们设计出能就任何话题输出貌似合理文本的合成文本挤出机时,就很容易觉得,哦,这东西也许真的擅长帮我解数学题,也许擅长根据我的症状做诊断,因为它能回给你看起来像你想要的那种文本。但根本没有办法测试完全的通用性。
而且我要说,那样做的意义何在?我们造技术时,要测的是功能。我们想知道自己造的系统在一定容差范围内运作良好。这里我想到蒂姆尼特·格布鲁博士关于「数据集说明书」的工作,她的灵感来自电子元件的规格书:这个元件会以 32000 赫兹振荡,误差正负一。这就是它的说明书,我们能把它钉死,从而知道在什么情况下用它。数据集说明书的理念是,我们对数据集里有什么也应该有类似的了解,这样对在这个数据集上训练的机器学习模型,我们才知道什么时候能用。而一旦谈到 AGI,谈到通用目的之类的东西,测试它就变得定义不清,作为目标也定义不清。所以我对 ARC 挑战的看法是:它不是通往通用人工智能进展的测试。据我了解,用 o3 跑的那次测试,也不是冷启动的「来,做这个」,而是「试试这个,这里有几个例子」,是少样本而非零样本。我不认为你能从它在那组谜题上的表现,有意义地泛化到任何别的东西。关于基准我还有最后一点:我们并不为人建立基准。我们设立执照考试,设立学业考试,看一个人把课程内容学得多好,为医学院做好了多少准备。但那不是给人做基准测试,不是在说这个人朝某项任务被开发到了什么程度。
布贝克: 郑重声明,你刚才说的我全都同意,绝对同意。也许只补充一小点:ARC-AGI 作为通用测试确实没有意义,这样的测试根本不存在。但这恰恰是要点。你说我们必须心里有一个功能形态,明确要把它部署到哪里,我非常赞成。我们不想要一个 AGI 跑来把所有事都解决了,我们想要的是把 AGI 部署在一个非常有限的场景里,比如辅助诊断,然后为这个有限场景开发一个基准,看它表现如何,能不能帮到医生,诸如此类。
本德: 那为什么不呢?当然可以有一个「根据症状做诊断」的基准,再为此专门构建系统,并公开训练数据。为什么不这样做?
布贝克: 因为另一种东西效果更好。这就是为什么不。
本德: 另一种东西对环境是毁灭性的,建立在窃取的数据上,建立在不公开的数据上,所以我们无法判断什么时候该用它。
布贝克: 这很难回应。
拟人化报道与「开放」
斯特里克兰: 我换个角度。这些是计算机科学家和计算语言学家之间的争论。但请从另一个视角想想,一个只是想跟上技术动向的普通人。他们看到的是这样的标题:上周《纽约时报》有一篇《数字治疗师也会有压力》,报道一项研究发现,当用户向 ChatGPT 讲述创伤经历时,它表现出焦虑的迹象,而做了一次正念练习之后焦虑水平下降了。可以想见,人们会因此产生印象,觉得那边有一个真实的心智,甚至在受苦,在这个例子里还相当悲惨。让人们相信这项技术的另一端有一个心智,有危险吗?艾米丽,先从你开始。
本德: 有。因为如果你告诉人们,这东西有答案,它能当你的治疗师,能让你好受些,能帮你诊断,能帮你处理法律麻烦,而且顺便说一句,它超级聪明,用我们从互联网上刮下来的一切训练过,它无所不知,还很客观。那么,我们就没有为人们做出好的决定创造条件。至于该拿这种新闻怎么办,我给公众的建议是:如果一个记者在拟人化,尤其是拟人化得这么厉害,跳过。你不需要读它。
布贝克: 对,这不是一篇好论文。但是,这些「但是」很重要,因为这是一个非常微妙、非常精细的话题。任何斩钉截铁的论断,「我们应该完全无视它」「它绝对不该用于某某」,我都会保持警惕。就这篇论文而言,是的,不太好。但它可能对 AI 研究者有点用,不是对公众,而是对研究者:它关乎如何提示模型,以及能否通过把模型置于「正确的心态」(打引号)来引出好的行为。虽然那里并没有心智,这一点要说清楚,但我不知道还能用什么别的语言。这也正是问题所在:我们需要在这个方向做更多工作,发展出谈论这些东西的正确词汇。我也不喜欢「人工智能」这个词,它是别的东西。它是智能,它是理解,但方式与人类不同,需要有一套自己的词汇。也许要花几十年才能发展出这个新的研究领域。而全部的难处在于,我们没有几十年。一个世纪前发展量子力学时,物理学家们做出了那么多精彩的发现,他们可以花十年、二十年,事实上量子场论花了五十多年。要点是他们有时间。今天我们没有时间,因为进步太快了。所以这整场对话也必须扎根于我之前说的那个现实:两年前,机器能解一道高中题就让我惊叹,而今天它们在角逐数学奥赛金牌。这一点必须是我们说的每一句话的背景。
本德: 那次是不是允许它提交一万个答案,然后……
布贝克: 那是谷歌,他们的做法不对。OpenAI 不是那样做的。
本德: 好吧。但 OpenAI 对自己在做什么根本不开放。我们不知道那些题目在不在训练数据里,或者非常相似的题目在不在。
布贝克: 每周有四亿人在用它,所以其实相当开放。
本德: 不。开放意味着我们知道训练数据是什么。开放意味着我们知道步骤是什么。开放意味着我们知道系统提示是什么。开放意味着我们知道你们的碳足迹是多少。那才叫开放。
布贝克: 我想萨姆(Sam Altman)暗示过,在开源和开放获取方面,我们也许没有站在历史正确的一边。所以也许很快会有这个方向的消息。
什么能让你认错
斯特里克兰: 马上就要进入观众提问,但在此之前我想问两位一个问题:要看到什么样的行为或证据,才能让你相信自己站错了边?
本德: 我需要一个非常清晰的理解定义。我需要一个实验,其所有参数都已知且公开,训练数据的每一个细节都公开,这样我们才能推理:给定这些训练数据、这个输入、这个训练架构、这个系统提示,要得到这个输出,除非有某个东西把它与理解的定义连起来,否则不可能。
布贝克: 对我来说,这非常具体。过去十五到二十年我都在做数学研究,读论文时有过许多极其快乐的时刻,从某篇论文里获得一种全新的、深刻的理解。如果十年后,或者干脆到我生命尽头,我不在乎十年不十年,但如果在我有生之年,我从未从一个 AI 系统那里获得过那样的时刻,像读另一个人也许花了数年写成的论文时那样深刻的领悟,那么,是的,我错了。
观众提问:预测下一个词
斯特里克兰: 我来读几个观众问题,有很多非常有意思、很有挑战性的。很多人好奇我们如何区分人类的理解。比如有人问:对世界的统计表征,与人类理解世界的方式有何不同?还有人问:我们做的不就是同一件事吗?我们思考的时候,不也只是在预测下一个词元(token)吗?
本德: 我想直接回应「我们不也只是在预测下一个词元」这一点。这是一个本质上去人性化的论点。它等于说,你不认为我真的有内心生活。如果你不认为我有内心生活,我不想和你进行这场对话。
布贝克: 我的看法有点类似,但我把它反过来。我不了解你是怎么运作的,你说话、传递给我理解和意义的时候,我不想对你的内部运作做任何假设。对 AI 系统也一样,我不在乎它内部是怎么运作的,那不是我的事。当然某种意义上是我的事,但就它是否理解这个问题而言不是。它在做某件事,它给了我内容,然后我自己判断这内容有没有用。
具身、多模态与文本
斯特里克兰: 另一个问题:理解和知识在多大程度上需要某种物理性?比方说,我的朋友告诉我怎么打匹克球,把所有规则和指导都讲给我,告诉我打匹克球是什么感觉,我还看了打匹克球的视频。我真的会打匹克球了吗?我理解它了吗?还是必须亲自下场,才能找到感觉?
本德: 在语言学和哲学里,这个问题有时被表述为:理解是否必须是具身的?要真正认识世界、真正学会一门语言,是否必须有身体经验?我认为具身很重要,但更重要的是处于社会情境中的关系性经验。意义真正存在于我们与他人的关系之中。如果你深入社会语言学和语言变迁的细节,会发现词语的意思一直在随我们的用法变化。这之所以发生,是因为我们成功地把词语当作小小的记号、当作线索来传达想说的东西,而这又为下一次使用这条线索时的词语着了色。所以说到底,一切都在与他人的关系里。而大语言模型根本做不到这一点。我们和它说话时可以完成自己这一半,人们也确实会产生依恋,但那全在人这一边。对一个并不存在的东西产生强烈依恋,是多么孤独。
布贝克: 我把这个问题理解为:多模态对于通用智能是否必要?我认为这是一个前沿研究问题,没有人真正知道答案。当然,这些术语没有一个是定义清楚的,但即便如此,我们也确实不知道。我个人相信,完全不需要。你可以纯粹通过文本、纯粹通过数字化地访问互联网,达到我此前讨论的那种意义上的通用智能。你不需要任何物理性,不需要看到任何东西,不需要听到任何东西,纯粹从思想和推理就能获得智能。这是我的信念,但它还没有被证实。
再补充一点:文本没有什么特别的。文本有用,只是因为它量大而且容易处理。视频和图像也有海量,只是处理起来更麻烦。技术本身对模态是完全不加区分的,可以用于视觉,可以用于音频。事实上 ChatGPT 现在能看、能听,你可以打开摄像头和它互动,会很有趣,我的孩子们就这样玩得很开心。
斯特里克兰: 有个相关的问题:你们认为 AGI(或者 AI,我不确定提问者的意思)离开人类语言,在另一种基础上,会不会更好地理解世界?
布贝克: 不会。我认为人类语言非常美妙,它的信息密度极高。在图像里,在其他模态里,有太多重复,即便音频也极其重复,也许我说的话就很重复,但在文本里,这类重复少得多。所以我实际上认为文本是必要的。换个说法:如果你想只靠在世界里互动来获得通用智能,那我看不出除了在地球上进化几十亿年、然后我们就在这儿了之外,还有什么别的办法。
本德: 这个问题同样受制于 AGI 未经定义。但我想反驳「文本没什么特别」这个说法。文本非常特别,里面有很多东西。
布贝克: 我也爱文本。我说的是,从技术的角度它不特别。
本德: 所以,如果你的视角是「它只是数据,我用神经网络这样那样地碾一遍」,那它不特别。但我认为它特别,因为文本是语言的映现,而语言是我们建构社会世界的方式,是我们彼此互动的方式,是我们进行某种事实上的心灵感应、进入另一个人心智的方式。如果现在有系统把合成文本推到我们面前,倾倒进我们的信息生态,那是个巨大的问题,因为文本是特别的。
财富、权力与涌现
斯特里克兰: 这是得票最高的问题,我必须问:财富和权力在「谁来裁定大语言模型是否理解」这件事上扮演什么角色?
本德: 难题。谁来裁定?你们每个人都可以自己做决定,这正是今晚这类活动的意义。但就政治话语的走向而言,谁在裁定?我们是否在基于「大语言模型能理解」的假设制定政策?如果是,那财富和权力就深深卷入其中。更进一步,围绕开发这些东西的政治经济,正在进一步集中财富和权力。数据变成了权力。我想指出,你刚才说你那个问题只在你自己的 Dropbox 里。Dropbox 是不是和 OpenAI 签了协议的公司之一?
布贝克: 我不认为我的 Dropbox 被发给了 OpenAI。
本德: 我不知道,因为你们不告诉我们数据里有什么。
布贝克: 好吧。谁来裁定?你们裁定,这肯定是正确答案。我想我们也得承认,我们生活在一个由资本主义社会运转的世界里,大家都想领先,想更快更好地造东西。说到底,这些是工具,它们就是工具。如果它们让你更有生产力,让你更快实现想法,让你用更短的时间完成工作,那它们就会以这种方式扩散开来。所以这个决定是分布式的,没有哪一个单一实体来做决定。
斯特里克兰: 也许这是最后一个问题,然后进入结辩。关于涌现(emergence):当一个复杂实体拥有其组成部分各自不具备的属性或行为时,就发生了涌现。两位怎么看这个概念?人类意义上的理解,会不会是可以涌现出来的东西?
本德: 当我谈理解时,我说的是对语言的理解。它是否在人类进化的某个时刻涌现出来了?显然是的,因为我们在某个时刻从没有语言的生物变成了有语言的生物,理解语言的能力涌现了。但说到机器学习系统的涌现行为,我再说一次,除非你能完全开放地访问训练数据,否则这些主张是不科学的。而且我们必须小心,我们是如何把输入输出对解读成问答对的,还要把它与其他可能从那个输入走到那个输出的计算方式做比较,然后才能提出「涌现行为」这样非同寻常的主张。
布贝克: 不,我认为涌现绝对是真实的。老实说,我很难理解这怎么会有争议。我也要反驳「必须知道系统的每一个细节才能判断是否有涌现」这一点,理由是你可以自己做实验。在投身构建大语言模型之前,我自己就在神经网络上做实验,独自搭建玩具设定,只用自己的电脑,就能创造出看到涌现现象的场景。为了让大家在同一页上,举一个我看过的例子:训练一个模型解线性方程组。还记得中学时那种题吧,x 加 y 等于多少,x 减 y 等于多少,求 x 和 y。你能看到这样的设定:系统只从少量方程的方程组中学习,突然就能解很多方程的方程组。这就是你在实验室里亲眼能看到的涌现,你不需要接触最好的模型。
结辩
斯特里克兰: 好,请两位做三分钟左右的结辩。艾米丽,你先开始的,就先请你。
本德: 今晚我想留给大家什么?我想留给大家这样一个想法:没有什么是不可避免的。如果有人说「这东西来了就不会走,我们必须学会与它共存」,你可以说不。拒绝非常重要。这在我们那些已经吱吱作响、并且即将响得更厉害的系统里尤其重要:教育、医疗、司法、移民程序。在所有这些地方,合成文本看起来像一块方便的创可贴,一个速效方案,因为老师不够、治疗师不够,诸如此类。我们需要对此说不,因为它其实比什么都不做更糟。而说不,我认为要从拒绝开始:它不只是一个好玩的玩具,它不是一个好的搜索工具。任何时候有人说「来,用这个,这是人工智能」(这里我打引号),记住,你后口袋里揣着一个「不」。我就说到这里。
布贝克: 我的看法很不一样。总的来说,我认为由你们自己决定,而我反对恐吓策略,反对说「这很可怕,这只会带来坏事」。我们都足够聪明,在和这些工具互动、使用它们时,能自己判断它们是否带来价值。这是第一点。
第二点,我想回到一件我本以为会在讨论中更多出现的事,伊莱莎开头提到的那些谜题:稍微改一点,答案就全错了。这回到我一直想说的观点:这些话题复杂而且相当微妙,我认为鹦鹉和火花里都有真相,两者兼而有之。在某些话题上它们更像鹦鹉,在某些话题上则多一点火花。我看到的是,GPT-3 时代也许更偏鹦鹉,GPT-4 也许更偏火花,我看到天平在移动。但两种模式肯定都还在。所以这是一个非常非常复杂的话题。
说了这么多,眼下确实有一股浪潮,越来越多的人在与这些模型互动,并意识到它们有多强大。有一件事让我很受启发:萨姆在推特上发了我们最新模型写的一篇小说,就发了那么一条,然后一些知名作家、创意写作者表示,他们被那个故事打动了。当然,我知道你要说什么,你只可能被另一个人写的东西打动,等等。可以。但这个人,一位知名作家,说自己被打动了。所以我认为这股浪潮在持续上涨。它会涨到多高?没人知道。如果有人告诉你他知道,也许你不该太听他的。但我们能看到速度,这个速度令人惊叹。我肯定属于那个阵营:非常期待看到未来几年会带来什么。
现场投票
斯特里克兰: 让我们感谢两位辩手。我真的想不出还有谁更适合来呈现这两种观点。大家还记得 Slido 投票吧,开场时请大家投过一次。现在是辩后投票,请拿出手机,告诉我们你现在怎么想,指针有没有移动。有请戴维回到台上做总结。
主持人: 非常感谢各位。回到开场时的数据,「否」一开始是 64%,现在又上升了。不过看,就在我走上台的这会儿,「是」的一方还在投票。我得说,这相当令人印象深刻。开场时「是」占 22%。现在似乎又在往回走。所以我不知道,算是平手吗?如果没有人改变主意,那也说明了点什么。请为我们的主持人和两位讲者热烈鼓掌。我们很快得再办一场别的题目的辩论,今晚太精彩了,现场能量十足,YouTube 聊天室里也一样热烈。感谢所有参与的线上观众,再次感谢两位讲者,感谢各位。晚安。
一句话概括
计算机历史博物馆与 IEEE Spectrum 合办的辩论中,语言学家 Emily Bender 主张大语言模型只是在形式层面预测下一个词、根本接触不到意义,OpenAI 的 Sebastian Bubeck 则主张"理解"无法严格定义、应以模型的实际效用和进步速率来衡量,双方各执一词,现场投票在辩论前后几乎没有移动。
核心要点
- Bender 的核心论证是"形式—意义鸿沟":她在 2020 年"章鱼论文"中把理解定义为从语言形式(声音、字符)映射到语言之外的事物。语言模型从香农和马尔可夫时代的 n-gram、T9 输入法一路演进到今天,始终只处理词的形式和共现分布,从未获得"所指"这一侧的信息;没有意义就没有理解。她用日语例句演示:不懂日语的人无法从词本身获得任何东西,但能从手势、目光和现场情境推断,而模型恰恰没有这些。
- 现代 LLM 与传统语言模型的差异被归结为两大两小:两大差异是新架构能吃下海量(且来源不透明、未经同意收集的)训练数据,以及系统被"翻转"——从给候选字符串排序变成反复回答"下一个可能是什么词"。两小差异是 RLHF(数据工人打分塑造输出偏好)和输入输出之间的额外处理(计算器转发、检索增强生成、隐藏的系统提示)。
- "看起来理解"是人类自己投射出来的:Bender 引用语用学和心理语言学研究指出,人类理解语言时并非从词里"解包"意义,而是不断推测说话者想传达什么,为此必须想象一个背后的心灵。面对合成文本我们会反射性地做同样的事,"那个心灵完全是我们自己编出来的"。她因此全程拒用拟人化措辞,"AI"一词永远加引号。
- Bubeck 的策略是承认"理解"不可定义,转而用进步速率说话:他举了 MATH 基准(两年半前模型约 20%,去年初已饱和)、MMLU(曾左右股市、如今无人再提)、FrontierMath(发布时 o1 得 4%,一个月后 o3-mini 达 30%,"可能没有任何一个人类能独自做到 30%")以及 ARC-AGI(o3 得 85%,超过人类约 80%)。他的结论:理解是连续量而非 0/1,且"在旁观者眼中"——哈佛物理教授甚至会说"爱因斯坦显然不理解广义相对论"。
- Bubeck 给出的关键个人证据是一个不在网上的研究问题:他把自己 Dropbox 里一篇从未发表的数学优化论文中的问题问 o3-mini,模型没有解出来,但在 2 分钟推理后提出了一个与另一领域的联系,而这个联系他本人当年花了 3 天才发现。他说自己不在乎这算不算"理解",但它确实加速了他的工作。Bender 立即反击:Dropbox 是否与 OpenAI 有数据交易?"你不告诉我们训练数据里有什么,所以我不知道。"
- 双方在"基准测试无法证明理解"上罕见地一致,但推论相反:Bender 用《Grover 与世界万物博物馆》比喻——任何基准都只是采样,而语言能谈论一切,所以"通用"能力不可测试,且 AGI 未定义则不成为科学目标;她主张按 Gebru 的"数据集数据表"思路做限定用途、训练数据公开的专用系统。Bubeck 完全同意要按具体部署场景(如辅助诊断)建专用测试,且批评拿 USMLE 考聊天机器人"毫无意义",但认为通用模型"就是效果更好"。Bender 回应:更好的代价是环境破坏、盗用数据和不透明。
- 关于 AAAI 调查的 76% 研究者不看好"扩大规模通向 AGI":Bubeck 认为学术界恰恰是最慢理解正在发生什么的群体,因为 LLM 违背了此前所有的神经网络理论直觉;同时他承认纯预训练确实不能通向 AGI,推理模型是沿另一条轴扩展。Bender 认为该问题本身就是坏问卷——AGI 没有定义,且"我们是否在通往 AGI 的正确道路上"预设了一个未被证明存在的终点,科学不是选一条路往下跑。
- 什么能让各自认输:Bender 要求一个清晰、可证伪、基于人类语言理解研究的定义,加上训练数据、架构、系统提示全部公开的可复现实验。Bubeck 的标准非常个人化:如果在他有生之年,从未从 AI 系统那里获得像读一篇人类花数年写成的数学论文那样深刻的顿悟时刻,那他就错了。
- "人类不也是在预测下一个 token 吗"被 Bender 拒绝讨论:她称这是一种去人性化论证,等于否认她有内心生活。Bubeck 反过来说他也不假设人脑如何运作,"它内部怎么工作不关我的事,它给我内容,我自己判断有没有用"。关于具身性,Bender 认为比身体更关键的是社会关系——词义在人与人的使用中持续变化,模型根本无法参与这种关系;Bubeck 则相信纯文本、不需要任何感官就能达到通用智能,并认为文本信息密度远高于图像和音频。
- 关于"涌现"的分歧最直接:Bender 称在训练数据不公开的情况下任何涌现声明都不科学,还要先排除其他可能的计算路径。Bubeck 说他不理解这怎么会有争议——他自己在个人电脑上训练模型解线性方程组,只用少量方程训练,模型突然能解多方程系统,"这是你自己在实验室里就能看到的现象"。
结论与值得注意的细节
- 现场 Slido 投票辩论前约 64% 选"不理解"、22% 选"理解",辩论后主持人上台时数字来回跳动,最终被判为"基本没人改变立场"。
- 主持人 Eliza Strickland 开场用"人和山羊过河"实验做了演示:GPT 版本在没有狼和白菜的简化题上仍生搬硬套原谜题步骤、让人把船留在对岸,而 OpenAI 推理模型直接答"两个一起上船过去就完了"。Bubeck 在结语中主动回应这一点,承认"鹦鹉和火花都真实存在",模型在某些话题上更像鹦鹉、某些上更像火花,从 GPT-3 到 GPT-4 平衡在移动。
- 一个耐人寻味的悖论由 Bubeck 自己提出:他预测几年内模型可能证明人类未能证明的定理,但数学界会(且他认为应当)拒绝承认"理解"了该定理,直到有人类能完整把握证明——"理解也许终究是人类的旅程"。Bender 借此强调"所有学术都是对话,独自做到自己满意不算科学"。
- Bender 批评 Google 的奥数成绩靠提交上万个答案;Bubeck 称 OpenAI 不这么做,但随即被追问 OpenAI 并不"开放"。他以"4 亿周活用户"回应,Bender 明确列出"开放"的标准:训练数据、步骤、系统提示、碳足迹全部可知。Bubeck 顺带提到 Sam Altman 承认公司在开源问题上"可能站在了历史错误的一边"。
- 关于《纽约时报》"数字治疗师也会焦虑"的报道,两人都认为论文不好,但 Bender 建议公众看到重度拟人化报道直接跳过,Bubeck 则认为其中关于提示词如何影响模型表现的部分对研究者仍有价值,并坦言目前缺乏描述这类系统的词汇,"以前物理学家有几十年发展量子场论,我们现在没有几十年"。
- 两人的结语立场鲜明:Bender 的核心信息是"没有什么是不可避免的,你口袋里永远有一个'不'",尤其针对教育、医疗、法律、移民等系统里用合成文本填补人手短缺的做法,她认为"比什么都不做更糟"。Bubeck 反对"恐吓策略",主张每个人在使用中自行判断价值,并以知名作家被新模型写的小说打动为例说明浪潮仍在上涨,"如果有人说他知道会涨多高,你大概不该太听他的"。

追问一个大问题。 苏菲拉底的每周来信,写这一周在追问的问题和看到的回应。
 微信公众号