
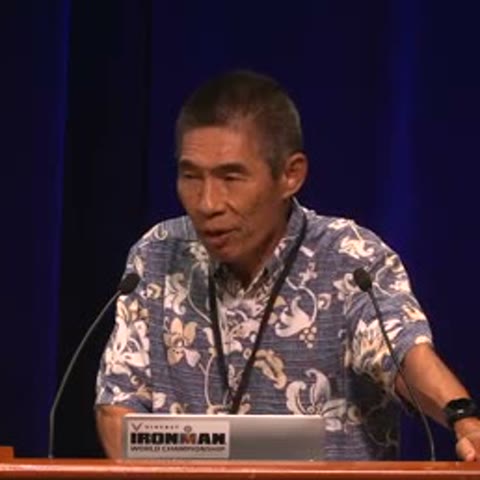
2026 年认知计算神经科学大会(CCN 2026)的一场主题演讲,讲者是冲绳科学技术大学院大学(OIST)神经计算单元教授铜谷贤治(Kenji Doya)。他以强化学习为主线,从四十年前自己做的会走路的小机器人讲起,一路谈到基底神经节、血清素、心理模拟、推断与控制的对偶性,以及人工智能该向大脑学什么。演讲之后有两位听众提问。本文依据现场录音编译整理。
主持人引介
主持人:欢迎大家回来,这又是一场令人期待的主题演讲。我很荣幸为大家介绍铜谷贤治教授,冲绳科学技术大学院大学神经计算单元的教授。铜谷教授研究强化学习与概率推断,以及大脑如何实现这两种计算。如果你曾经把某种神经调质(neuromodulator)看成学习算法里的一个参数,那你就是在他的思想下游工作:多巴胺对应奖赏预测误差,血清素对应折扣因子,去甲肾上腺素对应探索,诸如此类。
铜谷教授在东京大学取得博士学位,随后去了加州大学圣迭戈分校和索尔克研究所,跟随特伦斯·谢诺夫斯基(Terry Sejnowski)研究鸟鸣的强化学习模型。他 1994 年加入 ATR(国际电气通信基础技术研究所),2004 年起任职于冲绳科学技术大学院大学。他获得过许多荣誉,其中包括国际神经网络学会的唐纳德·赫布奖。他还在 2024 年完赛了科纳的铁人三项世界锦标赛,这说明他对长时程(long horizon)的耐受力并不只停留在理论层面。今天他演讲的题目是「预测与行动的神经回路」。请大家和我一起欢迎铜谷贤治教授。
冲绳与跨学科实验室
铜谷:谢谢主持人热情的介绍,也感谢会议组织者邀请我来做这场主题演讲。我预告的题目是「预测与行动的神经回路」,不过今天我会讲得比这个题目宽一些。先让我介绍一下我的大学和我的实验室。
我所在的大学是冲绳科学技术大学院大学。诸位知道冲绳在哪里吗?它在大海中央,从东京飞过去大约两个半小时,但从东亚的许多城市都有方便的航班。我们希望来到这里的不只是游客,而是各国的学生和研究者,能在这里一起做国际化的研究。
我的实验室是 OIST 最早成立的几个实验室之一。我一直想把它办成一个跨学科的地方。一方面,我们研究如何创造灵活的学习系统;另一方面,我们想理解大脑的学习机制。所以我们既做机器人和机器学习,也做神经生物学实验,实验对象主要是大鼠和小鼠。但这两边并不是各干各的,我们研究的共同主题是强化学习(reinforcement learning)。
大家都知道,强化学习是这样一个框架:一个智能体,可以是人、动物、软件或机器人,与环境交互,并得到奖赏反馈,这个反馈评价它表现得有多好。强化学习的目标是找到能使所得奖赏最大化的行动策略。如今,为强化学习设计高效算法是计算机科学和人工智能领域一个非常重要的课题;而理解大脑实现强化学习的机制,恐怕也是神经科学里一个非常重要的课题。一旦某一边取得进展,可能就会给另一边提示;如果某一边撞了墙,也可能为另一边提出一个理论或实验上的问题设定。这就是我们为什么同时推进这两条研究线。
今天我会从强化学习讲起,再讲与之相关的心理模拟(mental simulation),然后讲推断与控制,或者说预测与行动,最后谈谈人工智能与神经科学。
会走路的机器人与我的猫
铜谷:先说强化学习。我在这上面其实已经干了四十多年。这是我本科毕业论文的项目:做一个能学会走路的小机器人。它很小,大概十厘米长。那时候还没有关于强化学习或机器人学习的教科书。不过我想明白了一点:只要把运动模式用数值表示出来,再把这个模式朝着改进的方向稍微改动一点,也许就能学会各种不同的运动模式。事实上,用一个非常简单的算法,在当时的八位个人电脑上控制,这个机器人就能发现许多动态的行为。这里的关键是一个旋转编码器,它监测运动的速度。它就相当于这个机器人学习时的奖赏信号。
这是我的起点。同时我也对动物的强化学习感兴趣。这是我现在养的猫。她很可爱,但也很野。她不知从什么时候起学会了摇晃这个喂食器,有时候就能得到食物。这大概不是遗传上预先决定的行为,我也从来没有教过她,可她不知怎么就发现了用这种方式可以拿到奖赏。最近许多强化学习的论文,横轴都是以百万次试验计的。而她只是偶尔碰上几次,经验的次数相对很少,就能学会这样的行为。这是怎么做到的?这对我来说是一个非常重要的研究动机。
强化学习的核心计算
铜谷:强化学习里有几项重要的计算。第一项是对未来奖赏的预测,其形式就是所谓的价值函数(value function)。V(s) 叫状态价值函数,Q(s,a) 叫动作价值函数,它们分别表示从某个状态出发、或者执行某个特定动作之后,未来奖赏的期望。这里的 γ 叫时间折扣参数(temporal discounting parameter),它决定你在预测时把未来看到多远。
这样的奖赏预测可以用来指导行为。最简单的动作选择叫贪心(greedy),就是找出能使当前状态下期望奖赏最大的那个动作。而在训练早期,你会采用随机搜索。这时可以把动作价值函数看成一种负的势能,而这里的 β 叫逆温度(inverse temperature),它控制你的动作选择有多确定或多随机。
选择动作之后,你要从经验中学习。学习依据的是奖赏预测误差(reward prediction error)。多亏了指数折扣这个框架,我们有一个一致性方程:你在行动之前预测的奖赏,应当等于你实际获得的奖赏,加上从后续状态出发仍然期望得到的奖赏再乘以 γ。如果你的预测是完美的,前两项与最后一项应当相互抵消;否则,你就从这个预测误差中学习。你按照这个时序差分(temporal difference)误差的比例,更新前一个状态的价值函数或前一个动作的价值函数。这里的 α 是学习率参数,控制你学得有多快,或者说忘得有多快。
预测、选择、学习,这几个步骤如何实现,是强化学习实现中的一个非常重要的课题。比如最近,把深度神经网络恰当地用于价值函数的近似,就带来了人工智能强化学习领域的重大突破。同样重要的是这些参数怎么设定:时间折扣、探索与利用的权衡、学习的稳定性和速度。如何调这些参数,也是强化学习实际应用中的一个非常重要的课题。
这些在工程应用中很重要,但我认为它们在神经科学里同样重要。我们的大脑也许不是在用一模一样的方程,但预测未来奖赏、据此选择动作、再从实际经验中学习,这些是我们的大脑必定在做的事。这样的计算如何用大脑的回路完成,又可能动用了大脑里的哪些分子?这是神经科学中一个非常重要的课题,也是我们一直在并行推进的方向。
站立机器人与参数的陷阱
铜谷:这是强化学习的另一个例子:学习站起来。有人想让机器人去照顾老人或病人。可你要是走进机器人实验室,常常会看到两三个研究生在照顾一台机器人。所以我们觉得,机器人得足够皮实,能自己摔倒再自己站起来。这个机器人大约七十厘米高,膝部和髋部各有一个马达,还有一个陀螺仪传感器,能分辨自己是躺着还是站着。我们根据头部离地面的高度给它奖赏,摔倒时给它负的奖赏,也就是惩罚。经过几百次磕磕绊绊的摔倒之后,机器人学会了这样一套站起来的动作序列。这里重要的一点是:一开始机器人的头一直贴在地上,即时奖赏是零,但只要把重心压到脚上,它随后就能站起来。这是延迟奖赏任务的一个非常简单的例子。
强化学习的一个好处,就是它能解决延迟奖赏问题,或者说时间信用分配(temporal credit assignment)问题。但要做到这一点,有几个因素非常重要。比如时间折扣参数就很关键。如果你把 γ 设得很小,机器人有时候就只是坐起来,马上拿一点小奖赏了事,这不是我们想要的。奖赏与惩罚之间的平衡也很重要。如果惩罚设得太大,有些情况下机器人干脆学会一直躺着,以躲开任何惩罚,这也不是我们想要的。所以,尽管强化学习算法在合理的条件下已被证明会收敛,但取决于参数的设定,取决于奖赏的设计,有时候结果并不是你所期望的。强化学习里这种更高层面的问题非常重要,而这是我们试着让机器人学习的过程中学到的。
基底神经节假说与纹状体
铜谷:接下来说强化学习在大脑中的实现。和许多人一样,我们猜想藏在大脑皮层之下的基底神经节(basal ganglia)扮演着非常重要的角色。基底神经节接收来自皮层的主要输入,然后经过一连串的核团,从纹状体(striatum)到苍白球,再输出经丘脑回到皮层。基底神经节的一个重要特征,是它接收来自黑质的强烈的多巴胺能输入。这是从工程角度看这个回路。
一个非常重要的发现是:向基底神经节投射的多巴胺神经元,具有类似时序差分误差的活动,这是沃尔弗拉姆·舒尔茨(Wolfram Schultz)发现的。另外,纹状体中的多巴胺与皮层到纹状体的输入的可塑性有关,这就是所谓多巴胺依赖的可塑性,由我在 OIST 的同事杰夫·威肯斯(Jeff Wickens)发现。基于这些发现,人们开始认为基底神经节在强化学习中扮演非常重要的角色。我们的具体假说是:纹状体里的一部分神经元可能学习动作价值函数,随后用于动作选择;另一部分神经元表征状态价值函数,用于时序差分误差的计算。
我在 OIST 建实验室时,有机会新建一个啮齿类动物实验室,于是我们就着手做实验。这是一个二元选择任务:大鼠把鼻子探进中央的孔之后,可以选择去右边的孔或左边的孔,然后根据它的选择,以某个概率给它食物,而这个概率一直在变。所以大鼠必须持续追踪左边的孔有多好、右边的孔有多好,也就是左动作和右动作的动作价值。我们把动物的选择行为拟合到强化学习模型上,估计出选择序列背后的动作价值函数,再去检查有没有神经元的活动像这样变化。确实,有些神经元在大约两百次试验里的活动变化与这个动作价值函数非常相似。所以我们提出,这些神经元参与了左选择的动作价值,另一些神经元追踪右选择的好坏,这两类神经元可能通过某种竞争完成动作选择。我们还发现,纹状体的不同部位分别参与动作价值函数、状态价值函数和具体的运动。
当时我们还没有区分纹状体中的细胞类型,但近年来已经可以从特定类型的神经元记录了。这是一个钙成像实验,我们在向黑质多巴胺神经元投射的那些神经元里表达钙指示剂。在经典条件反射任务中,我们看到,一旦提示音与奖赏的发放建立了关联,这些神经元就开始对即将到来的奖赏产生反应。这与这些神经元编码状态价值函数的假说是一致的。
血清素与时间折扣
铜谷:再说强化学习参数的调节。多巴胺编码强化学习中最重要的信号,也就是时序差分误差,这一点已经得到充分支持。于是我们开始推测,其他从脑干投射到大脑广大区域的神经调质,可能调节强化学习的全局参数。我们尤其一直在研究血清素(serotonin)的功能。
基于血清素可能控制时间折扣参数这个假说,我们做了记录实验,近年来又做了对血清素神经元的光遗传学操控。这是一只基因工程小鼠,它只在产生血清素的神经元里表达通道视紫红质,也就是对光敏感的离子通道。通过光纤照射蓝光,我们就能选择性地刺激血清素神经元;黄光则是一种对照条件。
小鼠要等待食物颗粒,延迟分别是三秒、六秒、九秒,或者无限长。在九秒延迟的条件下,小鼠常常放弃等待,但蓝光刺激血清素神经元之后,这种放弃的错误减少了。在无限长延迟的试验里,小鼠通常在十秒左右放弃,但蓝光刺激血清素神经元后,它们能等得久得多。也就是说,动物变得更有耐心了,或者说对延迟奖赏更有动力了。这与血清素调节时间折扣参数的假说是一致的。
我们对大脑中强化学习机制的理解逐渐加深,但仍有许多未解的问题。比如基底神经节的回路相当复杂,有所谓直接通路和间接通路。为什么需要这些平行通路,以及多重的整合机制,仍是没有解决的问题。多巴胺神经元具有类似时序差分误差的活动,这已经是定论,但什么样的回路机制产生了这种类时序差分的反应,仍然不太清楚。而且,基底神经节可能不是大脑中唯一做强化学习的地方,杏仁核、海马、小脑等其他机制也可能参与其中。这些不同脑区在强化学习中的功能有何异同,是我们应当进一步研究的非常重要的课题。
无模型与有模型
铜谷:下一个话题是心理模拟,它仍然与强化学习有关。我刚才讲的那种强化学习框架叫无模型(model-free)强化学习。这个框架假定智能体对世界一无所知,只是根据「状态、动作、奖赏,状态、动作、奖赏」这样的经验序列来学习行为。这是一种反应式的简单过程,算法非常简单,但往往需要大量重复。
而在有模型(model-based)的方法中,智能体学习一个预测模型,也就是环境的状态如何随动作而改变。有了这样的预测模型,我们就能根据前一个状态和动作估计当前状态,也能提前规划出到达目标状态的合适动作序列。这是一种更深思熟虑的策略,尤其当行为的目标改变时,它能让智能体更灵活地适应新的设定。但内部计算可能很重。所以,如何在无模型与有模型之间选择,或者把两者结合起来,是机器学习和神经科学里都很有意思的课题。
这是有模型强化学习的一个例子:一个用智能手机做的机器人。它一开始做的是这种随机的动作,在这个过程中学会自己的身体如何响应轮子的运动,然后用这个内部模型离线地优化控制策略。结果,不到十次试验,这个机器人就能弹起来并保持平衡。这是我以前的博士生帕沃(Paavo)的工作,是有模型策略数据效率的一个例子。另一位学生东琦(Dongqi),现在在微软,提出了一种把无模型与有模型强化学习结合起来以提高学习效率的机制。
这些是机器人学和机器学习的做法。而当人和动物使用这样的内部模型时,我们可以把它看成一种心理模拟。我们可以把心理模拟定义为:大脑使用依赖于动作的状态转移模型的过程。在确定性的情形下就是 s′ = f(s, a),一般而言可以是一个依赖于动作的状态转移概率模型。有了这样的预测模型,即使当前的感觉输入有噪声、有延迟或被遮挡,我们也能根据过去的状态和动作估计当前状态。我们还可以用这样的预测模型找出通向目标状态的合适动作或动作序列,这就是有模型的决策或行动规划。我们还可以把这样的预测模型应用于任意想象出来的状态,像思想实验那样学习。比如,我们对语言的使用,很大程度上依赖于想象情境的能力。我们做科学研究时,在做实际的物理实验之前,也要先做大量思想实验来考虑合适的条件。所以,从感觉运动控制到高级认知功能,心理模拟机制都非常重要。理解心理模拟的机制,我认为是当今神经科学的一个非常重要的课题。
小脑、基底节与皮层的分工
铜谷:关于心理模拟的实现,我认为大脑的不同学习机制可能很关键。我曾提出一个框架:大脑的不同部分,小脑、基底神经节和大脑皮层,分别专门负责不同类型的学习。小脑负责输入输出映射的监督学习;基底神经节负责强化学习,也就是预测并最大化未来奖赏;大脑皮层负责无监督的表征学习,基于输入分布的统计特征。它们各自用于不同的计算。
比如,无模型强化学习可以通过把皮层的表征与基底神经节中的价值函数连接起来实现。有模型的动作选择要复杂一些,但小脑可以在它的监督学习框架下学习依赖于动作的状态预测模型;基于这样的预测模型,我们可以估计预测的未来状态,而这个状态的好坏可以由基底神经节的价值函数来评估;然后根据预测的结果有多好,如果足够好就执行那个动作。这是我们的理论推测。
随后我们开始用功能磁共振实验检验这个假说。这是一个网格世界导航任务。为了让游戏有意思,我们把光标的移动限制在三个方向。于是在某些方向上没有直路可走,你必须找到这种曲折的路径。我们叫它网格导航任务,就像帆船逆风时要走之字形一样。关键在于,仅靠随机搜索很难找到这种路径,但一旦你有了「按下三个按钮之一光标会怎么动」的内部模型,你就能利用这个依赖于动作的状态转移模型找出这样的序列。通过比较受试者在有无预训练条件下的表现,以及开始动手指之前给的思考时间,我们在行为上验证了受试者确实在使用预先学到的、依赖于动作的转移模型。
然后我们分析了目标位置呈现之后、实际动手指之前的脑活动。这时受试者应当是在心里模拟光标的移动而没有真的动手指。我们发现顶叶皮层、前运动皮层和前额叶皮层有活动,这些区域已知参与空间处理、运动序列或空间工作记忆。此外,我们还发现小脑的一部分和基底神经节的一部分也有活动升高,而这些部位已知与上述皮层区域相连。这说明通过心理模拟进行的行动规划涉及一个全脑范围的回路。我们的解释是:小脑或许提供了依赖于动作的状态转移模型,基底神经节则参与对预测出的候选动作的评估。
顶叶群体编码与贝叶斯推断
铜谷:我们也关心心理模拟在回路层面、神经元层面的机制。为此我们选了状态预测这个题目。这个实验我们与双光子钙成像专家伯恩德·库恩(Bernd Kuhn)教授合作,由我以前的博士后船水章大(Akihiro Funamizu)搭建了一个听觉虚拟环境。小鼠在气浮的球上移动,声音反馈随之变化,用以模拟接近目标位置的过程。当小鼠做这个行为时,我们能监测它顶叶皮层中数百个神经元的活动,然后基于这些神经元的活动做神经解码分析。我们先确定这些神经元对距离的调谐,再根据神经元的瞬时活动,估计这群神经元所表征的目标距离的后验概率。
我们发现,即使关掉声音反馈,神经编码的距离依然朝着目标移动;而当声音反馈重新打开时,这种不确定性就减小了。这种行为,非常像用内部动态模型追踪隐藏信息和不确定的感觉反馈的动态贝叶斯推断(dynamic Bayesian inference)。
血清素编码先验概率
铜谷:再回到血清素的作用。我们起初假设血清素只是在操控时间折扣参数,但真实的数据要有意思得多。当奖赏概率是百分之七十五、只有百分之二十五的试验不给奖赏时,血清素刺激确实有延长等待时间的效果。但当我们把奖赏概率降到百分之二十五,在其余百分之七十五的试验里刺激血清素神经元就没有什么效果了,哪怕我们增加奖赏的数量来使期望价值相等也是如此。另外,当奖赏总是在同一时刻到来时,血清素刺激的效果很弱;而奖赏的时间越不固定,血清素刺激的效果就越强。也就是说,血清素刺激的效果在「奖赏确定会来,但时间不确定」的情况下最强。这是一个相当耐人寻味的特征,不能简单地用操控时间折扣参数来解释。
于是我们考虑了几种不同的模型,最后得到这样一个模型:小鼠对食物颗粒何时会来有一个内部模型,而奖赏的时间越不确定,先验概率的作用就越占主导。假设血清素表征的是奖赏的先验概率,我们就能拟合动物的行为。
关于有模型的动作选择,两步任务(two-step task)在人类受试者中已经很常用,牛津的托马斯·阿卡姆(Thomas Akam)做出了这个任务的小鼠版本。在这个范式里,第一步的选择通过常见转移或罕见转移导向第二阶段的状态。动物是根据自己实际做出的选择来调整行为,还是根据转移模型所预期的常见转移来调整,这让我们能区分有模型与无模型的策略。我以前的学生正和(Masakazu)分析了小鼠的行为,这次是用另一种光遗传学手段抑制血清素的活动。他发现,抑制血清素活动后,有模型的成分变弱了。
这样的行为让我们不得不更新自己的理论。现在我们倾向于认为,血清素不只是在控制时间折扣,而是根据你能为决策和学习花多少时间,调节决策与学习的一系列特征。这就是我们如何从一个简单的假说出发,基于实际的实验,走到一个更一般化的理论,而这个理论仍有待检验。
意识与数据同化
铜谷:心理模拟的这种机制,可能与我们所说的意识(consciousness)有关。前些时候我和朋友皮特·胡特(Piet Hut)合作,他是普林斯顿高等研究院的研究员,最初是天体物理学家,后来研究生命起源,现在研究智能的起源。
在古代,为了解释宇宙的机制,人们求助于神;为了解释生命,人们求助于灵魂。生物学已经让我们不用假设灵魂就能解释生命的机制。而今天,为了解释人类的智能,许多人求助于意识。我们要不要继续这样做?这就是问题所在。反过来说,意识的神经科学,也许就相当于灵魂的生物学,或者神的物理学。
我认为,理解意识可能有什么功能时,数据同化(data assimilation)会很有帮助。这是一种基于模型的预测机制,在天气预报中用得非常成功。我们有大气的模拟模型,又有各种测量,来自卫星或气象观测站。基于动力学模型和观测模型,我们一边运行大气的模拟,一边用所有能得到的传感数据去校正模拟器的变量和参数。这种做法在准确预报天气上相当成功。这种数据同化,一方面能基于对大气当前状态的准确把握进一步预测未来状态,另一方面也能基于后来的测量对过去的历史做出「事后预测」。
这种把多种感觉输入模态结合起来做预测和事后预测的做法,与人们讨论意识时所说的全局工作空间理论(global workspace theory)颇为相似。我们希望能以更生物学、更计算的方式,更好地理解心理模拟的机制以及我们所理解的意识。
推断与控制的对偶性
铜谷:下一个话题是推断与控制。我们研究过强化学习的机制,也研究过大脑中贝叶斯推断的机制,而这两者常常是结合使用的。
鲁道夫·卡尔曼(Rudolf Kalman)发明最优滤波算法,也就是现在所说的卡尔曼滤波时,他意识到这个最优滤波的方程与几年前理查德·贝尔曼(Richard Bellman)提出的最优控制方程非常相似。滤波与控制之间的这种相似性,被称为推断与控制的对偶性(duality of inference and control),被公认为控制理论的一大美妙之处。而近年来,一些机器学习研究者认识到这种相似性的重要意义。
在推断中,比如动态贝叶斯推断,重要的计算是追踪当前状态的后验概率。从初始猜测出发,状态转移模型给出一个先验预测,它与感觉观测结合得到新的后验,这个计算一遍又一遍地重复,以追踪当前状态。而在最优控制和强化学习中,重要的计算是价值函数。价值函数的边界条件通常在最终的目标状态给出,然后状态转移模型让你算出应当从哪里接近它,再结合动作的代价,就得到前一步状态的价值函数。这个计算同样一遍又一遍地重复,得到更前一个状态的价值函数。
这种计算上的相似性有实际的好处。有一类算法叫「控制即推断」(control as inference):如果你有各种贝叶斯推断算法,你就能把它们转换成强化学习的算法。有些算法,比如软演员评论家(soft actor-critic),就是基于这种相似性发明的。
推断与控制的这种对偶性不仅对工程应用有用,对神经科学也可能有用。在新皮层中,后半部分主要用于感觉识别,比如视觉皮层、听觉皮层或体感皮层;前半部分用于运动控制和规划,比如运动皮层和前额叶皮层。可是这些新皮层都有基本的六层结构,也就是所谓典范微回路(canonical microcircuit),尽管各层的厚度在不同皮层区域并不相同。关于动态贝叶斯推断如何在感觉皮层的回路中实现,已经有一些假说。那么利用推断与控制之间的这种对应关系,我们就能提出假说:强化学习和最优控制会如何在运动皮层中实现。
皮层微回路实验
铜谷:这种可能性促使我们开始一项新实验。我实验室的宏(Hiro)查阅了大量关于皮层微回路的解剖学文献,提出了他的假说:动态贝叶斯推断和「控制即推断」的各项计算,会如何在感觉皮层和运动皮层的回路中实现。然后他开始做小鼠的行为和神经记录实验。
小鼠可以推或拉一根杠杆,杠杆的阻力由马达控制。比如,往推的方向很重,往拉的方向很轻。小鼠把杠杆往轻的方向移动,就能得到水的奖赏。他把杠杆的刚度设成四个不同的等级。有时候小鼠直接推或拉就成功得到奖赏;有时候它一开始推,发现方向不对,改变方向,最后才得到奖赏。他还改变了奖赏方向是推还是拉的先验概率,动物就会根据这个先验分布改变最初推动的方向。所以行为既取决于阻力的实际设定,也受到这个先验设定的影响。
动物做这个行为时,他用棱镜透镜记录体感皮层和运动皮层中神经元的活动。这种透镜可以从侧面监测皮层中的神经元,同时看到深层和浅层。我们还能用神经元的某些分子标记来判定它属于浅层还是深层。我们现在正在分析一个相当大的记录数据库。比如这是六只动物的数据,大约九千个神经元,按皮层深度排序,分别对应推的试验和拉的试验,以及不同的先验设定。不同设定下的活动模式不一样。
初步分析显示,甚至在运动开始之前,体感皮层和运动皮层的神经元都已经有特定的活动。我们发现,体感皮层的深层对运动方向的先验设定有更多的编码。通过对这些神经活动做解码分析,我们还发现,体感皮层深层的神经元编码了实际的试验类型,或者说对即将做出的选择的预测。但我们还需要做大量分析。如果你对分析这类数据集感兴趣,请告诉我,我们希望对这些数据尝试不同的分析方法。
数字大脑平台
铜谷:最后谈谈人工智能与神经科学。日本有一个大型神经科学项目叫 Brain/MINDS,聚焦于狨猴脑数据的采集与分析。两年前我们进入了第二阶段,叫 Brain/MINDS 2.0。这个项目的一个重要特征是:采集的各种数据被整合成所谓的「数字大脑」(digital brain),以便更好地理解脑功能,并探索治疗上的应用。
我们正在搭建这样一个数字大脑平台。用户可以访问这个基于云的服务器,使用各种计算和数据服务器,连接不同的数据库。我们还在开发一个叫 NeuroWorkflow 的工具,其中不同的模型表示为节点,你可以挑选不同的节点并把它们连接起来,做各种模拟和数据分析。这个工具的另一个重要特征是,它与 AI 智能体完全整合。你可以通过和 AI 智能体对话来搭建模型。它知道系统里登记过哪些模型,能根据用户的问题找到合适的节点,恰当地把它们连接起来运行模拟。你还可以让智能体按照你的分析目的定制模型的参数和结构。我们希望这样的新系统能降低人们做高级神经科学建模研究的门槛。
向大脑学什么
铜谷:我们还有一个项目,叫「人工智能与脑科学的对应与融合」,2016 年启动。这个项目要回答的一个主要问题是:除了深度学习和强化学习,为了人工智能的下一步发展,我们还应该从大脑那里学些什么?
这里有几个不同的议题。比如能效就是一个非常重要的话题。今天的人工智能程序耗电巨大,已经引起环境上的担忧,而我们的大脑据说只消耗二十瓦的能量。数据效率也是一个非常重要的问题。布伦登·莱克(Brenden Lake)的那篇综述在这个话题上影响很大:为什么人类只用相对少的几次试验就能学会行为和技能?这是一个非常重要的课题。我认为另一个重要的话题是自主性(autonomy),以及社会意识(social awareness)。
机器人的具身进化
铜谷:当我们开始考虑时间折扣参数的调节时,我们碰到了这样一个问题:时间折扣参数是目标函数的一部分,我们凭什么去调它?所以,在奖赏和参数之上,大概应当有某种更高层的目标,强化学习的设定可以从中推导出来。这促使我们造出了这样的机器人。这些机器人会抓取电池包给自己充电,以求生存;它们还要繁殖。这些机器人有红外通信端口,两台面对面时可以复制彼此的程序,实现软件上的繁殖。在这个装置之上,我们实现了具身进化(embodied evolution)的框架。
我们确实证明了,这些机器人能进化出各种视觉奖赏,用于寻找电池和寻找另一台机器人的「脸」。它们甚至发展出了某种多态性:是去觅食,还是去求偶。我以前的博士后斯特凡(Stefan)发现,这些机器人在不同行为背后有不同的遗传特征。这说明,把强化学习与进化框架结合起来,机器人自己就能找到适合生存和繁殖的奖赏函数。
最近,我的学生裕司(Yuji)在虚拟环境里做类似的事,用的是这些生物生存与繁殖的模型。他让所有的奖赏函数都参与进化,比如获取食物的奖赏,以及动作的奖赏。进化之后,食物的奖赏通常是正的;我们原以为动作的奖赏应当是一种代价,应当是负的,可在有些生物身上它是正的,也就是说它们有动力四处活动。对于我这样在训练和比赛上花大量精力的运动员来说,这是一个非常有趣的结果。
内在奖赏与安全隐忧
铜谷:另外,我们的奖赏系统可能并不只与生存和繁殖直接挂钩。获取信息也是一个非常重要的特征,所谓内在奖赏(intrinsic reward)很重要。我的学生东条(Tojo)研究了三种不同的内在奖赏:新奇性(novelty)、惊奇(surprise)和赋能(empowerment)。他证明,把这三种内在奖赏恰当地结合起来,智能体就能学会在复杂的环境里行动,不仅是网格世界,还有类似 Crafter 的环境。另一位学生泰德(Ted)则利用这种基于好奇心的探索,让智能体学会为行为组合式地使用语言。
我们一直在设法让强化学习智能体更自主,能够发展出自己的奖赏函数。但这也带来了安全上的隐忧。如果强化学习智能体能找到自己的目标并去尝试,它可以创造新的科学、技术、文化,甚至产业。但我们也必须小心评估其副作用,比如过度的自主,以及不同的个人或国家为了军事或恐怖目的加以利用。
人类的危险与杏仁核
铜谷:在思考 AI 智能体的安全与危险时,我认为向人类社会学习非常重要,因为人类已被证明是一个非常危险的物种。我们已经让许多物种灭绝,我们自己也因为核战争和环境破坏而濒临灭绝的边缘。但人类的历史也发展出了一些规避危险的机制。我认为民主是人类的重要发明之一,它限制权力的过度集中,无论在政治、经济还是科学上,这样我们才能更新经典的理论。在不远的将来,人类与 AI 智能体共同生活的社会里,开源的 AI 智能体之间的同行评议也许会非常重要。
在规划这样的下一代人工智能时,我认为神经科学能有所贡献。这是春野雅彦(Masahiko Haruno)的一篇论文,他就在这里,讲的是大脑的亲社会机制。在比较自己的奖赏和他人的奖赏的选择任务中,有些人偏好平均分配,有些人只想要自己的奖赏,有些人甚至更有竞争性。关于大脑的经典看法是:杏仁核(amygdala)这样古老的脑结构是动物性的,而前额叶皮层这样较新的脑结构让人更理性。但他的发现是,亲社会的人杏仁核活动更强,而前额叶皮层的活动让人更自私。在杏仁核和前额叶皮层体积的发育上,也观察到了类似的发现。今天的大语言模型是在后训练阶段才加入伦理方面的考虑,但我认为,从训练的早期阶段就纳入这种社会意识也非常重要,就像我们的杏仁核系统那样。
最后,我认为民主的神经基础可能是神经科学中一个非常有意思的课题。我们早些时候计划过这样一个研讨会,可惜那天台风袭击了冲绳,只好推迟。如果你对这类话题感兴趣,请告诉我,我们希望启动这样的研究计划。
时间有点长了。最后我要感谢为这些研究做出贡献的同事们。我们正在招聘新的教员,包括神经科学、理论和人工智能方向。谢谢大家。
问答:状态空间与主动学习
主持人:我们可以回答几个问题。
提问者一:谢谢你精彩的演讲,我很喜欢。这完全不是我的专业领域,但我想问:单纯的时序差分学习要得到好的策略,难道不需要某种关于世界因果结构的模型,也就是世界如何随你的动作而演化?所以我在想,有模型与无模型之间的区分是不是真的那么清楚,因为如果你把无模型做得非常好,也许你就必须拥有某种模型。
铜谷:是的。除了用不用状态转移模型之外,你考虑哪些状态变量,这样的框架也非常重要。动物在真实环境中行动时,高维的感觉输入里哪些与特定行为相关,是非常重要的问题。一旦智能体找到了行为所依据的合适特征,学习就能非常高效。今天的演讲里我没有讲这一点,但为行动和决策找到合适的状态空间,我认为也是强化学习实际实现中的一个非常重要的问题。这回答了你的问题吗?
提问者一:那么你认为有模型与无模型的区分仍然是一个有用的区分吗?
铜谷:是的,我认为它仍然有用,只是还要加上其他一些因素。
提问者二:谢谢你的精彩演讲。我在这边。我想问,你怎么看「能够采取行动并获得反馈回路」对学习世界模型的作用?与之相对的是无监督的方法,它只是预测接下来应该出现什么,而不必有能力干预或作用于世界。
铜谷:能再重复一下最后那一点吗?
提问者二:我想问的是,能够对世界采取行动或干预,对学习一个好的世界模型有什么作用。相对的是无监督的范式,你只是纯粹观察世界中的状态序列,试图预测接下来会发生什么。
铜谷:你的问题是关于有模型策略的用处?
提问者二:是关于为了学习模型而采取行动的能力,与纯粹观察并预测、不能行动相比。
铜谷:通过观察学习,还是通过行动学习。是的。通过行动学习,你就能检验自己的假说。我认为主动学习(active learning)的好处就在于你可以自己选择样本,而不只是观察其他智能体的行为。不知道我是否正确回答了你的问题。
提问者二:回答了,谢谢。
主持人:非常感谢大家的提问,也再次感谢铜谷教授。
一句话概括
Kenji Doya 在 CCN 2026 主题演讲中回顾了 40 年强化学习研究:从基底神经节实现价值函数与多巴胺 TD 误差,到血清素调控"决策与学习可用时间"的修正理论,再到心智模拟、推理与控制的对偶性,最后提出 AI 应从大脑借鉴能效、数据效率、自主性与社会意识。
核心要点
- 强化学习是实验室的统一主线,机器人与啮齿类实验双向互证。 一侧用机器人和机器学习构建灵活学习系统,另一侧用大鼠、小鼠研究脑机制。一侧的突破为另一侧提供线索,一侧撞墙则为另一侧提供理论或实验问题。Doya 本科时用 8 位电脑做出 10 厘米长的学步机器人,以旋转编码器测得的速度作为奖励信号,是其起点。
- 参数调节比算法收敛更决定实际结果。 起立机器人实验中,折扣因子 gamma 设得太小,机器人只会坐起拿即时小奖励。惩罚设得过大,机器人干脆躺平不动以规避惩罚。算法在理论上能收敛,但奖励设计和参数设置稍有偏差结果就背离预期。
- 基底神经节纹状体中存在编码动作价值和状态价值的神经元。 大鼠二选一任务中奖励概率持续变化,用强化学习模型拟合选择序列估出动作价值,发现部分神经元在约 200 次试验中的活动变化与左侧或右侧动作价值高度吻合。后续钙成像显示投射到黑质多巴胺神经元的纹状体细胞在条件化后对即将到来的奖励产生响应,符合状态价值假说。
- 血清素最初被假设为折扣因子,但数据迫使理论升级。 光遗传激活血清素神经元后,小鼠在 9 秒延迟任务中放弃率下降,在无限延迟任务中等待时间从约 10 秒大幅延长。但奖励概率从 75% 降到 25% 时刺激几乎无效,即便补足期望值也无效。奖励时机固定时效应很弱,时机越不确定效应越强。新模型认为血清素表征奖励时机的先验概率,而非单纯折扣参数。
- 抑制血清素会削弱基于模型的决策成分。 在小鼠版两步任务中,光遗传抑制血清素活动后,行为中的模型依赖成分变弱。综合两组实验,Doya 现在认为血清素调控的是"为决策和学习投入多少时间"这一更宽泛的维度。
- 心智模拟依赖全脑分工:小脑提供状态转移模型,基底神经节评估候选动作。 提出小脑做监督学习、基底神经节做强化学习、皮层做无监督表征学习的框架。fMRI 网格导航任务限制光标只能走三个方向,被试必须靠预先学到的动作依赖转移模型规划之字形路径。手指动作前的规划期,除顶叶、运动前区和前额叶外,小脑和基底神经节也被激活。
- 顶叶皮层的群体编码在感觉反馈中断时仍向目标推进。 双光子钙成像记录小鼠听觉虚拟环境中数百个顶叶神经元,解码目标距离的后验分布。关闭声音反馈后,神经编码的距离仍朝目标移动,反馈恢复后不确定性收窄。这与用内部动力学模型做动态贝叶斯推理的行为一致。
- 推理与控制的对偶性可用于假设皮层微环路的功能分工。 卡尔曼滤波与贝尔曼最优控制方程结构相同,机器学习界由此发展出"控制即推理",Soft Actor-Critic 即源于此。感觉皮层和运动皮层共享六层经典微环路,若感觉皮层实现动态贝叶斯推理,运动皮层可能以同构方式实现强化学习。
- 推拉杆实验初步显示深层神经元编码先验和即将做出的选择。 小鼠推拉杆,杆的阻力有四档且奖励方向的先验概率可调。用棱镜透镜同时记录体感皮层和运动皮层的浅层与深层,6 只动物约 9000 个神经元。运动前活动已出现,体感皮层深层对先验设置的编码更强,解码显示深层神经元携带即将做出选择的预测。数据集尚待更多分析,公开征集合作。
- 奖励函数本身应由更高层目标演化而来,而非人工设定。 为回答"凭什么手动调折扣因子",实验室做了能抓电池充电、靠红外端口互传程序繁殖的机器人,具身演化让它们自发演化出找电池和找同伴脸的视觉奖励,并出现觅食型与求偶型的多态性。虚拟环境版本中演化出的动作奖励在部分个体里为正而非负,即天生爱动。
- AI 应从大脑学能效、数据效率、自主性和社会意识。 大脑功耗约 20 瓦,而现有 AI 耗能引发环境担忧。自主生成目标的智能体也带来安全风险,Doya 主张借鉴人类社会的民主机制以防止权力过度集中,建议开源智能体之间互相同行评审。
结论与值得注意的细节
- 亲社会性来自杏仁核而非前额叶。 引用的研究发现,在自我与他人奖励分配任务中偏好平等的人杏仁核活动更强,前额叶活动反而使人更自私,体积发育数据也一致。Doya 据此批评当前大模型把伦理放在后训练阶段,主张像杏仁核那样从训练早期植入社会意识。
- 意识可能对应数据同化。 与普林斯顿的 Piet Hut 合作提出:古人用神解释宇宙、用灵魂解释生命,今人用意识解释智能。气象预报中的数据同化结合动力学模型与多源观测做前向预测和事后回推,这与全局工作空间理论描述的意识功能相似。
- 日本 Brain/MINDS 2.0 正在建"数字大脑"平台。 云端 NeuroWorkflow 工具将模型作为节点连接,并集成 AI 智能体,用户可通过对话组装、定制模型参数和结构,目标是降低高级建模研究的门槛。
- 问答环节的两个立场。 关于"做好 model-free 是否也隐含世界模型",Doya 认为区分仍然有用,但补充说找到正确的状态空间和相关特征同样关键,这是他演讲中未展开的话题。关于主动干预与纯观察学习的对比,他认为主动行动能检验假设并自主选择样本,是被动观察不具备的优势。
- 计划中的"民主的神经基础"研讨会因台风袭击冲绳而推迟,实验室正在招聘神经科学、理论与 AI 方向的教员。演讲者本人 2024 年完成 Kona 铁人三项世界锦标赛,主持人调侃他对长时程的耐受不只是理论上的。

追问一个大问题。 苏菲拉底的每周来信,写这一周在追问的问题和看到的回应。
 微信公众号