
Andrej Karpathy — “We’re summoning ghosts, not building animals”
节目发布 2025-10-17 · Dwarkesh Patel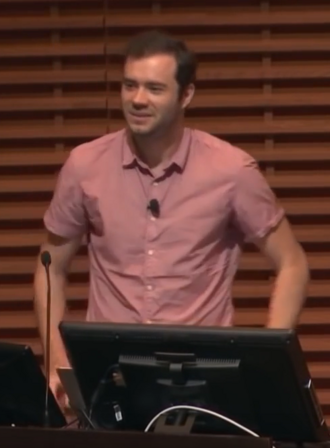 安德烈·卡帕西
DDwarkesh Patel
编者按:本文是《Dwarkesh Podcast》与安德烈·卡帕西(Andrej Karpathy)的一次长谈,原题为「我们是在召唤幽灵,不是在造动物」。卡帕西是 OpenAI 创始成员,2017 至 2022 年任特斯拉 AI 高级总监,领导 Autopilot 视觉团队,也是斯坦福最早那门深度学习课的开设者;提问者德瓦克什·帕特尔长期深度访谈 AI 研究者、经济学家与科学家。两人从「为什么是 agent 的十年而不是元年」谈起,一路谈到强化学习的粗陋、模型的坍缩、智能演化的偶然,以及卡帕西眼下真正投入的事:教育。本文依据现场录音编译整理,只删去口语枝节与重复,论证、例子与语气一概保留。
十年,不是一年
主持人: 你为什么说这将是 agent 的十年,而不是 agent 的元年?
卡帕西: 谢谢你请我来。你引的这句话其实是一个反应。之前有人说,这将是 agent 的元年,意思是大语言模型今年就会演化成能干活的智能体。我不知道最早是谁说的,但这句话戳到我了,因为行业里存在明显的过度预测。
卡帕西: 在我看来,更准确的说法是 agent 的十年。我们今天已经有了一些非常早期、也确实非常惊艳的 agent,我每天都在用,比如 Claude、Codex 之类。但我仍然觉得要做的事太多了。我的反应是:我们会和这些东西一起工作十年,它们会越来越好,那会非常美妙。我只是在纠正那个时间表的暗示。
主持人: 你觉得什么东西要花十年?瓶颈在哪里?
卡帕西: 让它真正能用。当你说 agent 的时候,不管是各大实验室心里想的,还是我心里想的,你都应该把它当成一个你雇来一起干活的员工或实习生。比如你这里也有员工。你什么时候会愿意让 Claude 或 Codex 来干他们的活?现在当然不行。要做到那一步还差什么?为什么你今天不这么做?原因很简单,它们就是不行。智能不够,多模态不够,不会用电脑,等等。它们缺你刚才提到的很多东西,没有持续学习的能力,你没法告诉它一件事,它就永远记住。
卡帕西: 它们在认知上是残缺的,所以就是不成。要把这些问题一个个啃下来,大概需要十年。
主持人: 有意思。作为一个职业播客主持人,一个远远观望 AI 的人,我很容易说出缺了什么:缺持续学习,缺多模态。但我没有办法给它安上一个时间表。如果有人问我持续学习要多久,我完全没有先验去判断这是一个五年、十年还是五十年的工程。为什么是十年?为什么不是一年?为什么不是五十年?
卡帕西: 这就要说到我自己的直觉了,以及基于我在这个领域里的经验所做的外推。我做 AI 快二十年了,差不多十五年吧,其实也不算久。你之前请过理查德·萨顿(Richard Sutton),他在这行的时间长得多。但我确实有十五年时间在看人做预测,在看那些预测后来怎么样。我在研究界待过,也在工业界待过一段时间。这些经历给我留下了一种总体直觉。我觉得这些问题是可解的,是能翻过去的,但依然很难。把这些平均一下,感觉就是十年。
十五年,三次转向
主持人: 这很有意思。我不只想听这段历史,我还想听每一个突破时刻里,屋子里的人当时是怎么感觉的。他们的感觉在哪些地方过于悲观,哪些地方过于乐观?要不我们一个一个过?
卡帕西: 这个问题太大了,你说的是十五年里发生的事。AI 迷人的地方在于,它经历过好几次地震级的转向,整个领域会突然朝一个完全不同的方向看过去。我大概活过其中两三次。我还觉得会继续有,因为它们出现的频率规律得让人吃惊。
卡帕西: 我的职业生涯开始的时候,我之所以开始做深度学习,之所以对它产生兴趣,纯粹是因为我碰巧就在多伦多大学杰弗里·辛顿(Geoff Hinton)旁边。辛顿当然是 AI 的教父级人物。他在训练那些神经网络,我觉得这太不可思议、太有意思了。但那绝不是当时 AI 圈里大家在做的主流。那是个边上的小众课题。
卡帕西: 第一次剧烈的地震是 AlexNet 那一波。AlexNet 让所有人转了向,大家都开始训神经网络,但仍然是一个任务一个模型:我有个图像分类器,我有个神经机器翻译系统,诸如此类。人们慢慢地开始对 agent 感兴趣,开始想:好吧,视觉皮层这一格算是打了勾,那大脑的其他部分呢?我们怎么才能得到一个完整的、能在世界里行动的智能体?
卡帕西: 2013 年前后的 Atari 深度强化学习转向,在我看来就是早期 agent 努力的一部分,因为它试图让智能体不只是感知世界,还要采取行动、与环境互动、从环境里拿到奖励。当时的载体是 Atari 游戏。我觉得那是一次走偏。这个偏差连我参与的早期 OpenAI 也接受了,因为当时的时代精神就是强化学习环境、游戏、打游戏、通关、找各种各样的游戏来玩,OpenAI 做了大量这类事。那又是 AI 的一个显赫阶段,大概有两三年、四年,所有人都在游戏上做强化学习。
卡帕西: 那整体上是走偏了。我在 OpenAI 想做的事情,一直对「游戏能通向 AGI」这件事抱有怀疑。因为在我心里,你想要的是一个会计那样的东西,一个和真实世界打交道的东西。我实在看不出游戏怎么加总成那个。比如我在 OpenAI 的项目属于 Universe 计划的一部分,做的是一个用键盘和鼠标操作网页的智能体。我真心想要一个和真实的数字世界互动、能做知识工作的东西。
卡帕西: 结果证明这太早了,早得离谱,早到我们根本不该做那件事。因为如果你只是在环境里瞎摸、乱敲键盘、乱点鼠标,试图拿到奖励,你的奖励太稀疏了,你根本学不到东西。你会烧掉一整片森林的算力,也什么都起不来。你缺的是神经网络里的表征能力。比如今天人们也在训练操作电脑的智能体,但他们是在一个大语言模型之上做的。你得先有语言模型,先有表征,那得靠全部的预训练和那一整套 LLM 工作换来。
卡帕西: 所以粗略地说,人们有好几次都太早地去抓那个完整的东西,太早地去追 agent。Atari 是,Universe 是,我自己的经历也是。你得先把一些事做完,才轮得到那些智能体。现在的 agent 能力强多了,但我们可能仍然缺了这个栈里的某些部分。
卡帕西: 所以我会说,人们做过的事大致是三大块:按任务训神经网络,第一轮 agent 尝试,然后是大语言模型,先去拿到神经网络的表征能力,再往上加别的东西。
我们在造幽灵
主持人: 有意思。如果我来替萨顿的观点辩护,大概会这么说:人类可以一次性把所有东西一起学,甚至动物也可以。动物可能是更好的例子,因为它们连语言这层脚手架都没有。它们被扔进世界里,没有任何标签,就得把一切弄明白。那么 AGI 的愿景就应该是这样一个东西:它看着感官数据,看着电脑屏幕,从零开始自己搞清楚发生了什么。如果把一个人放进同样的处境,从零训练起,这就像一个人长大,或者一只动物长大。为什么这不该是 AI 的愿景,而要去做那种几百万年量级的训练?
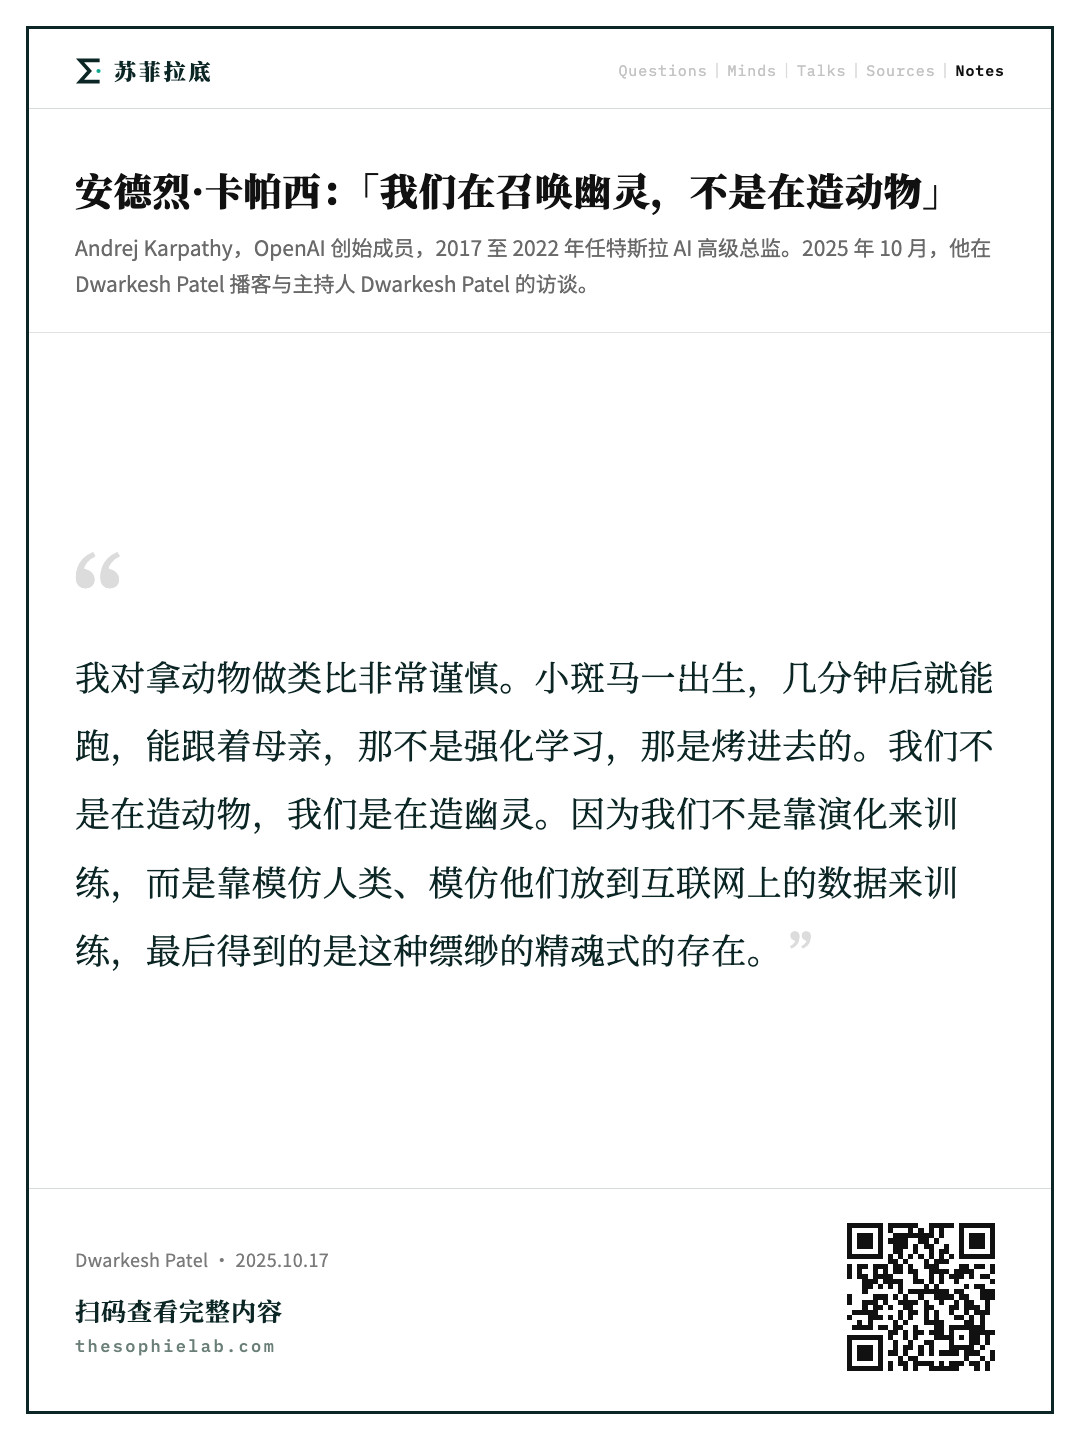
卡帕西: 这是个很好的问题。萨顿上过你的播客,我看了,也写过一篇文章谈我怎么看那期节目。我对拿动物做类比非常谨慎,因为它们是另一种优化过程的产物。动物是演化出来的,它们出厂时自带海量的硬件。我在文章里举的例子是斑马。小斑马一出生,几分钟后就能跑,能跟着母亲。那是极其复杂的能力。那不是强化学习,那是烤进去的。演化显然有办法把我们神经网络的权重编码进 ATCG 里,我完全不知道那是怎么做到的,但它显然做到了。
卡帕西: 大脑来自一个非常不同的过程,我很犹豫要不要从那里取经,因为我们跑的根本不是那个过程。我在文章里说,我们不是在造动物,我们是在造幽灵,或者精魂,随便人们怎么叫,因为我们不是靠演化来训练。我们是靠模仿人类、模仿他们放到互联网上的数据来训练。你最后得到的是这种缥缈的精魂式的存在,因为它们完全是数字的,而且在模仿人类。
卡帕西: 那是另一种智能。如果你想象一个智能的空间,我们几乎是从另一个点出发的。我们并不是在造动物。但让它们随时间变得更像动物一点,这也是可能的,我觉得我们应该往这个方向做。
卡帕西: 还有一点。萨顿的框架是「我们要造动物」。如果真能做成,那当然好极了,那会非常了不起。如果真存在一个单一算法,你把它放到互联网上一跑,它什么都学会了,那太不可思议了。但我不确定它存在,而且那肯定不是动物的做法,因为动物外面还套着一层演化的循环。
卡帕西: 很多看起来像学习的东西,其实更像是大脑的成熟。我认为动物身上的强化学习非常少。大部分强化学习更接近运动任务,不是智能任务。所以我其实认为,粗略地讲,人类并不怎么用强化学习。
主持人: 最后一句能重复一遍吗?很多智能不是运动任务,是什么?
卡帕西: 在我看来,真正算强化学习的,是那些更偏运动的、简单的任务,比如投篮。但我不认为人类在解题这类智能任务上用的是强化学习。这不等于我们做研究时不该用它,我只是说动物大概不是这么干的。
主持人: 我得花一秒消化一下,这里面掺了好几个想法。有个澄清性的问题也许能帮我理解你的视角。你的意思是,演化在做的事情,某种程度上就是预训练在做的事情,也就是造出一个随后能理解世界的东西。区别在于,在人类这里,演化必须通过三十亿碱基对的 DNA 来过滤。那和模型的权重非常不一样。模型的权重直接就是一个大脑,而大脑显然不存在于精子和卵子里,它必须长出来。而且大脑里每一个突触的信息,根本不可能装进那三十亿碱基里。演化看起来更接近于找到一个算法,再由这个算法完成一生的学习。当然,按你的说法,一生的学习也许并不类比于强化学习。这和你刚才说的兼容吗,还是你不同意?
卡帕西: 我想是兼容的。我同意你说的,这里有某种奇迹般的压缩,因为神经网络的权重显然没存在 ATCG 里。那是极其剧烈的压缩。里面编码了一些学习算法,接手之后在线完成一部分学习。这点我完全同意。
卡帕西: 我要说的是,我要实用主义得多。我不是从「我们来造动物」出发的,我是从「我们来造有用的东西」出发的。我戴着安全帽,我只是观察到:我们不会去跑演化,因为我不知道怎么跑。但事实证明,我们可以通过模仿互联网文档造出这些幽灵般的存在。这是管用的。它是一条路,能把你带到一个自带大量知识和某种智能的起点,某种程度上和演化做到的事类似。所以我把预训练叫做「粗劣的演化」。它是以我们现有技术和资源能实际做到的那个版本,把你送到一个起点,之后你才能做强化学习之类的事。
主持人: 再替另一边说两句。做完萨顿那期访谈又想了一阵,我觉得他这里有个重要的点。演化其实并不给我们知识,它给我们的是找到知识的算法,这和预训练似乎不是一回事。也许可以说,预训练帮助建立起一个更善于学习的实体,它教会的是元学习,因此和「找到一个算法」相似。但如果说法是「演化给我们知识,预训练给我们知识」,这个类比就站不住了。
卡帕西: 这个地方很微妙,你质疑得对。但基本上,预训练在做的事是:你在互联网上得到一个下一个词元的预测器,把它训进一个神经网络里。它同时在做两件互不相干的事。
卡帕西: 第一,它像我说的那样,把所有这些知识吸进去。第二,它真的变聪明了。通过观察互联网上的算法性模式,它在神经网络内部启动了各种小电路和小算法,做出上下文学习这类事情。你并不需要、也并不想要那些知识。我觉得知识大概总体上拖了神经网络的后腿,因为它让模型有时过分依赖知识。比如我觉得 agent 有一件事做得不好,就是走出互联网上已有数据的流形。
卡帕西: 如果它们的知识更少、记忆更少,也许反而会更强。我认为接下来要做的事,也会成为研究范式的一部分,就是想办法把一部分知识拿掉,留下我称之为「认知内核」(cognitive core)的东西。这是一个被剥去知识的智能实体,但它保留着算法,保留着智能与解题的魔法,保留着那些策略,等等。
上下文学习像什么
主持人: 这里面有意思的东西太多了。先从上下文学习说起。这是个显而易见的观察,但我觉得值得明说出来,好好体会一下。这些模型最像有智能的时刻,是我跟它说话时心想「哇,另一头真有个东西在回应我、在思考」的时刻。比如它犯了个错,然后说「等等,这么想不对,我退回去」。这一切都发生在上下文里。那才是我能肉眼看见的真正的智能。这个上下文学习的过程,是预训练时的梯度下降造出来的。它自发地元学习出了上下文学习,但上下文学习本身不是梯度下降,就像我们人类一生中做事的智能是被演化塑造的,但我们一生中的学习是靠另一个过程完成的。
卡帕西: 我不完全同意这个说法,不过你先说完。
主持人: 我很想知道这个类比是在哪里断掉的。
卡帕西: 我很犹豫要不要说上下文学习不是梯度下降。它不是显式的梯度下降。上下文学习是在一个词元窗口里做模式补全。而互联网上恰好有海量的模式。你说得对,模型学会了补全模式,这个能力在权重里。神经网络的权重在努力发现模式、补全模式。神经网络内部发生了某种适应,这很神奇,而它就是从互联网里掉出来的,仅仅因为模式太多了。
卡帕西: 但我要说,有几篇论文我觉得挺有意思,它们去看上下文学习背后的机制。我确实认为,上下文学习有可能在神经网络的层内部跑了一个小小的梯度下降循环。我记得有一篇论文,是用上下文学习做线性回归。你喂给神经网络的输入是一串 XY 对,XY、XY、XY,恰好都落在一条直线上。然后你给一个 X,期待它给出 Y。这样训练出来的神经网络,做的就是线性回归。正常情况下你跑线性回归,是有一个小的梯度下降优化器,看 XY,算误差,对权重求梯度,更新几次。
卡帕西: 结果他们去看那个上下文学习算法的权重,发现了一些和梯度下降机制相似的结构。我记得那篇论文更强的地方在于,他们还把神经网络的权重硬编码出来,让注意力和网络内部机制真的去执行梯度下降。这就是我唯一想反驳的地方。谁知道上下文学习到底怎么运作,但我觉得它内部大概在做某种古怪的梯度下降。
主持人: 我觉得这是可能的。
卡帕西: 我只是不同意你说它「不是梯度下降」这一点。谁知道它在干什么,也许是在做某种类似的事,但我们不知道。
主持人: 那就值得想想:如果上下文学习和预训练实现的都是类似梯度下降的东西,为什么上下文学习给我们的感觉是那种接近持续学习、接近真智能的东西,而预训练本身给不了同样的感觉?如果算法是同一个,差别可能在哪?一种想法是:模型每接收一份训练信息,存下了多少信息?
主持人: 看预训练,以 Llama 3 为例,它训练用了十五万亿个词元。70B 的模型,折算下来,模型权重里的信息量相对于它读过的词元,大约是每个词元 0.07 比特。而看 KV 缓存,在上下文学习里每多一个词元它增长多少,大约是 320 千字节。也就是说,模型从每个词元里吸收的信息量相差三千五百万倍。我不知道这是不是有关。
卡帕西: 我挺同意的。我通常的说法是:任何在神经网络训练阶段发生的事,那些知识只是对训练时所见的一个模糊回忆。因为压缩太剧烈了。你拿十五万亿词元,压进一个几十亿参数的最终网络里,显然压缩量巨大。所以我称它为对互联网文档的模糊回忆。而任何发生在上下文窗口里的事,你把所有词元插进去,建起那些 KV 缓存表征,对神经网络来说是可以直接取用的。所以我把 KV 缓存和测试时发生的一切,比作工作记忆。
卡帕西: 上下文窗口里的一切,神经网络都能直接拿到。LLM 和人之间总有这些几乎让人意外的类比。我觉得意外,是因为我们并不是在直接造一个人脑,我们只是发现这样管用就这么做了。但我确实认为,权重里的东西就像你一年前读过的东西的模糊回忆,而你在测试时作为上下文给它的东西,直接就在工作记忆里。这个类比很有力量。比如你去问一个 LLM 某本书里写了什么,比如尼克·莱恩(Nick Lane)的书,它常常会给你一些大致正确的东西。但如果你把整章塞进去再问,结果会好得多,因为它现在装进了模型的工作记忆。所以绕了一大圈,我同意,原因就在这里。
哪些脑区还没有
主持人: 退一步说,人类智能中我们最没能复制出来的那部分是什么?
卡帕西: 大部分都没复制出来。也许可以这样想,我不确定这是不是最好的方式,而且这些类比注定不完美:我们跌跌撞撞弄出了 Transformer,它极其强大,非常通用。你可以拿它训音频、训视频、训文本,什么都行,它就能学到模式,而且效果很好。这在我看来几乎说明它是某种皮层组织。类似那样的东西,因为皮层也以可塑性著称。
卡帕西: 大脑是可以改接线的。有过一些略显残忍的实验,把视觉皮层接到听觉通路上,那只动物照样学会了,等等。所以我认为这是皮层组织。我认为当神经网络内部在做推理和规划,思考型模型在生成推理轨迹时,那有点像前额叶皮层。这些也许算打了几个勾,但我仍然觉得有很多脑区和核团还没被碰过。比如我们用强化学习微调模型时,基底神经节那部分算是有点了。可海马体在哪儿?不明显。
卡帕西: 有些部分大概不重要。小脑对认知和思想也许不重要,那也许可以跳过。但我还是觉得,比如杏仁核,情绪和本能这一整块,以及脑中其他一堆非常古老的核团,我不认为我们真的复制出来了。不过我也不认为我们应该去追求造一个人脑的类比物,我骨子里还是个工程师。
卡帕西: 也许换个方式回答这个问题:你不会把这东西当实习生雇进来。它缺的东西很多,它带着我们和模型对话时都能直觉感受到的那些认知缺陷。所以它还没到位。你可以把它看成:不是所有脑区都打上了勾。
缺一个蒸馏阶段
主持人: 这也许关系到这些问题要多快才能解决。有人谈到持续学习时会说:「你看,这个能力很容易复现。就像上下文学习是预训练的自发产物一样,只要模型被激励去在更长的时间跨度上回忆信息,跨度超过单次会话,更长程的持续学习也会自发涌现。」也就是说,如果外层有一个跨越很多次会话的强化学习循环,那么这种持续学习,不管是它自己微调自己,还是写入外部记忆,就会自发出现。你觉得这类事有多大可能?我实在没有一个先验。
卡帕西: 我不太能共鸣这个说法。这些模型启动时窗口里有零个词元,它们永远是从原地重新开始。所以在那个世界观里,它究竟长什么样,我不清楚。
卡帕西: 还是拿人类打个比方,因为这挺具体也挺有意思。我醒着的时候,在不断累积一天里发生的事,堆出一个上下文窗口。但我睡着之后,有某种神奇的事发生了,我不认为那个上下文窗口还留着。有某种把它蒸馏进我大脑权重的过程,在睡眠里发生,等等。大语言模型没有对应的东西。你说持续学习缺失,我觉得更接近缺的是这个。
卡帕西: 这些模型没有一个蒸馏阶段:把发生过的事拿来,反复琢磨,想透,做一些合成数据生成,再蒸馏回权重里,也许每个人配一个专属的网络。也许是个 LoRA,不是全权重的网络,只是一小撮稀疏的权重被改动。但我们确实想造出这种拥有很长上下文的个体。这不只是靠留在上下文窗口里,因为上下文窗口会变得非常非常长,也许我们还有某种很精巧的稀疏注意力覆盖其上。但我仍然认为人类显然有某个过程把一部分知识蒸馏进权重,这个我们没有。
卡帕西: 我也认为人类有某种非常精巧的稀疏注意力机制,我觉得我们已经开始看到一些早期的苗头。DeepSeek v3.2 刚出来,我看到他们就用了稀疏注意力,这是实现超长上下文窗口的一条路。所以我觉得,我们正在用一个非常不同的过程,把演化想出来的很多认知技巧重新做一遍。但我们在认知上会收敛到相似的架构。
十年后还会是什么
主持人: 十年后你认为它还会是 Transformer 一类的东西吗,只是注意力被大改、MLP 更稀疏之类?
卡帕西: 我喜欢用时间上的平移不变性来想这个问题。十年前我们在哪儿?2015 年。2015 年我们主要用卷积网络,残差网络刚出来。所以既相当相似,又还是挺不一样的。Transformer 还不存在,那些对 Transformer 的现代改造也都不存在。按平移等变性,十年后我们大概可以押的是:我们仍然在训练巨大的神经网络,有前向、反向和梯度下降更新,只是样子会有点不同,而且一切都大得多。
卡帕西: 前几年我做过一个有趣的练习,一路回到 1989 年,复现了杨立昆(Yann LeCun)1989 年的卷积网络。据我所知那是第一个用梯度下降训练的现代意义上的神经网络,做手写数字识别。我当时就是想知道能不能把它现代化。多少功劳归算法?多少归数据?多少归算力和系统?我很快就把误差砍掉了一半,方法是把算法穿越三十三年。也就是说,把算法向后旅行三十三年,我就能改造杨立昆 1989 年做的东西,把误差减半。
卡帕西: 但要再往前走,我就必须加更多数据,把训练集扩大十倍,还得加上更多计算上的优化,用 dropout 和其他正则化手段训练更久。所以这些东西必须同时改进。我们大概会有多得多的数据,好得多的硬件,好得多的核函数和软件,也会有更好的算法。所有这些因素,几乎没有哪一个占压倒性优势,它们出奇地势均力敌。这个趋势已经持续很久了。
卡帕西: 所以回答你的问题:我预期算法上会和今天不一样。但我也预期,那些已经留存了很久的东西大概还会在。它大概仍然是一个用梯度下降训练的巨大神经网络。这是我的猜测。
主持人: 令人惊讶的是,所有这些加在一起,三十年的进步也只把误差减了一半。
卡帕西: 一半其实不少。因为误差减半,这意味着的东西……一半是很多了。
主持人: 让我震惊的是,每一样东西都得同时进步:架构、优化器、损失函数。
卡帕西: 而它们也确实一直在全面进步。所以我预期所有这些变化都还会活着,而且活得很好。
nanochat 怎么学
主持人: 我正想问你一个关于 nanochat 的很类似的问题。你刚把它写出来,造一个聊天机器人的每一步都还热在你的内存里。我好奇你是不是有类似的感受:从 GPT-2 走到 nanochat,没有哪一件事是唯一关键的。这次经历里有什么让你意外的收获?
卡帕西: nanochat 是我发布的一个代码库,昨天还是前天来着,我记不清了。
主持人: 从你的睡眠不足里能看出投入了多少。
卡帕西: 它想做的是最简单的完整代码库,端到端覆盖造一个 ChatGPT 克隆的整条流水线。所有步骤都在,不只是其中某一步,而那是一大堆步骤。过去我做过每一个单独的步骤,也发布过一些小代码,用简单的代码从算法意义上告诉你某一步怎么做。但这个处理的是整条流水线。
卡帕西: 至于收获,我不觉得我从中学到了什么新东西。怎么造它我脑子里本来就有。这只是机械地把它造出来,并且弄得足够干净,让别人能从中学到东西、觉得有用。
主持人: 别人学它最好的方式是什么?是把代码全删掉,从零重新实现,还是在上面做改动?
卡帕西: 好问题。它大概八千行代码,带你走完整条流水线。我可能会把它放在右边的显示器上。如果你有两块屏,就放右边。你要从头自己造,从最开始造。不许复制粘贴,可以参考,但不许复制粘贴。我大概会这么做。
卡帕西: 但我也觉得这个库本身是个挺大的怪兽。你写这种代码时不是从上往下写的,你是按块来写,再把块长大,而这个信息在库里是缺失的。你不会知道从哪儿下手。所以需要的不只是最终的代码库,还有代码库被造出来的过程,那是一个复杂的、按块生长的过程。那部分现在还没有。我很想这周晚点把它补上,大概是做个视频之类。粗略说,我会这么建议:自己造,但不许复制粘贴。
卡帕西: 我觉得知识几乎分两类。一类是高层的、表面的知识;而当你从零造一个东西,你会被迫面对你不懂的部分,还有那些你压根不知道自己不懂的部分。这总会带来更深的理解。这是唯一的造法。造不出来,就是没懂。我相信这是费曼的话。我一直非常强烈地相信这一点,因为总有无数微小的东西没被摆到正确的位置上,你其实并不掌握那个知识,你只是以为你掌握了。所以别写博客,别做幻灯片,别搞那些。写代码,把它排布好,让它跑起来。这是唯一的路。否则你就是缺着知识。
没写过的代码
主持人: 你发推说,编程模型在你组装这个库的过程中帮助非常有限。我很好奇为什么。
卡帕西: 这个库我大概写了一个多月。我会说现在人跟代码打交道大概有三大类方式。有些人彻底拒绝所有 LLM,全部手写。这大概已经不是正确的做法了。中间那一类,也就是我所在的位置,是你仍然大量手写,但会用这些模型提供的自动补全。你写出一小段,它就替你补全,你按一下就过去了。大多数时候是对的,有时不对,你就改。但你仍然是你写的东西的建筑师。然后是氛围编程:「嗨,请实现这个那个」,回车,让模型去干。那就是 agent。
卡帕西: 我觉得 agent 在非常特定的场景里是好用的,我也会在特定场景里用它们。这些都是你手上的工具,你得学会它们擅长什么、不擅长什么、什么时候该用。比如做样板代码,agent 相当好。那种复制粘贴式的样板代码,它们非常在行。凡是互联网上高频出现的东西,它们都很在行,因为训练集里有大量例子。有些类型的活它们干得非常好。
卡帕西: nanochat 不属于那一类,因为它是个相当独特的库。按我组织它的方式,代码量并不大,它不是样板代码,它几乎是智力密集型的代码,每一处都必须极其精确地摆放。而模型的认知缺陷太多了。举个例子,它们不停地误解我的代码,因为它们对互联网上那些典型写法的记忆太重,而我恰恰不采用那些写法。它们老是以为我在写常规代码,而我不是。
主持人: 能举个具体例子吗?
卡帕西: 你有八块 GPU 都在做前向、反向。它们之间同步梯度的常规做法,是用 PyTorch 的分布式数据并行(DDP)容器,它会在你做反向的时候自动开始通信、同步梯度。我没用 DDP,因为我不想用,因为没必要。我把它扔了,自己写了一个同步例程,放在优化器的 step 里。而模型一直想让我用 DDP 容器,它们非常担心。这就说得太技术了,但我不用那个容器是因为我不需要它,我有一个自定义的等价实现。它们就是没法把「你有自己的实现」这件事内化进去,怎么都过不了这道坎。
卡帕西: 它们还老是把风格搞乱。它们过度防御,到处加 try-catch,一门心思要把它写成生产级代码库,而我的代码里有一堆假设,这没关系,我不需要那些额外的东西。所以我觉得它们在给代码库注水,给复杂度注水,不停地误解,还反复用已经废弃的 API。一团糟。净收益是没有的。我可以进去收拾干净,但那不是净收益。
卡帕西: 我还觉得,把我想要的东西用英语打出来这件事本身很烦,打字太多了。如果我直接导航到代码里我要动的那个位置,去到我知道代码该出现的地方,敲出头几个字母,自动补全就懂了,直接把代码给你。这是一种信息带宽极高的表达方式:你指着代码该出现的地方,敲出前几个字符,模型就补完。
卡帕西: 所以我的意思是,这些模型在栈上的某些部分很好用。我用模型的两个例子挺有代表性。一个是我生成报告的时候,那比较样板化,所以那部分我部分地氛围编程了。那没问题,因为不是关键部分,跑得挺好。另一个是我用 Rust 重写分词器的时候。我 Rust 不太行,刚上手不久。所以写 Rust 那部分有一些氛围编程的成分。但我有一个我完全理解的 Python 实现,我只是在做一个更高效的版本,而且我有测试,所以那样做我心里更踏实。
主持人: 它们能提高你进入不熟悉的语言或范式的门槛。
卡帕西: 在那方面我觉得它们非常有帮助。世界上 Rust 代码很多,模型相当在行,而我恰好不太懂,所以模型在那里很有用。
主持人: 这个问题之所以这么有意思,是因为关于 AI 迅速爆炸并走向超级智能的主流叙事,正是 AI 自动化 AI 工程与 AI 研究。人们会看到 Claude Code 能从零做出整个应用、整套增删改查的程序,然后想:「如果 OpenAI、DeepMind 内部有同样的能力,想象一千个你、一百万个你并行去找那些细小的架构改进。」所以听你说这恰恰是它们相对最差的一块,很有意思。这对判断 AI 2027 那种爆炸会不会很快发生,是相当有分量的。
卡帕西: 你这么说很到位,这也正是我时间表更长的原因。你说得对。它们不擅长那种从来没被写过的代码,也许可以这么说。而那恰恰是我们造这些模型时要做的事。
主持人: 一个很外行的问题:你加到 nanochat 里的那些架构改动,在某篇论文里是有的吧?说不定某个库里也有。它们没法在你说「加上 RoPE 位置编码」的时候把它正确整合进来,这件事奇怪吗?
卡帕西: 这很难说。它们知道,但又不完全知道。它们不知道怎么把它完整地整合进你的库、你的风格、你的代码和你的位置,还有你在做的那些自定义的东西,以及它怎么和整个库的假设咬合。它们是有一些知识,但还没到能把它整合起来、理解它的地步。
卡帕西: 很多东西在持续变好。我现在会去用的最强模型是 GPT-5 Pro,那是个非常强的模型。如果我有二十分钟,我会把整个库复制粘贴过去,去问这个神谕一些问题。往往结果不差,跟一年前存在的东西比,好得让人意外。但总体上,模型还没到位。我觉得这个行业跳得太大了,还假装这已经很了不起,其实不是,就是些糊弄人的东西。他们不肯直面这一点,也许是为了融资吧。我不知道在发生什么,但我们正处在一个中间阶段。模型很惊艳,但还需要大量工作。眼下,自动补全是我的甜点区,不过对某些类型的代码,我会去找 agent。
自动化的滑杆
主持人: 还有一点让这件事很有意思。编程史上有过很多提升生产力的东西:编译器、代码检查、更好的编程语言,它们提高了程序员的生产力,但没有引发爆炸。那听起来很像自动补全这一类。而另一类是对程序员本身的自动化。有意思的是,你看到的更多是编译器那种历史类比。
卡帕西: 这也许牵出我另一个想法。我很难分清 AI 从哪儿开始、到哪儿结束,因为我从根本上把 AI 看作计算的延伸。从一开始起,我就看到一条递归自我改进、或者说加速程序员的连续谱:代码编辑器、语法高亮、甚至类型检查,所有这些我们为彼此造的工具。连搜索引擎也算。为什么搜索引擎不算 AI?排序就是 AI。谷歌在很早期就把自己看成一家做搜索引擎的 AI 公司,这完全说得通。
卡帕西: 我比别人更把它看成一条连续谱,很难划线。我觉得我们现在拿到了好得多的自动补全,也拿到了一些会打转的 agent,只是它们有时会脱轨。真正在发生的事情是,人类在逐步地做越来越少的底层工作。我们不写汇编了,因为有编译器,编译器会把我的高级语言 C 翻译成汇编。我们在非常非常缓慢地把自己抽象上去。我把这叫做「自主性滑杆」(autonomy slider):在任何时点上,能被自动化的东西里越来越多被自动化了,我们做得越来越少,在自动化之上把自己提升到更高的抽象层。
用吸管吸监督
主持人: 我们聊聊强化学习。你在推特上写过一些很有意思的东西。从概念上说,我们该怎么理解人类仅靠与环境互动就能建立起丰富的世界模型,而且这个过程似乎和一段经历末尾的最终奖励关系不大?如果一个人创业,十年后才知道公司成还是败,我们会说她攒下了大量的智慧和经验。但那并不是因为过去十年里每一件事的对数概率被调高或调低了。那里发生的事要审慎和丰富得多。对应的机器学习类比是什么?和我们今天在 LLM 上做的事比起来如何?
卡帕西: 我大概会这么说:如我刚才所言,人类不用强化学习,他们做的是别的事。强化学习比一般人以为的要糟糕得多。强化学习很糟。只不过在它之前我们有的东西更糟,因为之前我们只是在模仿人,那有一堆问题。
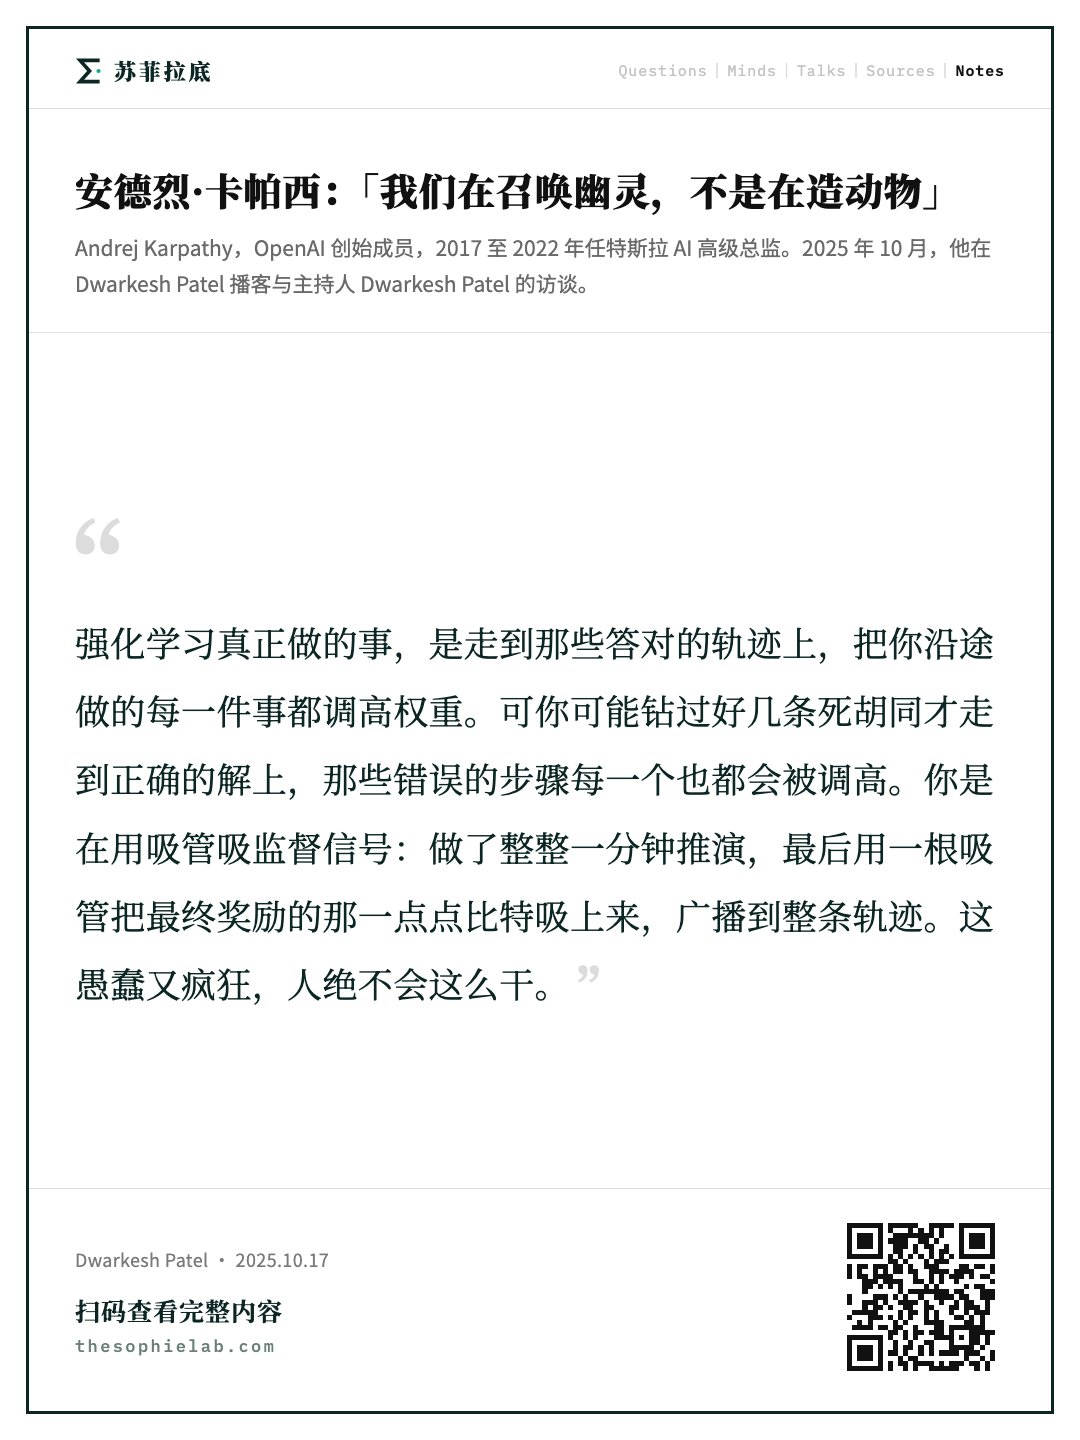
卡帕西: 在强化学习里,比如你在解一道数学题,因为这最简单。给你一道题,你要找出解法。强化学习会先并行地试很多东西。给你一道题,你试几百种不同的做法。这些尝试可以很复杂,可以是「我试试这个,试试那个,这个不行,那个也不行」等等。然后你也许得到一个答案。现在你翻到书后面,看到正确答案是这个。你会发现这几条路答对了,而另外九十七条没答对。强化学习真正做的事情,就是走到那些表现很好的轨迹上,把你沿途做的每一件事、每一个词元都调高权重:多做这个。
卡帕西: 问题在于,人们会说你的估计量方差很大,但说白了它就是噪声。它几乎是在假设,凡是通向正确答案的每一个小步骤都是对的做法,而这不成立。你可能钻过好几条死胡同才走到正确的解上。只要你最后走对了,那些错误的步骤每一个都会被调高权重,都变成「多做这个」。这太糟了,这就是噪声。你做了这么多工作,最后只拿到一个数:你答对了。基于这个数,你把整条轨迹整个地加权或减权。
卡帕西: 我喜欢的说法是:你是在用吸管吸监督信号。你做了可能整整一分钟的推演,然后你用一根吸管把最终奖励的那一点点比特吸上来,广播到整条轨迹上,用它来给这条轨迹加权或减权。这愚蠢又疯狂。人绝不会这么干。第一,人不会做几百次推演。第二,当一个人找到解法,他会有一个相当复杂的复盘过程:这几部分我做得不错,这几部分不太好,下次我大概该这样或那样。他们会把事情想一遍。现在的 LLM 里没有任何东西在做这件事,没有对应物。但我确实看到有论文开始往这个方向做,因为这对领域里所有人来说都是显而易见的。
卡帕西: 顺便说,最早的模仿学习本身是极其令人惊讶、堪称奇迹的,我们竟然能靠模仿人类来做微调。那太不可思议了。因为一开始我们只有基座模型,而基座模型就是自动补全。当时这对我并不显然,我是学来的。让我大脑炸掉的那篇论文是 InstructGPT,因为它指出:你可以拿预训练模型,也就是自动补全,只要用看起来像对话的文本微调它,模型就会飞快地适应,变得非常善于对话,而且保留了预训练里的全部知识。这让我震惊,因为我没意识到,仅仅几轮在那类数据上的微调,它在风格上就能调整得这么快,变成一个面向用户的助手。那对我来说太神奇了,太不可思议了。那是两三年的工作。
卡帕西: 然后强化学习来了。强化学习让你能比单纯的模仿学习做得好一点,因为你可以有奖励函数,可以在奖励函数上爬坡。有些问题就是有正确答案,你可以直接爬坡,不需要专家轨迹来模仿。这很了不起。模型还能发现人类可能永远想不到的解法,这很不可思议。但它仍然是愚蠢的,我们需要更多东西。我昨天看到谷歌有篇论文在试着实现这种复盘与反思的想法。
主持人: 是那篇记忆库的论文吗?
卡帕西: 不知道,我看到过好几篇这个路子的。所以我预期在这个领域会出现对 LLM 算法的重大更新。我觉得我们还需要三四个、五个这种级别的东西。
过程奖励为何难
主持人: 你太会造那种一击即中的说法了。「用吸管吸监督」,太妙了。你的意思是,结果导向的奖励的问题在于:你有一条巨长的轨迹,最后你却要从那一个比特里,学会关于该怎么做、该从世界里学到什么的所有事。既然这么显而易见,为什么过程导向的监督作为替代方案,一直没能把模型变得更强?是什么拦住了我们用这个范式?
卡帕西: 过程监督说的就是,我们不只在最末尾给一个奖励函数。你干了十分钟活,我不是等到最后才告诉你干得好不好,我在每一步都告诉你干得怎么样。我们之所以没有这个,是因为要做对很难。你面对的是部分解,你不知道怎么分配功劳。当你拿到正确答案时,那只是和标准答案做一次相等性匹配,实现起来非常简单。要做过程监督,你怎么以可自动化的方式做部分功劳分配?这并不显然。
卡帕西: 很多实验室在用 LLM 裁判来做。你让 LLM 来干,你给它一个提示词:「看看这个学生的部分解答,如果答案是这个,你觉得他做得怎么样?」然后去调这个提示词。这件事棘手的原因相当微妙。关键在于,只要你用 LLM 来给奖励,这些 LLM 就是有几十上百亿参数的庞然大物,而它们是可以被钻空子的。如果你对着它做强化学习,你几乎一定会为你的 LLM 裁判找到对抗样本。所以这事你不能做太久。你做十步、二十步也许还行,但你没法做一百步、一千步。我知道这不显然,但基本上模型会找到那些小裂缝。它会在这个巨大模型的犄角旮旯里找到各种伪相关,找到骗过它的路子。
卡帕西: 我印象很深的一个例子,这个大概已经是公开的了:如果你用 LLM 裁判做奖励,你把学生的解答喂给它,问它学生做得好不好。我们对着这个奖励函数做强化学习,一开始效果非常好。然后突然之间,奖励变得极其巨大,一个巨大的跳跃,满分。你看着它想:「哇,这意味着学生在所有问题上都完美,数学被彻底解决了。」可你去看模型生成的补全,全是胡话。开头还正常,然后就变成「dhdhdhdh」。你看着那些东西:「好吧,我们来算二加三,然后这样这样,然后 dhdhdhdh。」你看着它想,这太荒唐了,它怎么会拿到百分之百的奖励?
卡帕西: 你去看那个 LLM 裁判,结果发现「dhdhdhdh」对它来说是一个对抗样本,它给这东西赋了百分之百的概率。原因很简单,这对那个 LLM 来说是样本外的东西,训练时从没见过,你进入的是纯粹的泛化地带。在纯泛化地带里,你总能找到能把它搞崩的样本。你等于是在训练一个提示注入模型。其实连提示注入都算不上,那说得太花哨了,你只是在找对抗样本。这些是明显错误的、毫无意义的解答,但模型认为它们棒极了。
主持人: 如果你认为这是让强化学习更好用的瓶颈,那想自动化地做下去,就要求 LLM 成为更好的裁判。是不是会走成某种类似 GAN 的路子,得把模型训得更鲁棒?
卡帕西: 实验室大概都在干这些事。显而易见的做法是:「dhdhdhdh」不该拿百分之百。好,那就把「dhdhdhdh」放进 LLM 裁判的训练集,标成零分而不是满分。你可以这么做,但每次你这么做,你就得到一个新的 LLM,而它仍然有对抗样本。对抗样本是无穷多的。如果你这样迭代几次,找到对抗样本大概会越来越难,但我不敢百分之百确定,因为这东西有上万亿参数。我打赌实验室们在试。
卡帕西: 我仍然认为我们需要别的想法。
主持人: 有意思。那个别的想法大概长什么样,你有轮廓吗?比如某种复盘式的方案,它生成合成样本,你在上面训练之后变得更强,并且某种程度上把它元学习下来?
卡帕西: 我开始看到一些这类论文冒出来。我现在只停留在读摘要的阶段,因为很多论文只是想法。得有人在前沿实验室的规模上、以完全的通用性把它做成。你看这些论文冒出来,噪声挺大的。想法很酷,但我还没见到谁令人信服地证明这是可行的。话说回来,LLM 实验室相当封闭,谁知道他们现在在干什么。
合成数据会坍缩
主持人: 我能想象你怎么在自己造出来的合成样本或合成题目上训练。但人类似乎还做另一件事,也许睡眠是这个,也许做白日梦是这个,那不一定是编出假题目,而只是反刍。我不确定做白日梦或睡觉、或者单纯的回味,在机器学习里对应什么。最基础的类比无非是在反思产生的文本上微调,但我感觉实际上那大概效果不会太好。你对这件事的机器学习对应物有什么看法?
卡帕西: 我确实认为我们在那里缺了一些东西。举个例子,读书。现在 LLM 读书是什么意思?我们把一段文本拉成序列,模型预测下一个词元,从中获得一些知识。人类根本不是这么读的。我读书时,甚至不觉得书是我该去注意、该去训练的陈述材料。书是一组提示词,用来让我做合成数据生成,或者让你去读书会上和朋友们讨论它。是通过对那些信息的摆弄,你才真正获得了知识。
卡帕西: LLM 完全没有对应的东西,它们不做这件事。我很想看到预训练阶段里有一个环节,让模型把材料想一遍,试着和它已知的东西调和,花一些时间把它想透,并且真的让这件事work。现在完全没有对应物,这全是研究课题。这里面有一些非常微妙、我觉得很难理解的原因,让它并不简单。
卡帕西: 我可以描述其中一个:为什么我们不能直接生成合成数据然后在上面训练?因为每一个合成样本,如果我让模型对一本书做一次合成生成,你看一眼会觉得,这看起来很棒啊,为什么不能训?你可以试,但只要你继续这么干,模型会变得差很多。原因是,你从模型里采到的所有样本都在悄悄地坍缩。是悄悄地,你看任何单个样本都看不出来,但它们只占据了「关于某内容的全部可能想法」这个空间里极小的一块流形。LLM 输出的东西,我们说它是「坍缩」的,它有一个坍缩了的数据分布。
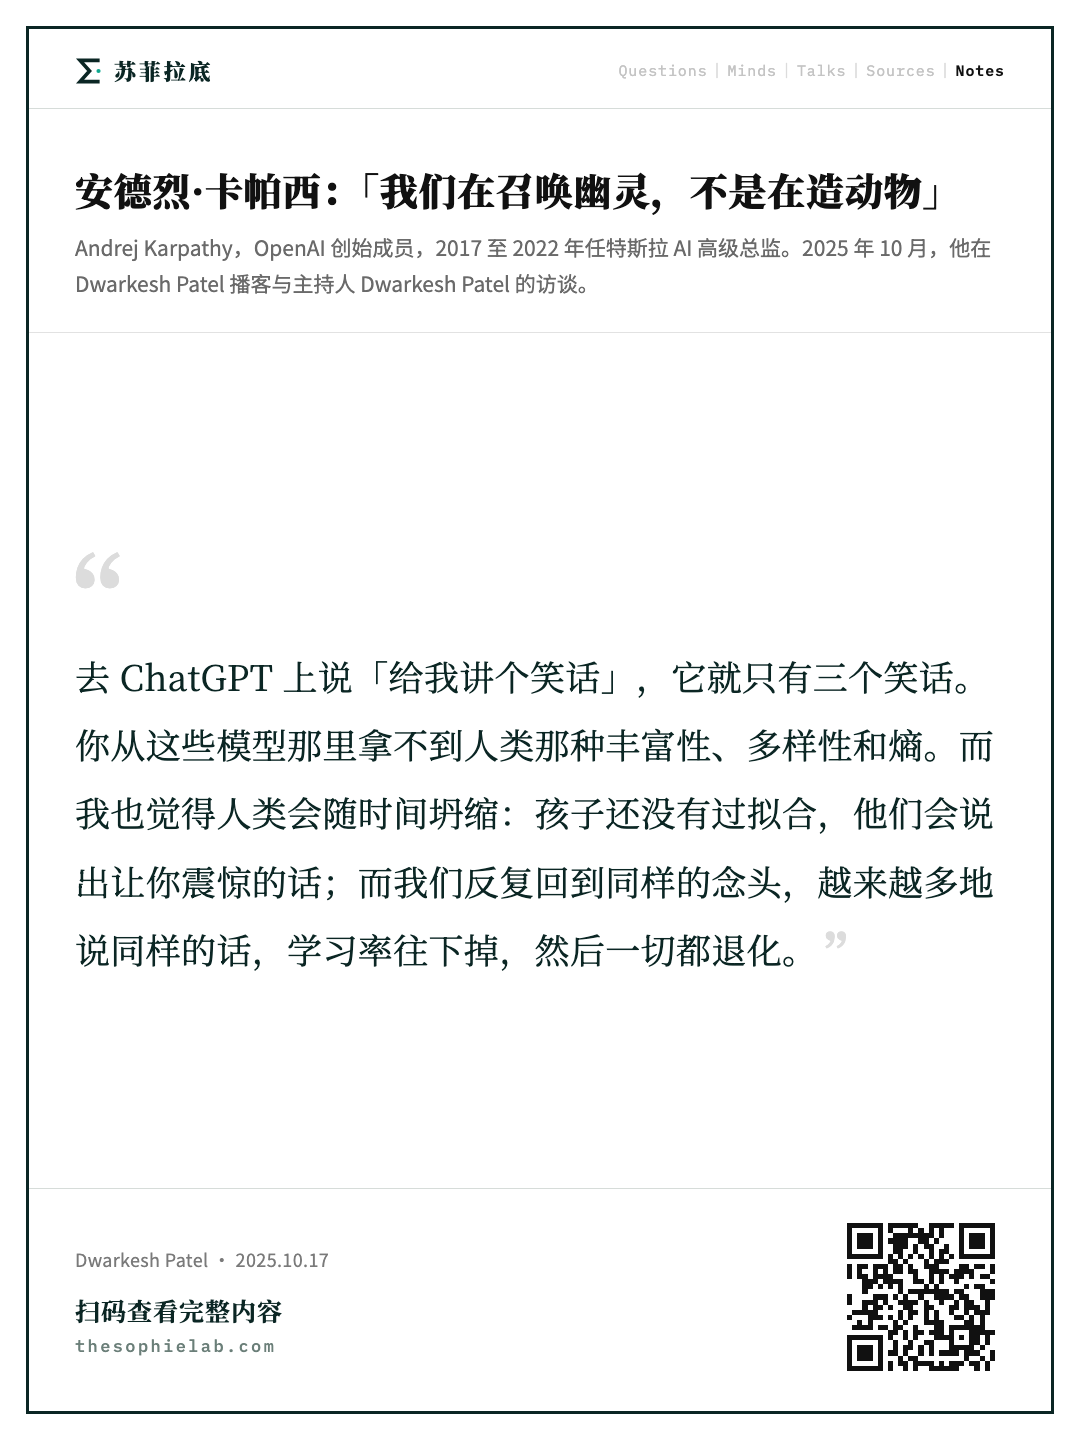
卡帕西: 一个很容易看出来的办法,是去 ChatGPT 上说「给我讲个笑话」。它就只有三个笑话。它不会把所有可能的笑话的广度给你,它只知道三个笑话。它们悄悄地坍缩了。你从这些模型那里拿不到人类那种丰富性、多样性和熵。人类噪声大得多,但至少人类没有偏,在统计意义上说。人类没有悄悄坍缩,人类维持着巨量的熵。所以,怎么在坍缩的情况下把合成数据生成做成,同时把熵保住?这是个研究问题。
主持人: 我确认一下我理解对了:坍缩之所以和合成数据生成有关,是因为你希望造出的合成问题或反思,不是已经在你数据分布里的东西?
卡帕西: 我想说的是,假设我们有书里的一章,我让 LLM 去想一想,它会给你一个看起来非常合理的东西。但如果我让它想十次,你会发现十次都一样。你没法在同样多的提示信息上不断扩大「反思」的规模,然后指望有回报。任何单个样本看起来都还行,但它的分布相当糟糕。糟糕到只要你继续在太多自己产出的东西上训练,你真的会坍缩。
卡帕西: 我觉得这可能没有根本性的解法。我也觉得人类会随时间坍缩。这些类比好得出奇。人在一生中是会坍缩的。所以孩子还没有过拟合,他们会说出让你震惊的话,你能看出他们从哪儿来的,但那就不是人们通常会说的话,因为他们还没坍缩。而我们坍缩了。我们反复回到同样的念头,越来越多地说同样的话,学习率往下掉,坍缩继续恶化,然后一切都退化。
主持人: 你有没有看到过那篇很有意思的论文,说做梦正是一种防止这种过拟合和坍缩的机制?做梦之所以在演化上是适应性的,就是要把你放进那些和你日常现实非常不同的古怪处境里,以防止这种过拟合。
卡帕西: 这想法很有意思。我确实认为,当你在脑子里生成东西、然后又去注意它,你就是在自己的样本上训练,在自己的合成数据上训练。干太久你就会脱轨,坍缩得太厉害。你必须一直在生活里寻找熵。和别人说话是很好的熵来源,诸如此类。所以也许大脑也内建了一些机制,用来提高那个过程里的熵。这想法很有意思。
孩子为什么记不住
主持人: 下面这个念头还很不成形,我就抛出来,你随便反应。我们所知最好的学习者是孩子,而孩子极其不擅长回忆信息。事实上在最早期的童年,你会把一切都忘掉,对某个年龄之前发生的一切完全失忆。但你极其擅长学新语言、从世界里学东西。也许这里有某种「见林不见木」的成分。反过来看谱系的另一端是 LLM 预训练,这些模型能一字不差地背出维基百科下一句是什么,但它们像小孩那样飞快掌握抽象概念的能力要有限得多。成年人在中间,他们没有童年学习的那种灵活性,但能以孩子做不到的方式记住事实和信息。我不知道这条谱系里是不是藏着什么。
卡帕西: 我百分之百觉得这里有非常有意思的东西。和 LLM 相比,人类身上确实有多得多的「见林」的成分。我们其实不太擅长记忆,而这恰恰是个特性。正因为我们记不住,我们被迫在更一般的意义上寻找模式。相比之下 LLM 极其擅长记忆,它们能背诵训练材料里的整段文字。你可以给它们完全没有意义的数据,比如把一段文本做个哈希,得到一个完全随机的序列,你训练一到两轮,它就突然能把整个东西背出来,它会记住。人不可能读一遍随机数字序列就背给你听。那是特性,不是缺陷,因为这逼着你只学那些可泛化的部分。而 LLM 被它们从预训练文档里带来的全部记忆干扰着,从某种意义上说,那对它们大概是非常分心的。
卡帕西: 所以当我谈认知内核时,我想拿掉的就是记忆,就是我们刚才说的那个。我希望它们的记忆更少,少到必须去查,它们只保留思考的算法、做实验的想法,以及行动所需的那些认知的黏合剂。
主持人: 这和防止模型坍缩也有关系吗?
卡帕西: 让我想想。我不确定,这几乎是另一条轴。模型太擅长记忆了,我们该想办法把它拿掉。人差得多,但那是好事。
主持人: 模型坍缩的解法是什么?有一些很朴素的招可以试,比如让 logits 上的分布更宽之类。朴素的做法最后的问题是什么?
卡帕西: 好问题。你可以想象给熵加一个正则项之类。我猜它们只是经验上效果没那么好,因为现在的模型就是坍缩的。但我要说,我们想让模型干的大多数活其实并不需要多样性。这大概才是真正的答案。前沿实验室在努力让模型有用。输出的多样性并不那么……第一,多样性更难处理、更难评估;第二,它也许并不是价值的大头所在。
主持人: 事实上它还被主动惩罚。你在强化学习里如果特别有创意,那不是好事。
卡帕西: 是的。或者如果你大量用 LLM 帮你写东西,那大概是坏事,因为模型会悄悄给你同样的东西,不会去探索回答一个问题的很多不同方式。也许因为需要多样性的应用不够多,模型就没有多样性。但到合成数据生成的时候,这就成了问题。所以我们其实在搬石头砸自己的脚,没有让熵在模型里留下来。也许实验室们该更努力一点。
主持人: 你好像暗示这是个非常根本的问题,不容易解决。你这个直觉从哪里来?
卡帕西: 我不确定它有多根本,我也不确定我想这么说。我没做过这些实验,但我确实认为你大概可以把熵正则化到更高,让模型给你越来越多不同的解法。但你又不希望它偏离训练数据太远,它会开始编自己的语言,开始用极其罕见的词,从分布上飘得太远。所以控制这个分布本身就很棘手,这个意义上它大概不是小事。
认知内核有多大
主持人: 如果非要你猜,智能的最优内核最后会有多少比特?就是我们要放进冯·诺依曼探测器里的那个东西,它得有多大?
卡帕西: 这在这个领域的历史里很有意思。曾经有一阵所有人都是「规模派」,说我们要造大得多的模型,万亿参数的模型。而模型的尺寸走势是先上去,现在又下来了。最先进的模型变小了。即便如此,我还是觉得它们记住的东西太多了。
卡帕西: 我以前有个预测:我几乎觉得我们能拿到十亿参数级别就很好的认知内核。如果你和一个十亿参数的模型对话,我觉得二十年后你能和它有一场非常有收获的交谈。它会思考,而且更像人。但如果你问它某个事实性的问题,它可能得去查,可它知道自己不知道,知道该去查,会把所有理智的事情都做对。
主持人: 你觉得要十亿参数,这让我意外。因为我们已经有十亿或几十亿参数的模型很聪明了。
卡帕西: 可最先进的模型是万亿参数级的,但它们记住的东西太多了。
主持人: 是,可我意外的是,按这个速度,十年之后……我们有 gpt-oss-20b,它比最初那个万亿参数级的 GPT-4 强得多。按这个趋势,你居然认为十年后认知内核还是十亿参数。我倒以为你会说「那会是几千万,甚至几百万」。
卡帕西: 问题在这儿:训练数据是互联网,而互联网真的很糟。而正因为它很糟,可改进的空间巨大。你我说到互联网,脑子里想的是《华尔街日报》,可它不是那个东西。当你在前沿实验室里看预训练数据集,随便翻一个网页文档,那是彻头彻尾的垃圾。全是股票代码、符号,来自互联网各个角落的海量废话和垃圾。我都不知道这玩意儿到底是怎么работ的。不是你想的《华尔街日报》文章,那种极其罕见。
卡帕西: 正因为互联网这么糟,我们才必须造非常大的模型把它压进去。而那些压缩里大部分是记忆的活,不是认知的活。可我们真正想要的是认知的部分,把记忆删掉。我想说的是,我们需要有智能的模型来帮我们提炼预训练集本身,把它收窄到认知的成分上。那样我觉得你能用小得多的模型,因为数据集好得多,你可以在上面训练。不过它大概不会直接在上面训,多半还是从一个更好的模型蒸馏出来的。
主持人: 那为什么蒸馏出来的还是十亿?
卡帕西: 我就是觉得蒸馏效果极好。几乎所有小模型,只要它是小模型,八成就是蒸馏来的。
主持人: 对,但为什么十年后蒸馏不会降到十亿以下?
卡帕西: 哦,你觉得应该比十亿还小?我不知道,我觉得做点有意思的事至少得要十亿个旋钮吧。你觉得还能更小?
主持人: 对。如果你看过去几年的趋势,从万亿参数级降到小两个数量级的模型,前后不过两年,性能还更好,这让我觉得智能的内核可能远远更小。用费曼的话说,底下的空间还大着呢。
卡帕西: 我本来觉得我说十亿参数的认知内核已经够反主流了,你比我还激进。也许我们能再小一点。不过我确实认为,实用地说,你希望模型带一些知识,你不希望它什么都去查,那样你就没法在脑子里思考了,你一天到晚都在查太多东西。基本的知识课程必须在,但不需要那些冷僻的知识。
前沿模型会变多大
主持人: 我们讨论的是认知内核可能是多大。另一个独立的问题是,前沿模型的尺寸随时间会怎么走?我好奇你有没有预测。我们看到规模一路涨到大概 GPT-4.5,现在看到的是下降或者持平。这背后可能有很多原因。往后看,最大的模型会更大、更小,还是差不多?
卡帕西: 我没有特别强的预测。实验室们只是在务实。他们有算力预算和成本预算,而事实证明,预训练并不是你最该投入算力和成本的地方。这就是模型变小的原因。它们是小了一些,预训练阶段小了一些,但他们在强化学习、中期训练以及之后的各个阶段补回来。他们只是在所有阶段之间做性价比最优的安排。要预测这个趋势相当难。我仍然预期还有大量低垂的果子,这是我的基本判断。我在这里的分布很宽。
主持人: 你预期那些低垂的果子在性质上和过去两到五年发生的事类似吗?如果我拿 nanochat 和 nanoGPT 比,看你做的那些架构改动,你预期继续发生的就是这个味道?你不预期什么巨大的范式转变?
卡帕西: 基本上是的。我预期数据集会好得多得多。你看现在的平均数据集,糟糕得离谱,糟到我都不明白这东西怎么会work。看看训练集里的平均样本:事实错误、笔误、不知所云的东西。不知怎么,一旦规模上去,噪声互相抵消掉了,剩下一点信号。数据集会大幅改善。所有东西都会变好:我们的硬件,跑硬件、榨干硬件的那些核函数。英伟达在慢慢地调硬件本身、张量核心,这一切都会继续发生。所有的核函数都会更好,把芯片用到极致。所有算法大概都会在优化、架构和建模的各个环节上改进,包括我们究竟在用什么算法训练。
卡帕西: 我确实预期没有哪一项占压倒地位。全都加百分之二十。这大致就是我一直看到的样子。
AGI 落进经济里
主持人: 人们提出过各种衡量我们离完整 AGI 还有多远的方式。只要你能画出一条线,就能看它和 AGI 在横轴上什么时候相交。有人提议用教育水平:先是个高中生,然后靠强化学习上了大学,接着要读博士。我不喜欢这个。也有人提议用任务时长:也许它能自主做一分钟的任务,然后是一小时,然后是人类要花一周的任务。你觉得这里相关的纵轴是什么?我们该怎么看 AI 的进展?
卡帕西: 我有两个回答。第一,我几乎想直接否定这个问题,因为我把它看成计算的延伸。我们讨论过怎么给计算的进展画图吗?从上世纪七十年代以来你怎么给计算的进展画图?纵轴是什么?从这个角度看,这问题本身就有点好笑。
卡帕西: 第二,当人们谈 AI,谈最初的 AGI,谈我们在 OpenAI 创立时说的那个 AGI,指的是这么一个系统:你可以把任何有经济价值的任务交给它,它做到人类水平或更好。那是当时的定义。我当时很满意这个定义,我一直沿用到今天,后来人们又发明了各种别的定义。但我喜欢那个定义。
卡帕西: 人们做的第一个让步,永远是把所有物理的东西拿掉,只谈数字化的知识工作。这相对于原来那个「人能做的任何任务」的定义,是一次相当大的让步。我可以搬东西之类,AI 显然不行,但这个让步我们接受了。那么只说知识工作,我们从经济里砍掉了多少?我不知道具体数字,如果让我猜,大概只有百分之十到二十是纯知识工作,是某个人可以在家里完成的那种活。即便如此,这也是个非常大的市场。美国经济规模有多大,它的百分之十或二十是多少?还是几万亿美元的市场份额或工作量。所以这仍然是个极大的盘子。
卡帕西: 回到定义上,我要看的是:这个定义在多大程度上成立?有没有一些工作,或者大量的任务?如果我们把单位看成任务而不是职业。这件事很难,因为社会会围绕哪些任务可自动化重新组合职业的构成。今天有哪些工作被 AI 替代了?最近一个好例子是辛顿预测放射科医生这个职业会消失,结果这在好几个方面都被证明大错特错。
卡帕西: 放射科医生活得好好的,人数还在增长,尽管计算机视觉在识别他们要在图像里识别的各种东西上真的非常强。那只是一份又乱又复杂的工作,有大量接触面,还要跟病人打交道,还有那一整套情境。按那个定义,我不觉得 AI 到现在为止已经砸出了多大的凹坑。
卡帕西: 我会盯着的那些工作,有一些特征使它们比别的工作更早适合自动化。比如呼叫中心的员工经常被提到,我觉得提得对。呼叫中心员工有一系列让今天的自动化变简单的性质。工作相当简单,它是一串任务,而每个任务看起来都差不多。你接一个人的电话,互动十分钟左右,也许更长。
主持人: 按我的经验,长得多。
卡帕西: 你在某个流程里完成一个任务,改几条数据库记录之类。你一遍遍重复同一件事,这就是你的工作。所以你希望任务时长这个维度是短的,同时你希望把上下文剥掉。你不需要和公司的不同服务部门或别的客户打交道,只有数据库、你和你服务的那个人。它更封闭,更可理解,而且纯数字。所以我会盯着这些特征。
卡帕西: 但即便在那里,我也不是在看完全的替代。我看的是一个自主性滑杆。我预期我们不会瞬间替换掉人。我们会换上做百分之八十工作量的 AI,把百分之二十的量委派给人,而人在监督着五个 AI 组成的小队去做那些更机械的呼叫中心工作。我会去找那些新界面或新公司,它们提供某一层,让你能管理这些还不完美的 AI。然后我预期这会在整个经济里铺开。
主持人: 很多工作比呼叫中心员工难多了。放射科医生那边我完全是瞎猜,我不知道他们的真实工作流是什么。但也许可以类比 Waymo 刚投放的时候,前排会坐一个人,你就是得有那个人在那儿,万一出大问题他能兜住。哪怕到今天,也还有人在盯着确保一切正常。刚部署的 Robotaxi 车里也还是坐着人。
主持人: 现在可能出现这样一种情形:如果你自动化了一份工作的百分之九十九,那最后百分之一必须由人来做的部分变得极其值钱,因为它卡住了其他一切。如果放射科医生的情况就像那个坐在 Waymo 前排的人,而那个人必须经过多年的专门训练才能提供最后那百分之一,他的工资就应该暴涨,因为他是唯一卡住大规模部署的环节。放射科医生的工资涨了,我想原因也类似:你是最后的瓶颈,而且你不可替代。Waymo 里的司机彼此之间大概是可替代的。
主持人: 所以你可能会看到这样一条曲线:你的工资一路涨到百分之九十九,然后在最后那百分之一被拿掉的瞬间,直线掉下去。我好奇放射科、呼叫中心员工的薪资上是不是在发生类似的事。
卡帕西: 有意思的问题。我不认为放射科现在正在发生这个。
卡帕西: 我觉得放射科不是个好例子。我不知道辛顿为什么挑放射科,因为我觉得那是个极其杂乱复杂的职业。我会对呼叫中心员工今天的情况更感兴趣,因为我预期很多机械的部分今天就该是可自动化的。我没有第一手数据,但我会去看呼叫中心员工那边的趋势。我还预期另一件事:也许他们确实换上了 AI,但我会再等一两年,因为我预期他们有可能往回撤,重新雇一些人回来。
主持人: 已经有证据表明,这在采用 AI 的公司里普遍发生了,我觉得挺出人意料的。我还发现另一件事很意外。AGI 嘛,一个什么都能干的东西。我们把体力活拿掉,但它应该能做所有知识工作。你天真地预期,这个推进过程会是这样:咨询顾问在做的一小块任务被拿走,会计在做的一小块任务被拿走,然后你在所有知识工作里都这么来一遍。可如果我们相信自己正走在通往 AGI 的路上,实际的推进完全不是这样。
主持人: 看起来顾问和会计并没有获得巨大的生产力提升,反倒是程序员的工作被一点点啃掉。如果看这些公司的收入,把和���歌那种类似的普通聊天收入剔掉,只看 API 收入,那是被编程压倒性主导的。所以这个本该能做任何知识工作的「通用」东西,压倒性地只在做编程。AGI 以这种方式落地,是挺让人意外的。
为什么先是编程
卡帕西: 这里有个有意思的点。我确实相信编程是这些 LLM 和 agent 最完美的第一块阵地。因为编程从根本上一直是围着文本转的。是计算机终端和文本,一切都建立在文本之上。而 LLM 在互联网上被训练出来,它们爱文本,它们是完美的文本处理器,外面还有海量的数据。天作之合。
卡帕西: 我们还为处理代码和文本预先搭好了大量基础设施。比如我们有 Visual Studio Code 或者你喜欢的任何 IDE 来显示代码,agent 可以直接插进去。如果 agent 做了修改产生了一个 diff,我们早就有一整套代码用 diff 展示一个代码库的全部变化。几乎可以说,我们已经为代码预先造好了很多基础设施。
卡帕西: 对比一下那些完全没有这种待遇的东西。比如有人想为幻灯片而不是代码做自动化。我见过一家做幻灯片的公司。那难多了。之所以难得多,是因为幻灯片不是文本。幻灯片是一些小图形,在空间里排布,还有视觉成分。幻灯片没有这些预先造好的基础设施。比如一个 agent 要改你的幻灯片,它怎么给你看 diff?你怎么看这个 diff?没有任何东西能显示幻灯片的 diff,得有人去造。所以有些东西并不适配今天这种作为文本处理器的 AI,而代码出人意料地适配。
主持人: 我不确定光靠这个能解释全部。我个人试过让 LLM 在纯语言进、语言出的领域里派上用场,比如改写文字稿、根据文字稿挑出片段。很可能我没有把所有可能的招都用上,我往上下文里放了一堆好例子,但也许我还该做点微调。
主持人: 我们共同的朋友安迪·马图夏克(Andy Matuschak)跟我说,他试了五百亿种办法让模型写出好的间隔重复提示卡。同样是彻头彻尾的语言进、语言出的任务,本该正中这些 LLM 的靶心。他试了带少样本示例的上下文学习,试了监督微调,试了检索。他就是没法让它们做出让他满意的卡片。所以我觉得很惊人,即便在语言输出的领域里,除了编程之外,也很难从这些模型身上榨出大量经济价值。我不知道怎么解释。
卡帕西: 有道理。我不是说凡是文本的东西就都简单。我确实认为代码是相当结构化的。文本大概要飘逸得多,文本里的熵大得多,我不知道还能怎么说。另外代码也难,所以哪怕只是简单的知识,人们也会觉得被 LLM 大大赋能了。我没有特别好的答案。显然文本让事情容易得多,但这不意味着所有文本都简单。
超级智能什么样
主持人: 你怎么看超级智能?你预期它在质感上和普通人类、和人类公司不同吗?
卡帕西: 我把它看成社会自动化进程的延续。沿着计算的趋势外推,会有大量东西被逐步自动化,超级智能就是那条曲线的外推。我们预期随时间会有越来越多自主的实体,先做大量数字工作,再过一段时间连物理工作也做。基本上,粗略地说,我把它看成自动化。
主持人: 但自动化包含的是人类已经能做的事,而超级智能暗示的是人类做不到的事。
卡帕西: 可人类做的事情之一就是发明新东西,我会把那也算进自动化里,如果这么说得通的话。
主持人: 那换个更不抽象、更偏质感的说法:因为这东西可以想得这么快,或者有这么多份拷贝,或者拷贝可以合并回自身,或者聪明得多,反正 AI 可能有的任何一种优势,那么这些 AI 所在的文明,在质感上会不会和人类的完全不同?
卡帕西: 我认为会。它本质上是自动化,但会极其陌生,会看起来非常古怪。就像你说的,我们可以把这一切跑在一个计算集群上,而且快得多。当世界变成那样时,让我开始紧张的一类情形,是对正在发生的事情逐步失去控制和理解。我认为这是最可能的结局,一种渐进的理解的丧失。我们会把这些东西一层层铺到各处,而理解它的人会越来越少。然后就是对正在发生的事情逐步失去控制和理解。在我看来,这是这一切最可能的走向。
主持人: 我在这里追问一下。我不觉得失去控制和失去理解是一回事。台积电、英特尔,随便哪家公司的董事会,都是一群有声望的八十岁老人。他们的理解非常有限,实际上也许也并不真的握有控制权。更好的例子是美国总统。总统拥有极大的权力,我不是要对现任者作什么评价,也许我就是,但理解的水平和控制的水平确实是两码事。
卡帕西: 这个反驳是公道的,很好。我想我预期的是两者都会丧失。
主持人: 为什么?失去理解是显然的,但为什么会失去控制?
卡帕西: 我们已经走到我完全不知道那是什么样子的地带了,但如果我来写科幻小说,它大概不会是某个单一实体接管一切,而是多个互相竞争的实体逐步变得越来越自主。其中一些走向失控,另一些去压制它们。这是一锅完全自主的活动的热汤,而我们把事情都委派给了它。我觉得会是这个味道。
主持人: 所以导致失控的并不是它们比我们聪明这件事,而是它们彼此竞争,以及那场竞争里长出来的东西。
卡帕西: 这些东西里有很多会是人的工具,是代表某个人在行动。所以也许那些人还握着控制权,但从社会想要的结果这个意义上说,整体仍然是失控的。你有一堆代表个体行动的实体,而它们整体上大致仍然处在失控状态。
这是不是智能爆炸
主持人: 这个问题我该更早问的。我们刚才说,现在做 AI 工程或 AI 研究时,这些模型更像编译器那一类,而不是替代品那一类。但如果有了 AGI,它应该能做你在做的事。你觉得一百万个你并行工作,会让 AI 的进展大幅加速吗?如果真发生了,你预期在有了真正的 AGI 之后会出现智能爆炸吗?我说的不是今天的 LLM。
卡帕西: 我预期会,但那只是照常营业,因为我们已经身处智能爆炸之中,而且已经几十年了。基本上就是 GDP 那条曲线,它是整个产业无数方面的指数加权和。一切都在被逐步自动化,而且已经这样几百年了。工业革命就是自动化,是物理环节的自动化、工具的制造,等等。编译器是早期的软件自动化。我们已经递归自我改进、已经爆炸很久了。
卡帕西: 换个角度看:如果你不看生物力学之类,地球曾经是个相当无聊的地方,长期看起来都差不多。从太空看,我们正处在一次鞭炮爆炸的当中,只是我们是在慢动作里看它。我确实觉得这件事已经发生很久了。再说一遍,我不把 AI 看成一项相对于已经发生很久的事情而言截然不同的技术。
主持人: 你认为它和这条超指数曲线是连续的?
卡帕西: 是的。这也是为什么这件事对我很有意思:我有一阵子一直想在 GDP 里找到 AI。我以为 GDP 应该往上跳。可后来我去看那些我觉得非常有变革性的技术,比如计算机、比如手机,你在 GDP 里找不到它们。GDP 就是同一条指数。连早期 iPhone 都没有应用商店,没有现代 iPhone 那些花样。所以尽管我们把 iPhone 问世的 2008 年想成一次巨大的地震式变化,实际上并不是。一切都摊得太开、扩散得太慢,最后全被平均进同一条指数里。计算机完全一样,你在 GDP 里找不到「哦我们现在有计算机了」的痕迹,因为那是极其缓慢的推进。
卡帕西: AI 也会一模一样。它只是更多的自动化。它让我们能写出以前写不出来的程序,但 AI 本质上仍然是程序。它是一种新的计算机,一种新的计算系统。但它有各种毛病,会随时间扩散,最后仍然加总成同一条指数。我们依然会有一条指数,而且会变得极其陡峭。生活在那样的环境里会非常陌生。
主持人: 你的意思是,如果看工业革命之前到现在的趋势,你会看到一条超指数:从百分之零的增长,到一万年前百分之零点零二的增长,到现在百分之二的增长。那是超指数。你是说把 AI 画上去之后,AI 会把你带到百分之二十或百分之二百的增长?还是说,如果看过去三百年,你看到的是一项技术接一项技术,计算机、电气化、蒸汽机、铁路等等,可增长率一直是同一个,百分之二?你是说增长率会上去吗?
卡帕西: 增长率也是大致恒定的,对吧?
主持人: 只在过去两三百年里是。但在整个人类历史尺度上,它是爆炸式的,从百分之零变得越来越快,工业革命一炸,到百分之二。
卡帕西: 有一阵我努力想在 GDP 曲线里找到 AI,最后我说服了自己这是假的。哪怕人们谈递归自我改进、谈实验室之类,那也是照常营业。它当然会递归自我改进,它一直在递归自我改进。LLM 让工程师更高效地去造下一轮 LLM,更多的环节被自动化、被调优。工程师能用谷歌搜索,这就是其中一部分。工程师有 IDE,有自动补全,有 Claude Code,这些都是同一个加速的一部分。它平滑得很。
主持人: 我再确认一下:你是说增长率不会变。智能爆炸表现出来的形式,就是它让我们得以继续待在百分之二的增长轨道上,就像互联网帮我们留在百分之二的轨道上一样。
卡帕西: 是的,我的预期是它保持同样的模式。
主持人: 那我把反面论证抛给你。我的预期是它会炸开,因为我认为真正的 AGI,我说的不是今天的 LLM 编程机器人,而是真正能替代服务器里一个人的东西,和别的提高生产力的技术有质的不同,因为它本身就是劳动力。我认为我们活在一个劳动力极度受限的世界里。你去问任何一个创业者、任何一个人,你最需要更多的什么?你需要真正有才华的人。如果你有几十亿多出来的人,他们在发明东西,把自己整合进经济,从头到尾把公司开起来,那和一项单一技术有质的不同。那相当于地球上多出一百亿人。
卡帕西: 也许可以这样反驳。比如说,计算就是劳动力。计算过去就是劳动力,很多工作消失了,因为计算机把一大堆数字信息处理自动化了,你现在不需要人来做。所以计算机就是劳动力,而那已经演完了。自动驾驶也是计算机在做劳动,那也已经在演了。但它仍然是照常营业。
主持人: 你有一台机器,它在以可能更快的速度吐出更多这样的东西。历史上我们有过增长体制切换的例子,从百分之零点二切到百分之二。对我来说,一台不断吐出下一辆自动驾驶汽车、下一个互联网的机器,很可能会造成同样的切换。
卡帕西: 我明白这想法从哪里来。但同时我确实觉得,人们做了这样一个假设:「我们有一个盒子里的神,现在它什么都能干」,而现实不会是那样。它能做一些事,在另一些事上会失败。它会被逐步放进社会,而我们最后仍然会得到同样的模式。这是我的预测。
卡帕西: 那种假设,突然之间我们有了一个完全智能、完全灵活、完全通用的人装在盒子里,可以拿去对付社会上任意问题,我不认为我们会有这种离散的跃变。我认为我们会走到同样的、在整个产业里渐进扩散的结局。
主持人: 这类对话里有个词常常造成误导。我不喜欢在这个语境下用「智能」这个词,因为「智能」暗示你觉得会有一个单一的超级智能坐在服务器里,凭空参悟出引发爆炸的新技术和新发明。我想象百分之二十的增长时,脑子里不是那个。我想象的是几亿甚至几十亿个非常聪明、类人的心智,而这也许就够了。关键在于,有几亿个、几十亿个,每一个都在做出新产品,自己琢磨怎么把自己整合进经济。如果一个经验丰富又聪明的移民来到这个国家,你不需要去想怎么把他整合进经济,他自己会搞定。他可以开公司,可以发明东西,可以提高世界的生产力。
主持人: 即便在当下这个体制里,我们也有过百分之十到二十经济增长的地方。如果你有很多人而资本相对稀缺,你就能有香港、深圳那样连续几十年百分之十以上的增长。有大量非常聪明的人准备好去利用资源,完成这段追赶,因为之前出现过断层。我觉得 AI 可能类似。
卡帕西: 我理解,但我仍然觉得你预设了某种离散的跃变,某种等着被兑现的解锁,然后突然之间数据中心里住满天才。我还是觉得你预设了一个离散跃变,而它没有我能找到的历史先例,在任何统计数据里我都找不到,我觉得它大概不会发生。
主持人: 工业革命就是这样一次跃变啊。你从百分之零点二的增长跳到百分之二的增长。我只是说会再来一次那样的跳跃。
卡帕西: 我有点怀疑,得再去看看。比如工业革命之前的记录质量不太好。我有点怀疑,但我没有强烈的看法。你是说这是一次极其神奇的单一事件,你是说也许还会有一次一模一样的、极其神奇的事件,它会打破范式,等等。而我其实不认为……
主持人: 工业革命的关键恰恰在于它并不神奇。如果你放大到 1770 年或 1870 年去看,你看不到某个关键发明。但与此同时,经济确实被推进了一个进展快得多的体制,那条指数翻了十倍。我预期 AI 也一样,不会有某个做出关键发明的单一时刻。
卡帕西: 也就是说,有一个存量被释放了。就像出现了一种新能源,出现了某种解锁,在这里是某种认知能力的解锁,而世界上堆着大量等着被做的认知工作。
主持人: 对。
卡帕西: 你预期这个存量会被这项新技术填上,一旦它越过某个门槛。
主持人: 也许可以这样想:纵观历史,很多增长来自人想出点子,然后有人去执行这些点子、做出有价值的产出。在这段历史的大部分时间里,人口一直在爆炸,那是增长的驱动力。过去五十年人们一直说增长停滞了,而前沿国家的人口也停滞了。我认为我们会回到人口的指数增长,从而带来产出的超指数增长。
卡帕西: 很难讲。我理解这个视角,但我直觉上没有这种感受。
智能演化有多偶然
主持人: 尼克·莱恩的书是你推荐给我的。看完之后我也觉得极其有意思,还采访了他。我有一些关于智能和演化史的问题。你做了二十年 AI 研究,对智能是什么、造出它需要什么大概有了更具体的感觉。因此,你对演化竟然自发撞上了智能这件事,是更惊讶了还是更不惊讶了?
卡帕西: 我很喜欢尼克·莱恩的书,来这儿的路上我还在听他的播客。就智能及其演化而言,它非常非常晚近。我对它居然演化出来了感到惊讶。
卡帕西: 我很喜欢想象外面那些世界。假设有一千颗像地球的行星,它们会是什么样子。尼克·莱恩在你这里谈过最早期的那些环节,他预期大多数行星上会有大致相似的生命形式,细菌那样的东西。中间有几处坎。智能的演化,直觉上我觉得应该是相当罕见的事件。
卡帕西: 也许可以按某样东西存在了多久来判断。如果细菌存在了二十亿年什么都没发生,那么走到真核生物大概相当难,因为细菌在地球演化史里出现得相当早。动物存在多久了?多细胞的、会跑会爬的动物,大概几亿年,那差不多是地球寿命的百分之十。在那个时间尺度上,也许它没那么难。但直觉上我仍然觉得智能的出现令人惊讶。我本来更预期会有一大堆像动物的生命形式做着像动物的事。你能得到一个创造文化、创造知识并把它们积累下来的东西,这让我惊讶。
主持人: 这里有几个有意思的追问。如果你接受萨顿的视角,认为智能的核心是动物智能,他的原话是「如果你能造出松鼠,你就走完了通往 AGI 的大部分路」。而我们在六亿年前寒武纪大爆发之后马上就有了松鼠级别的智能。促成那件事的似乎是六亿年前的大氧化事件。但智能的算法立刻就位了,足以造出松鼠那样的智能。这暗示动物智能就是那样的东西:只要环境里有了氧,有了真核细胞,算法就能拿到手。也许演化这么快撞上它是个意外,但我不确定这是否意味着,归根结底它其实相当简单。
卡帕西: 这类事情都太难判断了。你可以稍微依据某样东西存在了多久,或者某件事看起来被卡了多久。尼克·莱恩非常擅长描述细菌和古菌身上那个极其明显的瓶颈。二十亿年,什么都没发生。生物化学的多样性极其丰富,却没有什么长成动物。二十亿年。按你的说法,我不确定我们在动物和智能之间看到过完全对应的东西。我们也可以换个角度,看某种智能独立出现过多少次。
主持人: 这是个很值得研究的方向。关于这个我有个想法。有人科的智能,也有鸟类的智能。乌鸦之类极其聪明,但它们的脑区相当不同,和我们没多少共同之处。这稍微暗示了智能可能出现过好几次。如果是这样,你会预期它更常见。
主持人: 我之前的一位嘉宾格温(Gwern),还有卡尔·舒尔曼(Carl Shulman),在这点上提过一个很有意思的看法。他们认为人类和灵长类拥有的那个可扩展算法,在鸟类身上也出现了,也许还出现过别的次数。但人类找到了一个生态位,这个生态位会奖励智能的边际提升,同时又有一个可扩展的大脑算法能兑现这些提升。比如一只鸟如果脑子更大,它就会从天上掉下来。按脑子的尺寸算它非常聪明,但它不在一个奖励大脑变大的生态位里。
卡帕西: 有点像某些很聪明的……比如海豚?
主持人: 正是。而人类有手,这奖励了学会使用工具。我们还能把消化外包出去,把更多能量留给大脑,飞轮就转起来了。
卡帕西: 而且手边有东西可以摆弄。如果我是海豚,我猜这会更难。你怎么生火?在水里、水下能做的事情,从化学上说大概比在陆地上少。我同意生态位和激励这个视角。但我仍然觉得这不可思议。我本来会预期事情卡在「肌肉更大的动物」那一步。能穿过智能这个关口,是一个极其迷人的断点。
主持人: 格温的说法是,之所以这么难,是因为那是一条非常窄的线:一边是某件事重要到根本不值得把恰当的电路直接蒸馏回你的 DNA,另一边是它重要得不够,压根不值得学。
卡帕西: 它必须是能激励你去建立一个「一生之中学习」的算法的那种东西。你得激励出某种适应性。你需要不可预测的环境,好让演化没法把算法烤进你的权重里。很多动物在这个意义上是预烤好的。人类必须在出生之后、在测试时自己搞明白。你需要的是变化非常快的环境,快到你无法预见什么会管用,于是你造出智能,让它在测试时去搞明白。
主持人: 昆汀·波普(Quintin Pope)有篇很有意思的博客文章,他说他之所以不预期会有陡峭的起飞,是因为陡峭的起飞发生在人类身上:大约六万年前我们似乎就已经有了今天的认知架构。一万年前是农业革命,然后是现代性。那中间那五万年在干什么?你必须搭起一套文化脚手架,才能让知识跨代累积。而在我们做 AI 训练的方式里,这个能力是免费的。很多时候它们就是字面意义上的蒸馏。如果你重训一个模型,它们可以互相训练,可以在同一个预训练语料上训练,不必真的从零开始。所以人类花了很久才把这个文化循环转起来,但 LLM 的训练方式里它是白送的。
卡帕西: 是也不是。因为 LLM 其实没有文化的对应物。也许我们给了它们太多,反而让它们没有动力去创造文化之类。但文化的发明,文字记录的发明,人和人之间传递笔记,我不觉得今天的 LLM 里有对应的东西。LLM 现在没有文化,我认为这是一个障碍。
文化与自我对弈
主持人: 能给我描述一下 LLM 的文化可能是什么样吗?
卡帕西: 最简单的情形,是一个巨大的草稿本,LLM 可以编辑它。它一边读东西,一边帮人干活,一边为自己编辑这个草稿本。为什么一个 LLM 不能给别的 LLM 写一本书?那会很酷。为什么别的 LLM 不能读这个 LLM 写的书,被它启发,或者被它震动?这些东西现在一个对应物都没有。
主持人: 有意思。你预期这类事什么时候开始发生?还有多智能体系统,以及某种独立的 AI 文明和文化?
卡帕西: 在多智能体这个领域里,有两个强有力的想法都还没被认领。第一个我会说是文化,是 LLM 为自己的目的积累起一套不断生长的知识库。第二个更像自我对弈这个强大的想法。在我看来它极其强大。演化里有大量竞争在驱动智能和演化本身。在算法层面,AlphaGo 是和自己下棋,它就是这样把围棋下得极好的。
卡帕西: 现在没有自我对弈的 LLM,但我预期这个也应该存在,只是还没人做出来。比如为什么一个 LLM 不能出一堆题,让另一个 LLM 去学着解?然后出题的那个不断端出越来越难的题目,诸如此类。组织方式有很多种。这是一个研究领域,但我还没见过令人信服地把这两项多智能体改进拿下的东西。我们大体上还停留在单个个体智能体的层面,但这会变。文化这一块我也会把「组织」算进去,我们同样没有见过任何令人信服的东西。所以说我们还很早。
主持人: 你能指出阻碍 LLM 之间这种协作的关键瓶颈吗?
卡帕西: 我大概会这么说:有些类比本来不该成立,但不知怎么,它们出奇地成立。很多较小的模型,或者说较笨的模型,出奇地像一个幼儿园小朋友,或者小学生、中学生。不知怎么,我们还没毕业到这些东西能接手的程度。我的 Claude Code 或者 Codex,感觉仍然像小学生。我知道它们能做博士水平的测验,但它们在认知上仍然像幼儿园或小学的孩子。我不认为它们能创造文化,因为它们还是孩子,是天才儿童,对所有东西都有完美的记忆,能像模像样地生成各种看上去很好的糊弄货。但我仍然觉得它们并不真的知道自己在干什么,也没有那一格格还等着我们去收集的认知能力。
演示与产品之间
主持人: 你 2017 到 2022 年在特斯拉领导自动驾驶,亲眼看着它从很酷的演示,走到今天有成千上万辆车真的在自主行驶。为什么那花了十年?那段时间里发生了什么?
卡帕西: 我几乎要立刻反驳的一点是:这件事远远没有完成,我一会儿会从几个方面说。
卡帕西: 自动驾驶非常有意思,我的很多直觉肯定来自这里,因为我在上面花了五年。它有一整段历史,最早的自动驾驶演示可以一路追到上世纪八十年代。你能看到 1986 年卡内基梅隆的演示,一辆卡车在路上自己开。快进到我加入特斯拉的时候,我很早就体验过 Waymo 的演示。2014 年左右它给了我一次完美的行程,十年前就有一次完美的 Waymo 行程。它带我们在帕洛阿托转了一圈,因为我有个朋友在那儿工作。
卡帕西: 我当时觉得已经很近了,可后来它还是花了很久。对某些任务和职业来说,从演示到产品之间有一道非常大的鸿沟:演示很容易,产品很难。在自动驾驶这种失败代价太高的领域尤其如此。很多行业、任务和职业也许没有这个性质,但一旦你有了这个性质,时间表一定会被拉长。
卡帕西: 比如在软件工程里,我认为这个性质是存在的。对很多氛围编程来说不存在,但如果你在写真正的生产级代码,这个性质就该存在,因为任何一个错误都会导致安全漏洞之类,几百万、几亿人的社保号可能就泄露了。所以在软件里人们应该小心,就像在自动驾驶里一样。自动驾驶出事你可能受伤,还有更坏的结果。但在软件里,糟糕的程度几乎是没有上限的。我认为它们共享这个性质。
九的行军
卡帕西: 花掉大量时间的东西,以及该怎么理解这件事,是「九的行军」。每多一个九,就是一份恒定的工作量。每一个九都是同样的工作量。当你拿到一个演示,某个东西百分之九十的时候管用,那只是第一个九。然后你需要第二个九、第三个九、第四个九、第五个九。我在特斯拉的五年左右里,我们大概走过了两三个九。我记不清具体数字,但是好几个九的迭代。后面还有更多九要走。这就是为什么这些东西要花这么久。
卡帕西: 这对我确实是塑造性的,看着一个演示走到那里。我对演示非常不感冒。我看到任何东西的演示,都极其不感冒。如果那是别人特意做出来给你看的演示,那就更差。如果你能自己上手玩,会好一点。但即便如此,你也远没有完成。你需要的是真正的产品。它接触现实的时候会遇到所有这些挑战,会遇到各种需要打补丁的行为角落。我们会看到这一切一一上演。这是九的行军,每个九都是恒定的工作量。演示令人鼓舞,但要做的工作依然巨大。而这是一个关键安全领域,除非你做的是氛围编程,那当然轻松愉快。所以从这个角度,我的时间表也被加固了。
主持人: 听你说软件所需的安全保证和自动驾驶并无本质不同,这很有意思。人们通常会说,自动驾驶之所以这么久,是因为失败代价太高。人类平均每四十万英里、或者说每七年才犯一次错。如果你要发布一个至少七年不能出错的编程 agent,部署难度会大得多。但你的意思是,如果你每七年犯一次灾难性的编程错误,比如搞垮某个重要系统……
卡帕西: 那太容易发生了。事实上按墙上时钟算,会远远短于七年,因为你在不停地吐代码。按词元算也许是七年,但按墙上时钟算……
主持人: 某些方面这是个更难的问题。自动驾驶只是人类做的成千上万件事里的一件,几乎算一个单一垂直领域。而我们谈通用软件工程时,表面积要大得多。
主持人: 关于这个类比,人们还有另一个反驳:自动驾驶花掉的很大一部分时间,是在解决「具备稳健的基础感知」这个问题,是在建立表征,是在得到一个有点常识、能对稍微超出分布的东西泛化的模型。如果有人在路边这样挥手,你不需要专门为它训练,那东西会有某种理解知道该怎么反应。而这些今天我们从 LLM 或者视觉语言模型那里是白拿的,所以我们不必解决这些非常基础的表征问题。于是把 AI 部署到不同领域,就像把今天的自动驾驶汽车部署到另一个城市,很难,但不是一个十年的活。
卡帕西: 我不百分之百同意。我不知道我们究竟白拿了多少,对于我们到底拿到了什么,还有很多认识上的空白。我们确实在单个实体里拿到了更可泛化的智能,而自动驾驶是一个非常专用的任务。从某种意义上说,造一个专用的东西也许反而更难,因为它不是从你大规模在做的某个更一般的东西里掉出来的。但这个类比对我还是不完全成立,因为 LLM 仍然相当容易出错,仍然有大量缺口要填。我不认为我们真的开箱即得了什么神奇的泛化。
自动驾驶远未完成
卡帕西: 我还想回到另一面:自动驾驶汽车远远没有完成。部署量相当小。Waymo 之类的车非常少。他们之所以如此,粗略地说是因为不经济。他们造出了一个活在未来的东西,他们把未来拽了过来,但代价是让它不经济。那里有各种成本,不只是那些车的边际成本、运营和维护,还有整件事的资本开支。让它变得经济,对他们仍将是一场苦战。
卡帕西: 还有,当你看到这些车里没人开,我其实觉得这有点骗人,因为背后有非常精密的远程操作中心,有人在某种程度上和这些车处在同一个回路里。我不掌握全貌,但人在回路里的程度比你以为的要高。有人在天边某个地方连进来。我不知道他们是不是完全在驾驶回路里,有些时候是,但他们肯定是参与其中的,而且那是人。某种意义上说,我们并没有真的把人去掉,我们只是把人挪到了你看不见的地方。
卡帕西: 我仍然认为,像你说的,从一个环境换到另一个环境还有工作要做。要让自动驾驶成为现实,仍然有挑战。但我同意它确实越过了某个门槛,感觉上像是真的了,除非它其实是被远程操作的。比如 Waymo 不能去城市的所有地方,我猜是那些信号不好的地方。反正我对他们的技术栈一无所知,我是在瞎编。
主持人: 你在特斯拉领导了五年自动驾驶。
卡帕西: 抱歉,Waymo 的具体细节我确实不了解。顺便说,我很喜欢 Waymo,我经常坐。我只是觉得人们有时候对这些进展有点太天真了,要做的工作还非常多。在我看来特斯拉采取了一条可扩展得多的路线,团队做得极好。我对这件事会怎么走是留下过公开记录的。Waymo 起步早,因为你可以在车上塞进那么多传感器。但我确实认为特斯拉的策略更可扩展,未来会更像那个样子。
卡帕西: 所以这件事还得继续演下去,还没演完。我不想把自动驾驶说成一件花了十年的事,因为它还没走到头。一来起点是 1980 年而不是十年前,二来终点还没到。终点还远着,因为我们说自动驾驶时,我心里通常指的是规模化的自动驾驶:人们不必再去考驾照,等等。
算力是不是建多了
主持人: 我好奇再看两个这个类比可能不成立的地方。我对此格外好奇,是因为 AI 被部署得多快、早期阶段它有多大价值,可能是当下世界上最重要的问题。如果你想为 2030 年的世界建模,这是你必须有所把握的问题。第一,自动驾驶有延迟要求。我不知道实际模型多大,但我猜是几千万参数量级,而这对 LLM 做知识工作并不是必要的约束。也许在操作电脑之类上会有。
主持人: 但也许更重要的是资本开支这一点。是的,多服务一份模型拷贝有额外成本,但一次会话的运营成本相当低,而且取决于推理侧的规模化怎么走,你可以把 AI 的成本摊进训练本身。这和为多服务一个模型实例而造一整辆新车完全不是一回事。所以更广泛部署的经济账要有利得多。
卡帕西: 我认为这是对的。如果你停留在比特的世界里,比特比任何触及物理世界的东西容易一百万倍。这我完全承认。比特是可以任意改动、任意重排的,而且速度极快。你也该预期产业里的适应速度快得多。第一点是什么来着?
主持人: 延迟要求,以及它对模型尺寸的影响。
卡帕西: 我觉得那也大致对。不过我也认为,如果我们谈的是规模化的知识工作,实践上会有一些延迟要求,因为我们得造出并供给巨量的算力。
卡帕西: 最后一个我想很简短提一下的方面,是其余的一切。社会怎么看它?法律后果是什么?法律上怎么运转?保险上怎么运转?那些层面和方面是什么?「有人往 Waymo 上放个交通锥」在这里对应的是什么?所有这些都会有对应物。所以我觉得自动驾驶是个很好的类比,你可以从中借用很多东西。汽车里的交通锥对应什么?那个藏起来的远程操作员对应什么?所有这些方面。
主持人: 这对当前的算力建设意味着什么,你有看法吗?这轮建设会在一两年里把世界上可用的算力放大十倍,到这个十年末也许放大一百倍以上。如果 AI 的使用量低于一些人天真的预测,是不是意味着我们算力建多了?还是说这是另一个问题?就像铁路那样,或者说是电信业那样,九十年代末为十年后才来的互联网提前铺好了路,也吹出了一个泡沫。
卡帕西: 我知道我这里听起来非常悲观。其实我是乐观的。我认为这会成,我认为这是可解的。我之所以听起来悲观,是因为我一刷推特时间线,就看到一堆在我看来毫无道理的东西。这背后有很多原因,说实话很大一部分就是融资,是激励结构。还有一部分是注意力,是在互联网上把注意力变成钱之类。这种事很多,而我只是在对那些做反应。但我总体上对技术非常看多。
卡帕西: 我们会把这些问题一个个解决。进展的速度很快。我不认为存在建设过剩。我认为按我的理解,正在建的算力我们是能吃下去的。比如 Claude Code 或者 OpenAI Codex 之类,一年前压根不存在,对吧?这是一项一年前还不存在的奇迹般的技术。需求会非常巨大,我们已经在 ChatGPT 之类上看到了需求。所以我不觉得是建多了。
卡帕西: 我只是在对一些人反复给出的、错误的极短时间表做反应。在我做 AI 的这十五年里,我见过太多次非常有声望的人一次次搞错。我希望这件事被正确地校准,因为其中一些问题还有地缘政治后果之类。我不希望人们在那个层面上犯错。我确实希望我们对技术的实际能与不能保持清醒。
为什么做教育
主持人: 我们聊聊教育和 Eureka。你本可以再开一家 AI 实验室去解决那些问题。我好奇你现在在做什么,为什么不是 AI 研究本身?
卡帕西: 我大概会这么说:我对 AI 实验室在做的事有某种宿命感。我觉得我去那里能帮上忙,但我不确定我会带来独一无二的改进。我个人最大的恐惧,是这一切发生在人类的边上,而人类被它剥夺了力量。我在意的不只是我们、以及 AI 将会完全自主地建造的那些戴森球,我在意的是人会怎么样。我希望人类在未来过得好。
卡帕西: 我觉得在这件事上,我比在前沿实验室里做一点增量改进能贡献得独特得多。我最怕的是《机器人总动员》或《蠢蛋进化论》里那种景象,人类被晾在一边。我希望人类在那个未来里好得多得多。在我看来,这要通过教育来实现。
主持人: 那你具体在做什么?
卡帕西: 最容易的描述方式是,我们在造星际舰队学院。不知道你看没看过《星际迷航》。
主持人: 没看过。
卡帕西: 星际舰队学院是一所精英机构,做前沿技术,造飞船,把学员培养成这些飞船的驾驶员之类。所以我想象的就是一所面向技术知识的精英机构,一所非常跟得上时代的、第一流的学校。
主持人: 我有一类问题想问你,就是怎么把技术性或科学性的内容讲好,因为你是这件事上世界级的高手。我既好奇你怎么看待你已经放上 YouTube 的那些内容,也好奇在 Eureka 上你的想法有没有不同。
卡帕西: 关于 Eureka,教育里让我极其着迷的一点是,我确实认为有了 AI 在旁边,教育会发生相当根本的变化,它必须被重新接线、被改造。但我仍然觉得我们还很早。会有很多人去做那些显而易见的事:放一个 LLM 在那儿让人提问,把你现在靠提示词能做的基本操作都做一遍。那是有帮助的,但在我看来仍然有点糊弄。我想把它做对,而我想要的那种能力现在还不存在。我想要的是一种真正的家教体验。
一个好家教做了什么
卡帕西: 我脑子里很鲜明的一个例子,是我最近在学韩语。我经历过一个阶段,自己在互联网上学韩语。又经历过一个阶段,在韩国上小班课,和一堆人一起学,挺好玩的,一个老师带十来个人。然后我换成了一对一的家教。
卡帕西: 让我着迷的是,我想我遇到了一位非常好的老师。去想她为我做了什么,那体验有多不可思议,以及我最终想造的东西门槛有多高。仅仅通过一段很短的对话,她立刻就明白了我这个学生处在什么位置,我知道什么、不知道什么。她能精准地探出该问哪些问题、该看哪些东西,来摸清我的世界模型。今天没有任何 LLM 能百分之百替你做到这件事,差得远。但一个好的家教能做到。
卡帕西: 一旦她弄明白了,她就会把我在当前这一薄层能力上所需要的一切端给我。我必须始终被恰如其分地挑战,不能碰到太难的东西,也不能碰到太琐碎的东西,而好的家教特别擅长把恰到好处的东西端给你。我当时感觉,学习的唯一约束就是我自己。我总能拿到完美的信息,唯一的阻碍是我。我感觉很好,因为存在的唯一障碍就是我,而不是我找不到知识,或者它没有被讲清楚。那只是我记忆力之类的问题。我希望人们得到的就是这个。
主持人: 怎么把它自动化?
卡帕西: 非常好的问题。以现在的能力,你做不到。这也是为什么我认为现在还不是造这种 AI 家教的正确时机。我仍然觉得那是个有用的产品,会有很多人去造,但门槛太高了,能力还不到位。哪怕在今天,我也会说 ChatGPT 已经是一个极有价值的教育产品。但对我来说,看到那个门槛有多高,实在太震撼了。当我坐在她面前时,我几乎觉得我不可能造出这个东西。
主持人: 可你在造它,对吧?
卡帕西: 任何一个遇到过真正好家教的人都会想:「你打算怎么造出这个?」我在等那个能力到来。我做过计算机视觉方向的 AI 咨询,很多时候我给公司带来的价值,就是告诉他们别用 AI。我是那个 AI 专家,他们描述完问题,我说:别用 AI。这就是我的增值。我觉得教育现在也一样。就我心里想要的那个东西而言,时候还没到,但它会到。眼下我在造的是更常规一些的东西,有实体的部分,也有数字的部分。
主持人: 在你能说的范围内,今年或明年你希望发布的是什么?
卡帕西: 我在造第一门课。我想做出一门非常非常好的课,一个显而易见的、你要学 AI 就该去的最高水准的目的地。AI 只是我熟悉的领域,所以它是一个很好的起步产品,我可以把它做到真的很好。你刚提到的 nanochat,是 LLM101N 这门课的毕业设计,那门课我正在造,nanochat 是其中很重的一块。但现在我还得把大量中间环节搭起来,还要招一个小的助教团队,把整门课建完。
卡帕西: 还有一点我想说:很多时候人们想到教育,想到的是那种比较软的、传播知识的成分。我心里想的是非常硬、非常技术的东西。在我看来,教育是一个很困难的技术过程:为知识修坡道。在我看来 nanochat 就是一条通往知识的坡道,因为它非常简单,是极度简化的全栈版本。如果你把这个东西交给一个人,他一路读下去,他会学到大量东西。它给你的是我所谓的「每秒的顿悟数」,也就是每秒的理解量。这就是我想要的,大量的每秒顿悟。
卡帕西: 所以对我来说,这是一个技术问题:我们怎么高效地修出这些坡道,让人永远不会卡住,让一切永远不太难也不太琐碎,让你手上永远有恰好合适的材料往前走。从这个意义上说,我几乎觉得 Eureka 和某些前沿实验室、和那里正在进行的工作没有那么不同。
主持人: 你设想的短期版本是:与其让家教来探你的理解,不如你自己有足够的自我觉察去探自己,那样你就不会卡住。你可以在问助教、问 LLM 和看参考实现之间找到答案。听起来自动化或者 AI 并不是其中的重头。到目前为止,真正的超额价值来自你解释 AI 的能力,被固化在课程的原始材料里。
卡帕西: 课程本质上就是那个。你永远要校准到行业里现有的能力。很多人会去走「直接问 ChatGPT」那条路。但我觉得现在,你去 ChatGPT 说「教我 AI」,是不可能的,它会给你一堆糊弄的东西。AI 现在也绝不可能写出 nanochat。但 nanochat 是个非常有用的中间点。
卡帕西: 我是在和 AI 协作创作这些材料的,所以 AI 从根本上仍然非常有帮助。早些年我在斯坦福建过 CS231n,我想那是斯坦福第一门深度学习课,后来变得很受欢迎。当年做 231n 和现在做 LLM101N,差别相当鲜明。我觉得现在的 LLM 让我很有力量,但我非常深地在回路里。它们帮我造材料,我走得快多了,它们替我干掉很多无聊的活。我感觉课程开发得快多了,而且是被 LLM 浸润过的,但它还没到能创造性地生成内容的地步,那部分仍然得我来。棘手之处永远是把自己校准到现实存在的能力上。
主持人: 想象几年后 Eureka 能提供什么,最大的瓶颈似乎会是:在一个又一个领域里找到能把自己的理解转化成这种坡道的「卡帕西」。
卡帕西: 这会随时间变化。现在是招教员,让他们和 AI 以及一个团队手把手地合作,造出最高水准的课程。随着时间推移,也许一部分助教可以是 AI。你把全部课程材料喂进去,我觉得你能给学生提供一个非常好的自动助教,应付比较基础的问题之类。但我认为课程的整体架构、以及确保它咬合得上,还是需要教员。所以我能看到一条演进路径。也许在未来某个点上,我本人都不那么有用了,AI 在设计上比我做得好得多。但我仍然觉得那要过一段时间才会发生。
主持人: 你设想的是让其他领域的专家来贡献课程,还是说,鉴于你对怎么教有自己的理解,由你来设计内容是这个愿景的核心?萨尔·可汗(Sal Khan)给可汗学院所有视频配音,你想的是那种模式吗?
卡帕西: 不是,我会招教员,因为有些领域我不是专家。那是最终能给学生提供最高水准体验的唯一办法。所以我预期我会招教员,但我自己大概还会在 AI 这块待一阵。
卡帕西: 就当前的能力而言,我心里的东西比人们预期的要常规一些。当我造星际舰队学院时,我想象的大概是一所实体机构,下面一层是数字版。数字版不是那种最高水准的体验,最高水准的体验是有人全职来到线下,我们从头到尾一起过材料,确保你真的懂了。那是实体的部分。数字的部分是网上的一堆东西,也许配一个 LLM 助手,它会花哨一点、次一等,但至少八十亿人都能拿到。
主持人: 你基本上是在用今天可用的工具,从第一性原理重新发明大学,并且筛选出那些真有动力、真想跟材料较劲的人。
卡帕西: 将来需要的不只是教育,还有大量的再教育。我很想在那里帮上忙,因为工作大概会变化不少。比如今天很多人在努力补 AI 的技能,从这个角度说这是一门很值得教的课。
卡帕西: 至于动机,在 AGI 之前,动机很好解决,因为人们想赚钱,这是今天在这个行业里赚钱的方式。AGI 之后可能有意思得多:如果一切都自动化了,谁都没事可做,为什么还有人去上学?我常说,AGI 之前的教育是有用,AGI 之后的教育是好玩。就像今天人们去健身房。
后 AGI 时代的学习
卡帕西: 我们并不需要他们的体力去搬重物,因为我们有机器。他们还是去健身房。为什么去健身房?因为好玩,因为健康,因为有六块腹肌好看。从非常深的心理和演化意义上说,这对人类是有吸引力的。教育会以同样的方式演下去。你会像去健身房一样去上学。
卡帕西: 现在没那么多人学东西,因为学习很难。你会从材料上弹开。有些人能翻过那道坎,但对大多数人来说很难。这是一个技术问题。把我学韩语时那位家教为我做的事情做出来,这是个技术问题,是可解的、可造的,应该有人去造。它会让学任何东西都变得轻而易举,而且变得令人向往,人们会为了好玩去学,因为它轻而易举。如果我对任意一块知识都有那样一位家教,学任何东西都会容易太多了,人们就会去学,理由和他们去健身房一样。
主持人: 这听起来和……那么 AGI 之后,你把它当成娱乐或者自我提升。可你之前听起来还有另一个愿景,说这种教育关系到让人类保有对 AI 的控制。那是两回事。对一部分人是娱乐,对另一部分人是赋权?你怎么看?
卡帕西: 我确实觉得,长期来看这是一场必输的游戏。长期而言,这个长期比行业里大多数人考虑的要长,它是必输的。但我确实认为人可以走得非常远,而我们对一个人能走多远还只是刚刚触到皮毛。原因就是人们总是从太容易或太难的材料上弹开。人可以走得远得多。每个人都会说五门语言,为什么不呢?因为太容易了。每个人都会掌握本科的全部基础课程,等等。
主持人: 现在我理解这个愿景了,非常有意思。它在健身文化里有完美的对应。我不觉得一百年前有谁是肌肉分明的。没人能自发地卧推两片或三片杠铃片。而现在这很常见,因为有了系统训练和举铁这套观念,或者系统训练去跑马拉松,那也是大多数人不会自发拥有的能力。
卡帕西: 正是。
主持人: 你想象的是在很多不同领域里发生类似的事,更强、更深、更快地学习。
卡帕西: 没错。我确实隐含地押注于人性中某些永恒的东西。做这些事会是令人向往的,而且我认为人们会像几千年来一样敬重它。这一点会继续成立。历史上也有些证据。比如你看贵族,或者看古希腊,凡是出现过某种意义上「后 AGI」的小环境时,人们都会把大量时间花在某种意义的繁盛上,或者身体的,或者心智的。
卡帕西: 我对这个前景感觉还行。如果这是错的,如果我们最后落进《机器人总动员》或者《蠢蛋进化论》那样的未来,那我就算有戴森球也不在乎。那是个糟糕的结局。我是真的在意人类。每个人都必须在某种意义上变得超人。
主持人: 但在那个世界里,这些并不能让我们……有点像《文明》系列小说里的世界,对吧?你从根本上不可能靠自己的劳动或认知去改变技术的轨迹、去影响决策。也许你能影响决策,因为 AI 会来征求你的许可,但那不是因为我发明了什么,或者我想出了一个新设计,从而真正在影响未来。
卡帕西: 也许吧。我认为会有一个过渡期,在那段时间里,只要我们理解足够多的东西,就仍然能在回路里推动事情。长期来看,那大概会消失。
卡帕西: 它甚至可能变成一项运动。现在有力量举运动员在那个方向上走到极致。认知时代的力量举是什么?也许是那些真把「知道东西」这件事办成奥运会的人。如果你有一个完美的 AI 家教,也许你能走得极远。我觉得今天的天才也只是刚刚触到人类心智所能达到的皮毛。
主持人: 我很喜欢这个愿景。我还觉得,和你最有产品契合度的人就是我,因为我的工作就是每周都得学一个不同的学科,我非常期待。
卡帕西: 这一点我和你一样。很多人恨学校,一心想逃出去。我很喜欢学校,我爱学东西。我想留在学校,我一路留到博士,然后他们不让我再留了,我就去了工业界。粗略地说,我为了学习本身而爱学习,但我也因为学习是一种赋权、一种让自己有用和有产出的方式而爱它。
主持人: 你还说了一个很微妙的点,我想把它挑明。至今为止的在线课程,为什么没能让每个人都学会一切?因为它们太依赖动机了,没有明显的上手坡道,太容易卡住。如果换成那个东西,就像一位真正好的家教,那从动机的角度会是一次巨大的解锁。
卡帕西: 我想是的。从材料上弹开的感觉很糟。你投入了一段时间却没有结果,这会给你负奖励;或者因为拿到的东西太容易或太难而无聊透顶,也很糟。而当这件事被做对了,学习的感觉是好的。要走到那一步,是个技术问题。有一段时间里它会是 AI 加人的协作,某个时点之后,也许就是纯 AI 了。
物理学教会我什么
主持人: 我能问几个关于怎么教好的问题吗?如果要给另一个你感兴趣的领域里的教育者一些建议,让他们做出你做过的那种 YouTube 教程,你会说什么?也许特别有意思的是那些没法让人写段代码来检验理解的领域。
卡帕西: 这话题挺宽的。我大概有十到二十条半自觉在用的小技巧。但很多东西来自我的物理学背景,我真的非常享受物理学的训练。
卡帕西: 我有一整套观点,认为每个人在早期学校教育里都该学物理。因为早期学校教育不是为了积累知识、为了以后在行业里用的记忆,它是为了给大脑开机。而物理学独一无二地把大脑开得最好,因为学物理时它逼你在脑子里做的一些事,后来极其有价值。比如建立模型和抽象的观念;理解存在一个一阶近似能描述系统的大部分,而二阶、三阶、四阶项可能在也可能不在;理解你在观察一个噪声很大的系统,但其中有一些基本频率可以被抽象出来。
卡帕西: 当一个物理学家走进教室说「假设有一头球形的牛」,所有人都会笑,可这太高明了。这是极其高明、也极其可迁移的思维方式,因为一头牛在很多方面确实可以近似成一个球。比如有本很好的书叫《规模》(Scale),是一位物理学家在谈生物学,这也是我会推荐的书。你能得到很多非常有意思的近似,能给动物画出标度律。
卡帕西: 你可以看它们的心跳之类,它们和动物的体型能对上。你可以把一只动物当成一个体积来谈。你可以谈它的散热,因为散热是随表面积增长的,也就是随平方增长,而产热是随立方增长的。所以我就是觉得,物理学家拥有解决世界上各种问题所需的全部认知工具。
卡帕西: 正因为这套训练,我总在寻找一切事物的一阶项和二阶项。当我观察一个系统或一个事物时,我脑子里是一团缠绕的想法和知识的网,我要找的是:什么是真正要紧的?什么是一阶成分?我怎么把它简化?我怎么能有一个最简单的东西,把那件事展示出来、让它跑起来,然后再把其他项加回去?
卡帕西: 我自己的库里有个例子挺能说明这一点,叫 micrograd。micrograd 是一百行代码,展示反向传播。你可以用加法、乘法这类简单运算搭出神经网络,那是神经网络的乐高积木。你建起一张计算图,做一次前向、一次反向,拿到梯度。而这是所有神经网络学习的核心。所以 micrograd 是一百行相当可读的 Python 代码,能对任意神经网络做前向和反向,只是不高效。
卡帕西: 所以这一百行 Python,就是理解神经网络如何训练所需要的全部。其余一切都只是效率。其余全是效率。要做到高效有海量的工作:你需要张量,你要排布它们、设置步长,你要确保你的核函数正确地编排内存搬运,等等。粗略地说,那全是效率。但神经网络训练在智识上的核心就是 micrograd,一百行,你很容易就能读懂。它是链式法则的递归应用,用来求出梯度,从而让你能优化任意可微函数。
卡帕西: 所以我喜欢找到这些低阶项,把它们端到盘子上,把它们发现出来。我觉得教育是智识上最有意思的事,因为你手上有一团缠绕的理解,你要把它铺开,铺成一条坡道,让每一样东西都只依赖它前面的东西。这种把知识解缠的过程,作为一项认知任务实在太有意思了。我个人非常享受,我对把事情按某种方式铺开这件事有种痴迷。也许这就是帮到我的地方。
先给痛,再给药
主持人: 这也让学习体验变得有动机得多。你那期讲 Transformer 的教程,是从二元组开始的,字面意义上就是一张查找表:这是当前这个词,这是前一个词,这是下一个词,就是一张表。
卡帕西: 精髓就在那儿。
主持人: 这太妙了,从一张查找表开始,一路走到 Transformer。每一块都有动机。你为什么要加那个?你为什么要加下一样东西?你可以去背注意力的公式,但理解每一块为什么相关、它解决什么问题,完全是两回事。你是在给出解法之前先呈现痛点,这多聪明。
卡帕西: 你要带着学生走完那个递进。另外还有很多小细节让它变得好看、有意思、有参与感。要不断向学生发问。有很多这样的小事很重要,很多好的教育者都会这么做。你会怎么解决这个?我不会在你猜之前就把解法给你,那太浪费了。在你有机会自己试一把之前就把答案端给你,那有点……我不想骂人,但那是对你的一种不厚道。因为如果你自己试着想,你会更好地理解动作空间是什么、目标是什么,然后才明白为什么只有这个动作能达成那个目标。你有机会自己试过,我再给你解法时你才有体会。这让每增加一个新事实所带来的知识量最大化。
主持人: 你觉得为什么默认情况下,真正的领域专家常常讲不清给一个刚入门的人听?
卡帕西: 这是知识和专长的诅咒。这是真实存在的现象,我自己也深受其害,尽管我尽力避免。你会把某些东西当成理所当然,你没法把自己放进一个刚起步的人的处境里。这非常普遍,我身上也会发生。
卡帕西: 有一件事极其有用。举个例子,最近有人想给我看一篇生物学论文,我立刻就有一堆很蠢的问题。我的做法是,把论文放进上下文窗口,用 ChatGPT 去问那些问题,它帮我理清了一些简单的东西。然后我把整段对话分享给写那篇论文、做那项工作的人。我觉得如果他们能看见我那些蠢问题,也许能帮他们以后讲得更好。对我自己做的材料,我也很希望人们把他们和 ChatGPT 之间那些傻乎乎的对话分享给我,因为那真的能帮我重新站到一个初学者的位置上。
主持人: 还有一个招,效果好得惊人。如果有人写了一篇论文、一篇博客、一则发布,百分之百的情况下,他们在午饭时向你口头解释那件事的转录稿,不仅更好懂,而且实际上更准确、更科学。因为人们有一种倾向,要用最抽象、最堆术语的方式写东西,还要清四段嗓子才讲到核心。但和一个人面对面交流有某种东西,逼着你把话直接说出来。
卡帕西: 就把话说出来。我看到那条推文了,我觉得太对了,还转给了一堆人。我注意到这件事很多很多次。最鲜明的例子是我读博做研究的时候。你读某人的论文,费劲去弄懂它在干什么。然后你在会议上碰到他们,一起喝啤酒,你问:「你这篇论文到底在做什么?这论文讲的是什么?」他们会用三句话完美地抓住这篇论文的精髓,把想法彻底讲明白。你根本不用读那篇论文。只有当你和他们坐在桌边喝着啤酒时,他们才会说:「哦,这篇论文就是,你拿这个想法,拿那个想法,做这个实验,再试一下这个东西。」他们有办法用口语把它讲得刚刚好。
主持人: 那为什么那不能是摘要?
卡帕西: 正是。
学生该怎么学
主持人: 刚才是从「想解释一个想法的人该怎么组织表达」这个角度说的。那从学生的角度,如果你身边没有一个卡帕西来做讲解,你在读某人的论文或某本书,你会用什么策略去学一个你感兴趣但并不精通的领域?
卡帕西: 老实说,我不觉得我有什么独门秘诀,这是个痛苦的过程。一直对我帮助不小的一点,我发过一条相关的推文,是按需学习很好用,也就是纵深式地学。
卡帕西: 我确实觉得你需要在两种学习之间交替。一种是纵深式的、按需的,你在冲某个具体项目,能从中拿到奖励。另一种是广度式的,就是「好吧,先把某某 101 过一遍,这些是你以后可能需要的东西」。学校做的很多是广度式学习:「相信我,你以后会用到的。」好吧,我信你,我学,因为我猜我需要它。但我喜欢的是那种做成一件事能拿到回报、按需学的学习。
卡帕西: 另一件我发现极其有用的事,这一点上教育有点利他的意味,是把东西讲给别人听,那是把一样东西学得更深的绝妙方式。这在我身上一直发生。别人大概也一样,因为我发现,如果我并没有真的懂某样东西,我就讲不出来。我一边讲一边意识到:哦,这个我不懂。要面对这一点很烦人。但你可以回去确认自己真的懂了,它会填上你理解里的这些窟窿,逼着你面对它们、把它们弥合。
卡帕西: 我喜欢反复地重新讲一遍东西,人们也应该多这么做。那逼着你去摆弄知识,确保你在讲的时候知道自己在讲什么。
主持人: 这是个绝佳的收尾。安德烈,聊得太好了,谢谢你。
一句话概括
Andrej Karpathy 认为当前的 LLM 不是"造动物"而是"召唤幽灵"——靠模仿互联网文本得到的数字灵体,虽已惊人但在认知上仍严重残缺,真正可用的 agent 需要十年而非一年;他本人正转向教育(Eureka / Starfleet Academy),因为他相信 AI 的扩散会是缓慢、连续、被并入既有指数曲线的过程,而人类在其中的处境才是更值得下注的问题。
核心要点
- "agent 的十年"是对"agent 之年"的直接反驳,理由是可雇佣性而非能力演示。 判断标准是"你会不会像雇实习生一样把活交给它":今天不会,因为它不够聪明、多模态不足、不会用电脑、没有持续学习(你告诉它的事它记不住)。这些缺口按他 15 年从业经验外推平均下来大约是十年。
- 历史上 AI 反复犯"太早去做完整 agent"的错。 2013 年前后的 Atari 深度强化学习、以及他自己在 OpenAI Universe 项目里做的键鼠操作网页的 agent,都是在没有表征能力的前提下硬上:奖励过于稀疏,纯靠乱点乱敲"烧掉一片森林的算力"也学不出来。今天的 computer-use agent 之所以行,是因为下面先垫了一个语言模型。
- 预训练是"廉价版进化",产物是幽灵不是动物。 斑马出生几分钟就能跟着母亲跑,那不是 RL 而是进化写死在 ATCG 里的东西;我们不跑进化这套流程,所以不要拿动物打比方。预训练同时干了两件不相干的事:塞进知识、以及在网络里长出 in-context learning 这类算法电路。他想要的是剥掉知识、只留"认知内核"(cognitive core)。
- 知识记得太牢反而是缺陷。 模型能把随机哈希串训一两轮就整段背出来,人做不到——而人做不到恰恰是 feature,逼人只学可泛化的部分。模型则被预训练记忆"分心",尤其不擅长走出互联网数据流形之外。他猜十亿参数级的认知内核在 20 年后就能有很深的对话能力,事实性问题去查即可;主持人则认为可能远小于十亿,他表示可以被说服。
- 权重是"朦胧回忆",上下文是"工作记忆",两者信息密度差 3500 万倍。 Llama 3 用 15T token 训 70B 模型,约合每 token 沉淀 0.07 bit;而 KV cache 每多一个 token 约增加 320KB。这解释了为什么把整章书塞进上下文问,效果远好于凭记忆问。他还指出有论文显示 in-context learning 内部可能在跑某种梯度下降(线性回归任务中在注意力层里找到了梯度下降式机制)。
- RL 是"用吸管吸监督信号"。 一道数学题并行跑几百条 rollout,对照答案发现 3 条对、97 条错,于是把对的那几条里的每一个 token 全部上调权重——哪怕中间走了一堆死胡同。人类绝不会这么干:人会复盘"哪段做得好、哪段不好"。而过程监督(process supervision)难在自动化的部分信用分配:用 LLM 当裁判就会被攻破,他亲历过奖励突然暴涨到满分,一看输出是"dhdhdhdh"这类对抗样本,判分模型给了 100%。修补一个就冒出新的,对抗样本是无穷的。
- 合成数据的死穴是"静默坍缩"。 让模型反思一章书,单看每个样本都很好,但问 10 次得到的是同一坨东西——分布占据了极小的流形。ChatGPT 的"讲个笑话"只有三个笑话就是例证。人类更吵但至少无偏、保有熵。他补充人也会随年龄坍缩(小孩没过拟合所以语出惊人),并对"做梦是为了防止过拟合"的论文表示有意思。坍缩没被认真解决,部分原因是前沿实验室的任务并不需要多样性,RL 里过于有创造性甚至会被惩罚。
- 模型对"没被写过的代码"格外无力,这直接拉长了他的时间线。 写 nanochat(约 8000 行、覆盖 ChatGPT 全流程)时他基本只用自动补全:模型反复不理解他没用 PyTorch DDP 而是自己在 optimizer step 里写了梯度同步,硬要他用回 DDP;还狂加 try-catch、往生产级代码靠、用弃用 API,"净收益是负的"。只有生成报告(样板)和写 Rust 分词器(他不熟但网上代码多、且有 Python 参考实现和测试)时他才放手让模型做。这恰好是"AI 自动化 AI 研究导致智能爆炸"叙事所依赖的能力。
- 进步是全面小幅推进,没有单点主导。 他复现 Yann LeCun 1989 年的卷积网络,只把算法穿越 33 年就把误差减半,但再往下必须同时加 10 倍数据、加算力与正则化。十年后他仍押注"用梯度下降训练的巨大神经网络",只是更大、数据更好、kernel 更好——"每样 +20%"。
- 自动驾驶给出的是"九的长征"教训。 1986 年 CMU 就有 demo,他 2014 年坐过一次完美的 Waymo,Tesla 五年只推进了两三个"9",每多一个 9 都是等量的工作。而且这事远没完成:部署量小、不经济(含整体 capex),无人驾驶的车背后还有远程遥控中心的人——"我们没有去掉人,只是把人挪到你看不见的地方"。他认为生产级软件同样是"失败代价极高"的领域(安全漏洞、数据泄露),所以共享这个属性。
结论与值得注意的细节
- 他拒绝"智能爆炸"是离散事件的设定:AI 就是计算的延续,编译器、搜索引擎、排序都算 AI;递归自我改进已经持续了几百年。计算机和 iPhone 在 GDP 曲线上都找不到拐点,因为扩散太慢、被平均进同一条指数。主持人反驳工业革命正是 0.2%→2% 的增速换挡、AGI 相当于凭空多出几十亿劳动力;Karpathy 承认可被说服,但坚持"不会有盒子里的神",会是渐进弥散。
- 他最担心的不是被更聪明的 AI 支配,而是渐进失去理解与控制:多个自主实体互相竞争、有的失控、其他的去围剿,形成一锅无人真正理解的自主活动。主持人指出"失去理解"与"失去控制"未必等同(美国总统理解有限但权力极大),他接受这一质疑但认为两者都会丢。
- 编程被优先自动化是基础设施决定的:代码天然是文本、数据量大,且 IDE、diff 等展示与校验设施早已建好;而幻灯片是空间化图形,连"怎么给你看 diff"都没人做。但他也承认这不足以解释全部——主持人和 Andy Matuschak 在纯文本任务(改写转录、生成间隔重复卡片)上试遍 few-shot、SFT、检索仍不满意。
- "AGI"的定义在悄悄缩水:OpenAI 早期定义是"任何有经济价值的任务达到人类水平",如今默认砍掉所有物理工作,只剩知识工作——他估计那只占经济的 10%~20%(在美国仍是数万亿美元)。他预期的落地形态是"自主度滑杆":AI 干 80% 的量,20% 交给人,一个人监督五个 AI,并期待出现管理这些不完美 AI 的新界面和新公司。他认为 Hinton 拿放射科医生举例选错了对象(该职业依旧兴旺),呼叫中心才是更好的观察指标,且要留意一两年后企业回头重新招人的现象。
- LLM 缺"文化"和"自我对弈"两块:没有 LLM 写书给别的 LLM 读、没有代代累积的笔记,也没有 AlphaGo 式的自对弈(比如一个 LLM 不断给另一个出更难的题)。他认为现有模型"认知上像幼儿园或小学生,只是记忆力超群的学者症候群儿童",还造不出文化。
- 关于对 AI 泡沫的态度:他强调自己整体看多,"没觉得算力在过度建设"(Claude Code、Codex 一年前还不存在),他只是在反击时间线上的过度承诺——那背后很多是融资和注意力变现的激励,而且这类误判有地缘政治后果。
- 教育才是他下注的地方:Eureka 想做"星际舰队学院",先做一门顶级 AI 课(LLM101n,nanochat 是其毕业项目),未来招 faculty、让 AI 先承担助教角色。他定义教育是一个硬技术问题——搭建"通往知识的坡道",让每一步只依赖前一步,最大化"每秒顿悟数"。关键参照是他学韩语时的一对一老师:几句话就摸清他的世界模型,永远只喂刚好难度的内容,让他自己成为唯一的瓶颈;他坦言现有 LLM 远达不到这个标准,所以现在做的东西"比人们预期的更传统",含实体校园。
- 教学与学习的具体方法论:物理训练出的"先找一阶项、球形奶牛式近似"是他的核心思维工具;micrograd 的 100 行代码就是神经网络训练的全部智识内核,其余都是效率问题。讲 transformer 从 bigram 查表开始,先呈现痛点再给解法,且绝不在学习者尝试之前抛出答案。专家讲不清是"知识的诅咒"——他建议把自己问 ChatGPT 的蠢问题分享给作者。以及那个屡试不爽的观察:作者在酒桌上用三句话讲清的论文,比论文本身更准确也更好懂,"那为什么那不是摘要?"

追问一个大问题。 苏菲拉底的每周来信,写这一周在追问的问题和看到的回应。
 微信公众号