
Rich Sutton and Khurram Javed: Why AI Models Stop Learning, and How to Start It Again
节目发布 2026-08-18 · Sequoia Capital
编者按:本文整理自红杉资本与 Oak Lab 两位联合创始人的一场对谈。理查德·萨顿(Rich Sutton)是强化学习的奠基人、《苦涩的教训》(The Bitter Lesson)的作者;库拉姆·贾维德(Khurram Javed)是持续学习研究者,萨顿在阿尔伯塔大学指导的学生,如今与他共同创办 Oak Lab。对谈从《苦涩的教训》谈起,涉及大语言模型的局限、合成数据之争、大世界假设、持续深度学习的算法路径,以及 Oak Lab 的研究纲领。全文依据现场录音编译整理,仅删去口语枝节与寒暄。
不是我怪,是这个领域怪
萨顿: 人们有时候觉得我的观点很激进。他们提问的开场白常常是:你的想法跟所有人都不一样。但我完全不这么看。我觉得我是在用平常的方式思考,反倒是其他人想得有点怪。
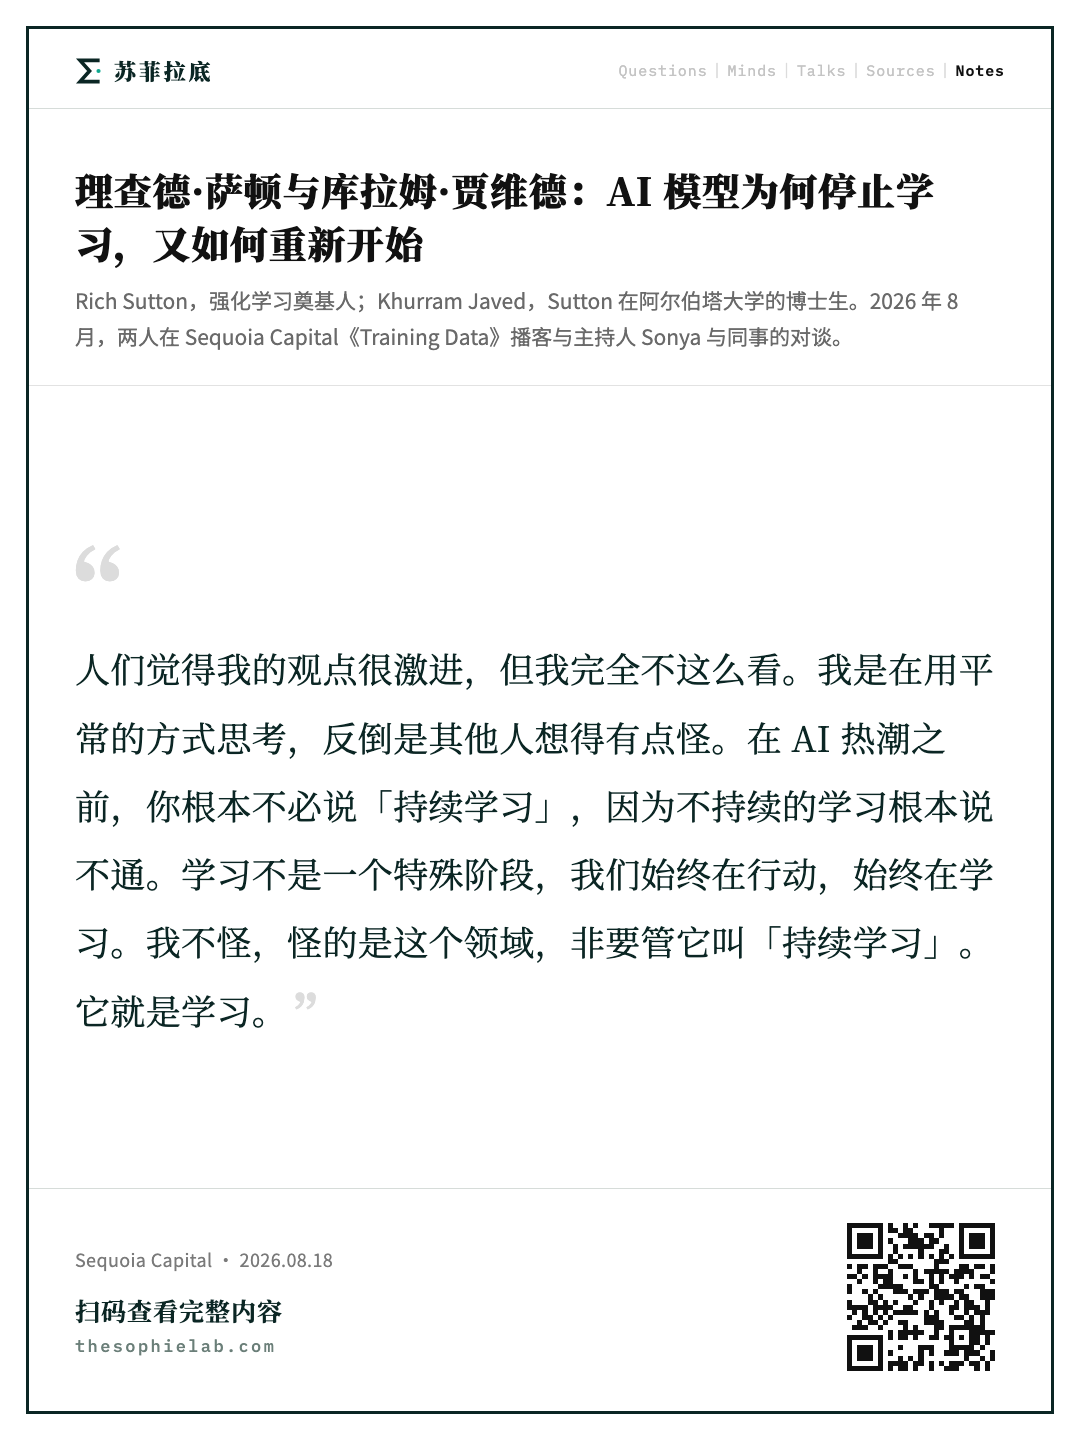
我是认真的。是最近这些年人们才想得怪了。在 AI 热潮之前,你根本不必说「持续学习」(continual learning),因为不持续的学习根本说不通。一切学习都是持续的。我们始终在行动,始终在学习,这才是正常的思路。我不怪,怪的是这个领域,是这个领域非要管它叫「持续学习」。它就是学习。
一个濒死之人的选择
主持人: 今天我们非常荣幸请到了理查德·萨顿。理查德,你创立了强化学习,写了这个领域的奠基教材,培养了戴维·席尔瓦(David Silver)这样的关键人物,还写下了《苦涩的教训》,我认为那是这个领域的圣经。感谢你抽出时间。与你同来的是库拉姆·贾维德,你的联合创始人,也是你在阿尔伯塔大学的学生。两位一起创办了 Oak Lab,我很期待谈谈这家公司。今天我们先从《苦涩的教训》说起,谈谈当下的局面,谈谈大语言模型能不能把我们带到目的地,然后再转向你们的研究纲领和 Oak 的计划。
理查德,我本来想从《苦涩的教训》开始,但其实想先往前回溯。几十年前,你决定把职业生涯押在强化学习上,把阿尔伯塔大学建成了这个方向的重镇,而那时这个领域还在襁褓之中。是什么给了你这份笃定?
萨顿: 不然还能干什么呢?我们想弄清楚心智是怎么回事,而学习是心智的核心部分,拥有目标也是心智的核心部分,是智能的核心部分。所以我只是在一直以来的想法上加倍下注而已。
主持人: 当时人们觉得你疯了吗?
萨顿: 那时候是 AI 寒冬。
主持人: 哪一年?
萨顿: 2003 年。说实话那段经历有点荒诞。2003 年我病得很重,其实是在等死,癌症。但我没死成,你知道,我努力了好几年,一次缓解之后又没死。于是我想,好吧,既然死不成,拖了这么久,不如干脆再找份工作。所以我去了阿尔伯塔,开始在那里教书。
最后我没有死。现在拿这件事开玩笑,但当时是非常严肃的。而更要紧的问题是:只剩几个月可活的时候,我为什么还继续做研究?我总会想起据说是本杰明·富兰克林说过的一句话:如果你想知道一个人为什么做某件事,答案几乎总是两者之一,要么是习惯,要么是虚荣。我觉得这话大概是对的。也许是我习惯了一直做的事,也许是虚荣。我想更可能是习惯,因为我当时快死了。
主持人: 天意。
萨顿: 对我来说,保持坚定一向不难。这个回答我还想再说长一点。
主持人: 请讲。
萨顿: 人们有时候觉得我的观点很激进,提问时总说我的想法跟别人多么不同。但我完全不这么看。我觉得我是在用平常的方式思考,是其他人想得有点怪。
我是认真的。只是最近这些年人们才想得怪了。你去看看人们过去怎么理解心智,哪怕只往回看十年,你会发现那些想法都是:学习很重要,你得有目标,感知很重要。我们是低层次的存在,以极快的速度产生动作、接收数据,同时又必须在更高的层次上思考。再往前,在这场 AI 狂热之前,你根本不必说「持续学习」,因为不持续的学习根本说不通。一切学习都是持续的。学习不是一个特殊阶段,我们始终在行动,始终在学习,这才是正常的思路。我不怪,怪的是这个领域,非要管它叫「持续学习」。它就是学习。
主持人: 「不是我怪,是别人都怪。」这是句不错的座右铭。整个领域都庆幸你活了下来,感谢你一直在推动 AI 的前沿,也感谢你培养了那么多同样在推动前沿的学生。过去二三十年,你是怎么挑学生的?
萨顿: 你这是给我一个谦虚的机会。我喜欢谦虚,喜欢指出那些伟大的决定其实都是碰巧发生的。对学生,我就是这种感觉。我不觉得自己挑学生挑得好,有时候运气好,有时候运气差。我看着库拉姆,心想,有时候你就是碰上了真正出色的人。戴维·席尔瓦是他挑的我,不是我挑的他。库拉姆,我是怎么得到你的?
贾维德: 我的硕士不是跟你读的,当时打算去业界。后来我们在一个项目上合作起来,也是自然而然的。我做过一个东西,理查德在一次会议上听人提到我做过,我就被拉了进去。合作非常顺利,我很开心,理查德也觉得很好。六个月之后我们有了些进展,把它写成博士论文选题就成了顺理成章的事。所以我从没申请过,也从没问过你愿不愿意当我的导师。我们先一起干活,然后觉得这可以是一篇不错的论文,之后我才去申请博士。
主持人: 人生的路总是出人意料。
《苦涩的教训》二十六个字
主持人: 把我们带回 2019 年。你写了《苦涩的教训》,后来它成了这个领域的经典。2019 年写这篇文章其实时机很微妙:ImageNet 是 2009 年,AlphaGo 是 2015 年。是什么促使你在 2019 年回顾并写下它?那时大语言模型的规模化范式还没起飞,但深度学习已经证明了自己。
萨顿: 那篇文章酝酿了很久。正如文中所说,这是一件你可以观察几十年的事。它至少同样多地来自符号 AI 那一轮,我亲身经历过。核心就是不要被「把人类知识塞进去」的诱惑分心,而要专注于问题本身需要什么,以及如何随算力扩展。至少一年前我就写过它的不同版本,也做过演讲。它不是对某个时刻的回应,而是对我漫长经历的回应:不同的人用不同的方式思考怎样造出聪明的系统。
主持人: 《苦涩的教训》的精髓是什么?我在会议上最常听到的一个词就是「吃了苦涩教训的药」(bitter lesson pilled)。以这个词的流行程度,想必已经被以各种你未曾预料的方式曲解和滥用了。你认为它的精髓是什么,人们在理解它时又错在哪里?
萨顿: 你让我想起我最近在 X 上发的一篇帖子,我试着用二十六个字概括苦涩的教训。大意是:不要被人类知识分心,AI 历史上已经分心过很多次;要专注于能随算力扩展的方法,比如搜索,比如学习。所以它的核心是算法和改进。它不是说你不需要精巧的算法,你需要,但你要的是能随算力扩展的精巧算法。
主持人: 而不是随数据扩展。
萨顿: 而不是随人类的输入扩展。接下来的问题我可以预料,那大语言模型呢?
主持人: 对。它们与你的论断相符还是相悖?
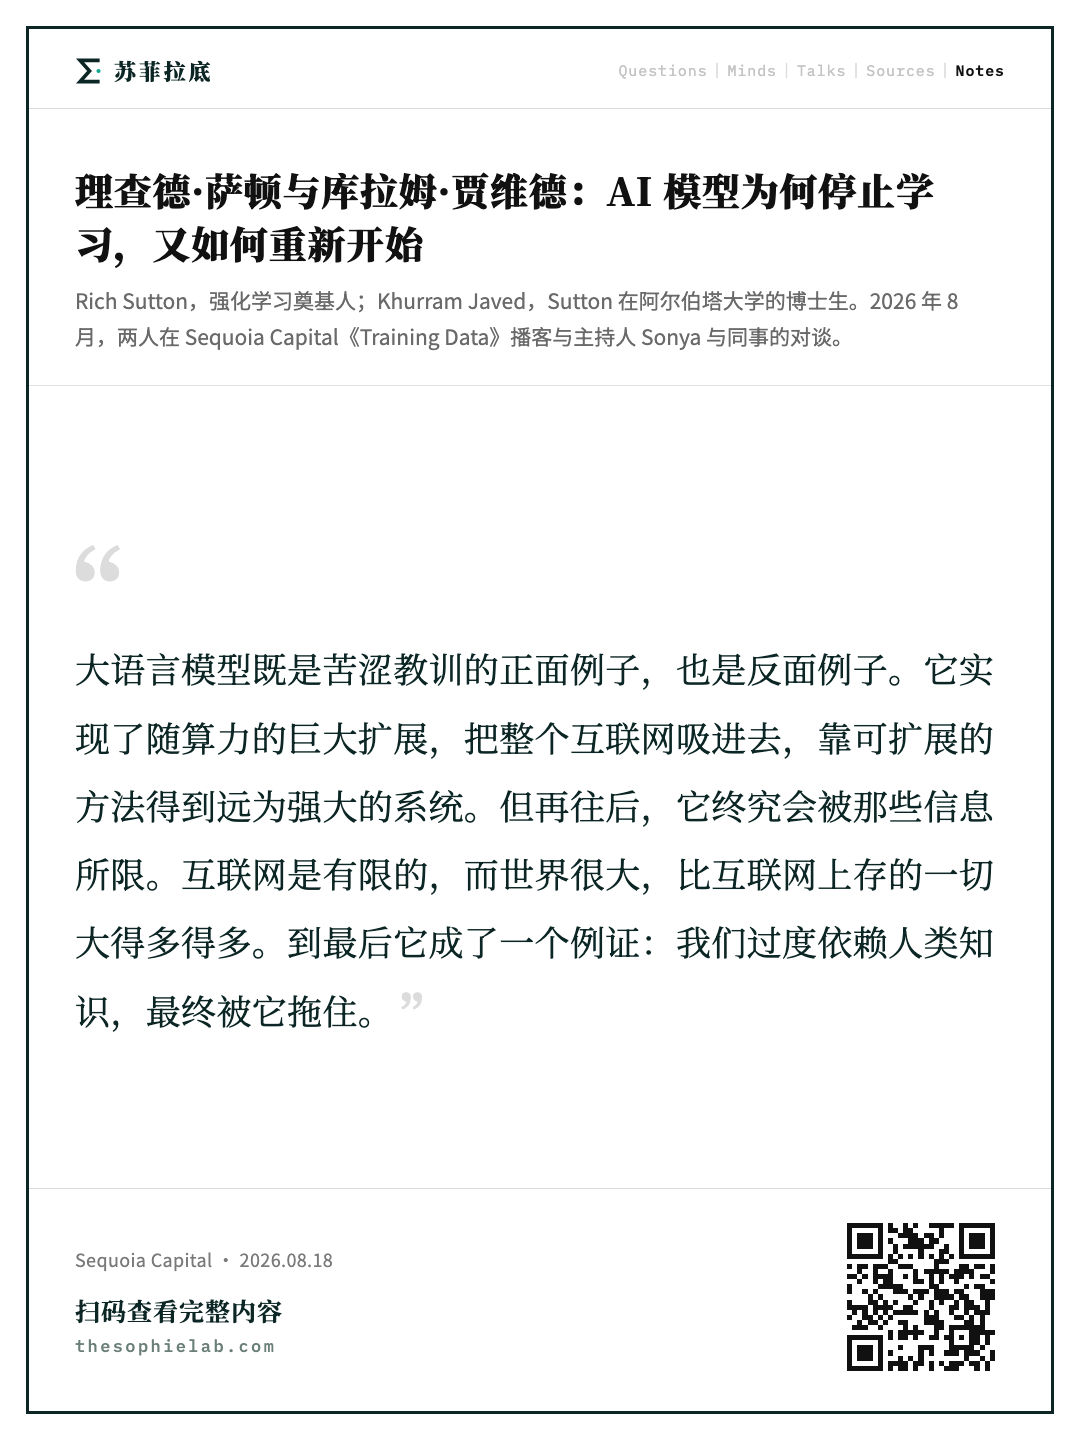
萨顿: 我想过这个问题,也发过一篇帖子。结论是:大语言模型既是苦涩教训的正面例子,也是反面例子。首先,大语言模型实现了随算力的巨大扩展,你可以把整个互联网吸进去,规模扩得极大。这是靠可扩展的方法得到远为强大的系统。但再往后,它终究会被那些信息所限。互联网是有限的,很难再获得更多例子。而世界很大,比互联网上存的一切大得多得多。所以到最后,它成了一个例证:我们过度依赖人类知识,最终被它拖住。
合成数据是个大错误
主持人: 我想追问一下。眼下基础模型实验室的大量工作是合成数据生成,为的是跨过「现有人类互联网」这块化石燃料。作为大语言模型规模化范式的一部分,合成数据生成算不算一种利用算力的通用方法?
萨顿: 不算。那就是个大错误。
主持人: 为什么?
萨顿: 这也许是下一个大教训。这个想法在阿尔伯塔已经流传了五到十年,我们称之为「大世界视角」或者「大世界假设」(big world hypothesis)。库拉姆后来把它写成了一篇小论文,就叫《大世界假设》。
贾维德: 大世界假设是说,世界无限大,有无限多的东西要学。你可以让人去生成合成数据集,但总会有更多东西要学。正因如此,如果能直接从经验中学习,把人从循环里拿掉,你就能有无所不能的系统。因为世界很大,我们想让它们做的任务太多了,它们能从自己的经验中学会做任何事。
回到合成数据的问题:谁来决定什么是好的合成数据、什么是坏的?我可以写一个程序输出海量合成数据,而那些数据会损害模型。眼下的答案是人来决定。这就是瓶颈:你可以让人来决定如何生成这些数据集,但这条路要扩展,就需要知道哪种数据集好、哪种坏的人类专家。所以它被人卡住了。
主持人: 难道不是我的损失曲线来决定吗?用这个数据集比那个数据集进步了多少,曲线不就说明了?
贾维德: 对。但如果 OpenAI、Anthropic 和所有新兴大实验室的工程师都去度假了,谁来生成合成数据?问题就在这里。它不来自智能体的经验,不是智能体自己生成的,必须有某个人来决定该生成什么样的合成数据,而这需要人类专长。举个例子,假如你想让系统做一件物理上很有挑战的事,比如一架像蝙蝠一样靠回声定位飞行的无人机。什么样的合成数据是对的?我想你得雇领域专家去弄清楚该要什么数据,把它生成出来,然后也许能从中学到。但领域专家得先存在。到那一步,我们就被人类专长卡住了。
主持人: 但你可以有无限多的合成世界,而现实世界是有限的。
贾维德: 还是回到回声定位的例子。我要的就是这个:一架能用回声定位自身、自主移动的无人机,这是我的目标。这个机器人本身就在生成自己的经验,它完全可以从自己的经验中学习。可不管你生成多少合成数据,哪怕你的合成数据涵盖了五十个不同的宇宙,不先由人把这件事弄明白,它就完成不了这个任务。
萨顿: 我首先要说,合成数据是错的。它不会是对的,它是一个合成的世界,不是真实世界,而这一点很要紧。世界极其复杂。你写一个小程序(生成合成数据的必然是个小程序),它造出来的只会是一个小世界。
比如,对我来说重要的是你此刻脑子里在想什么。你会说,那我为什么不弄些合成数据来告诉我别人脑子里在想什么?不行,别人的心智不可能有合成数据。而别人的心智对我们很重要。比如我今天在跟你们谈投资,我在乎你们心里在想什么,这种东西怎么可能有合成数据?说真的,任何东西你都弄不到合成数据。无人机在物理世界里如何与环境交互,摩擦力,电机里的磨损,这些你都弄不到合成数据。世界无限复杂,任何对它的模拟都微不足道。
大世界假设,说白了就是:世界比你的心智、比任何智能体都复杂得多得多。这是显而易见的,因为世界里包含着许多其他智能体。既然世界如此复杂,你就不可能做到任何号称最优或完美的事。你必然是不完美的,你必须用近似,而且那些近似会很粗糙。正因如此,如果非要给持续学习找一个理由,这就是根本理由:我们会遇到这个广袤世界的某个特定角落,必须学出一个针对所在角落调校过的近似,而不是针对我们不在的其他所有角落。
主持人: 我再追问一次。抱歉我是为了争论而争论,但我想弄明白。据我了解,最新一批自动驾驶公司里,很多主要是在仿真环境里训练的,然后做一些后训练来确保它们在真实世界里能用。这条流水线一直非常有效。
贾维德: 这里该问的重要问题是:造那个仿真器用了多少工程师?我们是否准备好宣布,只有那些能雇一大队工程师先做出仿真的问题才值得解决?我敢肯定他们迭代了很多轮:做仿真,在里面学,发现仿真到现实的差距(sim-to-real gap)不可接受,再修。人一直在循环里修仿真器。他们从真实世界拿到反馈,人再去修仿真器。为什么不能把人拿掉,让智能体自己来?
萨顿: 而且它真正上路的时候,还是会有意料之外的事发生。
贾维德: 那正是你真正需要从经验中学习的时候。
主持人: 所以你们的意思是,来自经验的数据,远远多于人类策划、制造的数据所能达到的量。
贾维德: 对。而且从仿真中学习显然有价值,也有正确的做法:智能体从自己的经验中学出一个模型。智能体自己学出来的模型好得多,因为模型不对时它能靠持续学习去修正。如果仿真器是人造的,那只有人发现哪里不对,模型才会更新。所以,规划很重要,智能体应该从仿真器中学,但那得是它们自己造的仿真器。
先验与学习不该为敌
主持人: 我想转到《苦涩的教训》的另一部分:去掉人类知识。你在文中写道:为了在短期内取得可见的进步,研究者总想利用自己对领域的人类知识,但长远看唯一要紧的是对算力的利用。你的学生戴维做的 AlphaGo 和 AlphaZero,在我看来就是去掉人类先验的一次胜利。那个结果让你意外吗?
萨顿: 当然让我很高兴,让我觉得自己得到了证明。但结果本可能是另一个方向,因为先验知识确实能帮上忙,先验知识没有什么错。我在《苦涩的教训》的开头就说了,先验知识和学到的知识之间没有理由非得冲突。你可以先放一些先验进去,然后开始学。原则上这两者没理由对立,它们都是关于知识的。生活就是获取知识、拥有知识。天性与教养怎么就成了敌人?先验就是你已经有的,然后你学到更多,它们本该是朋友。但正如我在文章开头说的,实践中它们一直是敌人。实践中,那些偏爱现有人类知识的人总想让它赢,于是想贬低或者忽视学习。
所以现在你们大概觉得我是一个热爱学习、想抛弃先验知识的人。可我其实是一个对心智感兴趣的人。心智就是:你有先验知识,然后得到更多,得到之后它又成了你的先验,如此不断累积。这两样东西是一起运作的。我之所以显得像个只关心学习的人,是因为全世界其他人都在说:只要知识够多就行,不需要学习。大语言模型就是把所有知识塞进系统,然后运行的时候不再学习。它在跟人说话,在交互,可权重绝对一动不动。所以怪的不是我,是你们这些人,你们竟然相信一个不再学习的东西能拿出博士级别的经验和专长。怪的不是我。
主持人: 所以你的建议是,让算法跑得久得多,再把先验数据一点点滴进去?
萨顿: 持续学习。两者都重要,但长远看,你必须获取新知识,并且把获取新知识这件事组织好,长远看唯有这个要紧。在这个过程中,当然会有一些是你之前就有的。
想想将来有了智能机器人会怎样。我们会让它们全部从零开始学吗?还是复制它们,让它们从各自所在的地方接着学?它们是数字的,复制很容易。所以与其花天文数字的钱从互联网上把它们重新训练一遍,我们只会复制这个智能体,从那里接着学。从这个意义上说,先验知识其实可以不用管了,因为你直接从上一个机器人那里复制过来就行。
权重从不改变
主持人: 请描述一下,你心目中一台从经验中学习的机器或计算机是什么样子?
萨顿: 它可以是一个机器人,也可以完全活在互联网上。比如在互联网上给数据包选路,做法对经验敏感,越做越好。或者通过用户界面与人交互,在你的手机或电脑上,随时间变得越来越好。一个智能助手必须随时间变好,它必须知道你想要什么。
主持人: 你是否认为,当下流行的基于大语言模型的助手,不算经验学习者或持续学习者?如果是,根本的差距在哪里?
萨顿: 你是认真的吗?
主持人: 它们会记住关于我的事,会做一些上下文学习(in-context learning)。
萨顿: 它们的权重从不改变。
主持人: 顺便问一句,只改一小部分权重够不够,还是所有权重都得变?
萨顿: 想想创造大语言模型的过程中,那些结构的建立、新概念的生成,全都是权重学习。你希望能继续做这件事,而不是只做一次。
主持人: 换个说法:我们在发布模型之前做了太多预训练和后训练,之后它们就不学了?
贾维德: 唯一的分歧点就是,之后我们不让它们学了。预训练多少都行,后训练也没问题,但当我在使用模型的时候,它就停止学习了。你可以给它更多上下文,通过上下文改变模型的状态。它已经学会了:如果状态不同,如果状态里有新东西,就用它来做下一步预测。但模型本身没有在学习。
主持人: Cursor 的 Tab 补全模型确实会根据使用情况更新。
贾维德: 那些模型的权重是在变的。Cursor 的 Tab,我想还有它的 Composer,也在更新。这是两个持续学习的例子。但可以做得好得多。据我了解,他们的做法是:大量的人在用 Tab,他们收集来自数百万或数千用户的数据,然后用这批数据对策略做一次更新。这可以奏效。但假如我想教这个模型一件很具体的事,我不想跟十万个别人争论各自想教模型什么,我想教我的模型一件非常具体的事,教给我这一版模型。我不在乎模型里来自其他人的共享知识。所以那是一种非常低效的做法。
主持人: 目前的做法似乎是:所有人共通的基本技能学在权重里,个性化则以上下文的形式发生。这不是学习应有的正确模型吗?还是说所有上下文都应该活在权重里?
贾维德: 上下文也可以在状态里,两者都可以。但你仍然需要能更新权重。举个例子,一些很好的案例来自人类残障研究。当一个人经历了改变其心智或某种感官的事,你能看到他们适应。比如我们有本体感觉,有内部传感器告诉我们身体的姿态,走路要靠它。有些人完全丧失了这种能力,于是根本无法行走,因为那正是他们行走策略的根基,深深刻在大脑里。但经过两三年,他们能靠看着自己的脚重新学会走路,用视觉反馈来替代。所以大脑的可塑性惊人:一件二十年来一直成立的事,当它不再成立时,大脑能更新它、抛弃它。我认为这正是我们希望系统拥有的、极为有用的能力。
动物不靠监督学习
主持人: 人类婴儿和动物的学习方式能给我们什么启发?你们从中汲取多少灵感?
萨顿: 我们汲取了很多灵感。我们不把「AI 必须像自然系统那样行事」当作要求,婴儿也好,人也好,动物也好,只是灵感来源。从动物学习中取灵感,但不受其约束。
主持人: 这与苦涩的教训一致?
萨顿: 对。
主持人: 生物学习中有什么东西,是今天的系统里没有、而我们最应该借鉴的?
萨顿: 我觉得我现在只是在发表意见,不过都是显而易见的意见。我认为很明显,没有任何动物是靠监督学习来学习的。因为没人给我们示例,告诉我们肌肉该怎么抽动,而肌肉抽动才是我们的输出。
主持人: 但整个学校教育都是监督学习。
萨顿: 绝对不是。就算是,学校也只占我们所学的极小一部分。我们学会看,学会走,学会世界如何运作。而且即便在学校,也没人告诉我们肌肉该怎么抽动。
主持人: 我掌握的知识和技能是在学校靠监督学习获得的。
萨顿: 我不是说向他人学习、他人的传授不重要,那极其重要,语言也极其重要。但我们缺的是什么?没有监督学习,没人给我们目标值。你听到正确答案:法国的首都是哪里?我们知道答案是巴黎。但没人告诉我该怎么发「巴黎」这个音。你说答案是巴黎,我听到你的话,然后我用另一套肌肉运动来产生「巴黎」这个答案。这不是字面意义上的监督学习。
所以我认为这确实成立。首先,学校无关紧要。松鼠不上学。动物不是那样学的。学校是一个非常特殊的东西,连我们人类在几百年前都没有。它不属于智能的本质。把学校这个我们作为动物本来不做的事当成学习的首要范例,是一种误导。
主持人: 真希望我父母当年能听你说这番话,省得我被送去上学、受那些规矩。
主持人: 问题是,松鼠很擅长从树上跳下来,但松鼠不会证明数学定理。我想学证明数学定理,就得去上学。
萨顿: 它们也没有 DVD 和 iPod。有很多事它们能做我们不能。至于数学定理,它们也不下棋。这有点像莫拉维克悖论(Moravec's paradox):那些我们视为高度智能的高级事务,对计算机来说反而容易;而那些平常的事,比如运动、带注意力的视觉,反而很难。我认为监督学习是好东西。我只是喜欢找显而易见的事:没人能靠给示例来教我们抽动肌肉,因为根本不可能。我们必须自己去抽动肌肉,自己去弄明白。
贾维德: 而且他们给的答案也会是错的。如果我把嘴、舌头和声带按理查德发「巴黎」的方式一模一样地动一遍,肯定会发出一个截然不同的声音。所以从某种意义上说,理查德也好,任何人也好,都不知道用我的身体发出那个音的正确方式,只有我自己知道。
主持人: 在我看来,那些最原始的感觉运动能力,尤其是物理世界中的运动,我同意本质上是从经验中学的。但更高层次的抽象,那些更接近「人类何以伟大」的东西,多数并不在这种低层次的感觉运动学习里。你们的世界模型是否从感觉运动学习一路涵盖到高层?
萨顿: 对,这正是我们的抱负。顺便说一句,松鼠也能做一些相当抽象的事。
主持人: 松鼠能做的最酷的事是什么?
萨顿: 它总能钻进你的喂鸟器,不管你设了什么障碍,它都能找到新的跳法和爬法。
贾维德: 它们算轨迹算得很准。动物对物理世界的理解很到位,并不需要我们想象中发射自己上太空时那种心算。
萨顿: 摔倒时护住自己,它们能实时用正确的方式做到,避免受伤。
主持人: 好吧,有道理。
萨顿: 我认为这只是程度之别。我倾向于认为其他动物与人类非常接近。一味强调我们与动物有何不同,是一种傲慢。看到共性更好。我们只是程度上的差异,当然,社会和文化给了我们巨大优势,语言也给了我们巨大优势。
想象、抽象与范式转移
主持人: 我想再追问一下,因为我想替索尼娅(Sonya)撑一下腰。我相信动物和儿童从经验中学习,并靠经验做出了了不起的事。我儿子两三四岁的时候,我常感叹:真有意思,没人教他,他就能学会这些。但同时,索尼娅的意思是,人之所以为人,能上太空,能造火箭,这些并非百分之百从经验中学来的。发射火箭之前,你得先在脑子里抽象地把它想通,而这不是从所谓的「经验」中学来的,因为你不知道它能不能成,你得靠想象。我们怎么教机器去想象此前不存在的东西?这大概是我们想追问的,因为这一点我们还没弄明白。
萨顿: 这点我其实同意你。你得能规划,得能想象。
贾维德: 你觉得一千年前的人类,在做出我们谈的这些事之前,是否同样智能?假如那个时代的人接触到今天的文化,能不能获得同样的技能,开始做有用的事?
主持人: 即便在过去一万年里,我认为人脑也没有多少演化。
贾维德: 根本上是同一台机器。
主持人: 根本上是同一台机器,但我们积累了一万年的知识。而我通过上学、通过监督学习获得这一万年的知识,比靠经验去学快得多得多。
贾维德: 对,你说得完全对。我们希望系统从经验中学,而它们经验的一部分就是接触我们的文化,学习我们的文化。它们应该从中学,这都很好。但我们来谈谈有人做出范式转移式的事情时是怎么回事。大家都举爱因斯坦的例子,但我认为例子很多,学习本身也是一个例子:从「编程」到「学习」的视角转换。范式转移发生的时候,我会说,是一个积累了所有这些知识的人,从自己的经验中构建新的抽象,用这些抽象来规划,进而发现新知识。这种提出新抽象、学出模型、用模型规划的技能,在我们当下的系统里完全缺席。你可以在人类知识的边缘看到这个问题,但也可以在感觉运动流的层面研究它。
萨顿: 所以我们并不是在原则上争论,我们需要形成抽象,才能在高层次上推理。你们刚才快要做我说过永远不该做的事了:争论先验知识重要还是获取知识重要。你们刚才说的就是这个。你说,你还是得学东西;你又说,我可以从文化、从先验知识中获得。但这两者不该相互为敌。
主持人: 具体说到范式转移,我们怎样造出一台知道何时该转换范式的机器?
贾维德: 我想是通过它的经验。它必须通过自己的经验。它不能依赖人类知识,因为我们的前提就是人类只看到一种范式,而我们想要另一种看世界的方式。所以它必须通过自己的经验找到更好的东西,也许泛化更好、预测更准,也许在别的方面更好,但必须来自它自己的经验。
萨顿: 我们这个领域尚未见到的重大能力,是学出一个模型,然后用这个模型来规划。数学的事我们能做,AlphaGo 我们能做,因为在游戏里模型是已知的,我们知道走法怎么运作;在数学里我们知道算子是什么,知道 Lean 会把我们从一个知识状态带到证明的下一个状态。但如果模型必须学出来,我要直说了,这也许是个奇怪的例子,但我看不到这个领域里有任何「学出模型、再用模型规划」的实例。
贾维德: 至少没有用自主发现的抽象来做的。有人说,我就学一个预测下一秒或下一毫秒会发生什么的模型。但我们的心智模型不是这样运作的,我们的模型更抽象,性质相当不同。
阿尔伯塔计划
主持人: 我喜欢你们的一点是,你们不是坐着空谈,或者哀叹世道,你们很讲行动,所以才创办了公司。我们来谈谈这个。理查德,2022 年你提出了一个非常具体的十二步计划,即「阿尔伯塔 AI 研究计划」(Alberta Plan)。讲讲它吧。
萨顿: 阿尔伯塔计划的由来是,我们有一些总体想法,但也需要把它们拆成更小的块。十二个步骤就是把特定的块具体化的尝试。早期有一个非常重要的步骤,第二步,持续深度学习(continual deep learning)。我们认为它几乎是最重要的一步,因为它解锁了其他一切。如果你能做持续深度学习,你就能持续更新自己的世界模型。然后,如果你知道怎样把抽象做对,步骤的后半部分全是关于如何把抽象做对的。我说「做对」,不是指找到「正确的抽象」,因为没人能说什么是正确的抽象,那取决于你所在的世界。你的智能体必须为它所在的任何世界学出正确的抽象。所以也许关键就是这两件事:你必须找到正确的抽象,你必须能做持续深度学习。
贾维德: 我想这个领域很多人都意识到我们需要模型、需要用模型规划。但抽象告诉我们模型应该以什么为条件:模型该预测什么?你要做什么,然后会发生什么?更重要的是,这些抽象从哪里来?我很喜欢顶尖运动员的例子。你问顶尖运动员他们怎么做某些动作,他们会有一些古怪的小众术语来描述非常具体的事情,「我做这个」,然后有个名字。如果他们只是自己练,有时候甚至连名字都没有。那他们是怎么想出这些抽象的?这在某种意义上正是缺失的关键,阿尔伯塔计划的后半部分回答的就是这个。
灾难性遗忘可以治愈
主持人: 能谈谈持续深度学习这部分吗?今天存在的是一个算法上的差距,还是仅仅是部署、基础设施、数据隐私上的实际差距?如果我想基于用户交互天真地更新权重,今天就能做到,对吧?在你们看来,走向持续深度学习,我们最缺的是什么?
贾维德: 绝对是算法差距。你可以做那个天真的办法,但你会看到各种各样的问题。比如你说,我拿一个样本,然后用它更新整个模型。你会碰到这个问题:模型里之前的所有知识都受到了负面影响。而目前绕过它的办法恰恰是 Cursor 的做法:他们不用一个样本,而是用来自大量用户的一大批数据。在能拿到这种数据的场景里,你可以做持续学习。但大多数场景没有,大多数场景你只有一条数据流。这时候用天真的办法,就会以极具破坏性的方式彻底摧毁你的先验知识。
主持人: 灾难性遗忘(catastrophic forgetting)。
贾维德: 对。
萨顿: 但它完全可以治愈。你得有正确的算法。
主持人: 药方是什么?
萨顿: 首先要做我们所说的步长优化(step-size optimization)。意思是网络里每个权重都得有各自的步长,有的动得快,有的动得慢,而且你得对每个权重的步长做元学习。网络里大部分权重的步长会很小,这样你用新样本训练时它们就不会被破坏,变化只发生在恰当的地方。
其次,你得用某种形式的「生成与检验」(generate and test),在特征空间里做。也就是说,你提出新的特征、新的单元,而不是靠沿梯度走。因为梯度是一个非常慢的过程:只有当你知道某个方向有用时才朝它移动,这永远很慢,也不能给你一条通往越来越复杂、持续学习的路。你需要一种东西,能直接提出一批新单元,然后从那里往下走。
我可以说一个具体的东西,让这件事落地:我们有一个叫「持续反向传播」(continual backprop)的算法,几年前发在《自然》上。它和反向传播完全一样,只是你还会不断种下新的种子,即用随机权重新初始化的单元。反向传播只在时间开端有随机权重,随着训练进行,随机性带来的所有多样性都被用光了。而持续反向传播不断注入一点随机性,一点生成与检验:生成,然后由反向传播的运算来充当检验者。你需要这个。如果把这些东西真正结合好,我认为你会得到新一代远为强大的持续深度学习。这就是我们希望在未来几年做成的事。
主持人: 很好。你们认为这些算法能用在当下的局面里吗?人们正在扩展大语言模型,试图让它们持续学习而不发生灾难性遗忘。
贾维德: 当然。不过我不认为你能拿一个现有模型说「我就用这些算法开始更新它」,因为这些算法是在元学习「如何学习」。所以实际上你得说:我要从零开始学。比方说,我要训练一个新的基础模型,但用这些新算法来训练。这些新算法在学知识的同时,也在学如何学习未来的东西,两件事同时进行。然后我认为你就能学新东西而不发生灾难性遗忘。
一颗自洽的心智
主持人: 相对于当下的局面,你们公司要做的最激进的事是什么?
萨顿: 又回到「我不疯,是别人都疯了」。
贾维德: 也许没那么激进。2016 到 2018 年间,很多人都在深入探索这些想法。只是他们的设定要局限得多:他们会说,我们有一个问题分布,在这个特定情形下这么做。而我们想从单一的经验流出发去做,所以我们的方法应该更普遍适用。很多人探索过这个,但没人在通用设定下探索过,让得到的算法处处适用。
主持人: 那么,你们的新公司要做的、别人没在做的最激进的事是什么?
萨顿: 最有雄心的事吧。记住,我不觉得自己怪,所以我不想说「激进」。最有雄心的,我想是试图拥有完整光谱的知识,既关于极小的事,也关于极大的事。比如思考怎么乘飞机从一个城市到另一个城市,那是件很大的事,就像你的太空飞行的例子,只是更贴近常识,因为我们很多人都坐飞机,而我们所有人都在生活的方方面面使用抽象。连松鼠都用抽象。所以,拥有从小到大的整个知识光谱,用统一的方式处理它,并且让它能自我维护。
那个大问题永远是:你有一个知识系统,是什么让其中的知识保持正确?大语言模型里知识的正确性靠什么维持?靠人做了大量后训练,确保它是对的,然后把它冻结。这就是它保持正确的方式。可我们的心智一直在变动,却有某种东西让它保持有序、连贯,最终安顿在一个好的地方,而不是漂进疯狂之地。我认为这是我们最大的雄心:一颗自洽的心智,能不断训练自己,并让自己保持连贯。
主持人: 这个愿景如此宏大,把所有这些东西统一到一颗心智里的想法如此有雄心。
萨顿: 我认为它触手可及。现在是 2026 年,我们的计算机这么快。它是不是雄心大到够不着?还是说我们对每一步该怎么做已经有了眉目?我认为我们有愿景,也有眉目。我不认为这不合适。
两千瓦与二十瓦
主持人: 你们的愿景里有一个二十瓦的万亿参数模型,这听起来相当有雄心。
贾维德: 确实有雄心。从某种意义上说,以现有技术这也不可能,光是把一万亿参数存在内存里,以现有的内存技术恐怕就不止二十瓦。但我们真正考虑的是,情况在变好,算力在变便宜、变得更节能,那五到十年后我们会在哪里?我认为五到十年,加上正确的算法,我们完全可以到达一个让这件事成为可能的世界。
主持人: 五到十年是摩尔定律的两个数量级,这是标准的改进速度。如果每十八个月翻一番,十年给你两个数量级。所以要让库兹韦尔(Kurzweil)式的说法成立,今天你应该能用两个数量级之上的功率做到,也就是两千瓦?
萨顿: 两千瓦。如果今天能用两千瓦做到,那十年后就能用二十瓦做到。
主持人: 你们觉得能用两千瓦做到?研究实验室里有很多人手里的算力远不止这些。
萨顿: 我认为有了正确的算法,现在就能比这更高效。
主持人: 如果能更高效,为什么没有人做到?人们又不是就想把钱都烧掉。
萨顿: 有时候看起来他们就是想。我想那是他们证明自己是真汉子的方式,消耗大量能源。
贾维德: 至少我看各个研究团队,没见到有谁相信这是可能的。如果你不相信,你就不会去啃那些技术难题。
主持人: 是它不可能,还是系统里浪费太多?是不是有人知道怎么高效地做,而同一个实验室里有十倍的人在干别的,十个人里九个在浪费?
贾维德: 我的理解是,我们困在了一个局部极小值里。如果想转向这些新型算法,几乎不可能不先变差再变好。开始探索这些新方向时,你第一天不会得到最先进的性能,因为这是一个不同的范式。但那条路通向相似的性能,在更高的能效上。而那些大实验室被产品锁得太死,不可能走一条先变差的路。
主持人: 因为他们现有的范式还能继续扩展,而新范式需要下注。
贾维德: 而且他们得解决一些困难的技术问题,那些问题我们已经想了很多年。我们认识一些同样想了很多年的人,跟他们聊过之后,我觉得这是可行的,但你需要在这些难题上长时间地思考。
语言只是智能的四分之一
主持人: 如果 Oak 一切顺利,公司会怎样?你们在建一家什么样的公司?
萨顿: 如果一切顺利,我们实现这个架构,拥有真正的持续学习,能形成抽象,从而做规划和推理,拥有某种真正的智能。到那时会发生什么,很难准确想象。
主持人: 人类会变得无关紧要。
萨顿: 我完全不这么认为。
贾维德: 我们也不这么认为。
萨顿: 我认为世界会变得更精彩、更有意思,对人类而言尤其如此。但有一类东西你得替它担心:大语言模型。这件事最终发生时,它们可能有风险。当然它们会有一段好日子,已经有过了,非常成功。为了清楚起见,我要说:大语言模型是一项惊人的科学突破,是神经网络娴熟运用语言的突破,完全出人意料。语言曾经一直是符号方法的堡垒,而它们彻底改变了人们对此的看法。这是个大突破。
让我沮丧的是,我们本该庆祝在 AI 问题的一个子集上取得了如此大的进展,好好享受它。可它偏要假装自己是 AI 的全部。智能不全是流畅、娴熟地运用语言,还有多得多的东西。语言是重要的一部分,大概占智能的百分之二十或四分之一。还有更多。我们还没完。
主持人: 如果一切顺利,你们设想的是一颗单一的心智,从学会在树枝间荡秋千到造飞船,把今天谈的所有事都做了吗?是一颗心智、一套权重来做这一切吗?
萨顿: 是一个单一的设计。会有许多不同的心智。
主持人: 也就是说,一个设计,对不同的环境做出反应。
贾维德: 而这个心智的不同版本会学到不同的东西,因为它们的经验不同。这又回到大世界假设:有无限多的东西要学,一个系统学不了无限多的东西。理查德已经提过,如果你有两个这样的系统,是世界上最大的两个系统,那么它们显然无法给彼此建模,因为它们同样复杂。所以单一系统永远到不了能学会一切的地步。永远是多个系统,各自从自己的经验中学习。
从小团队开始
主持人: 两位在招人吗?在找什么样的人?
贾维德: 在招。初始团队大部分人选我们心里已经有数了,都是长期思考过这些想法的人。我们会采取稍微不同的做法,因为这是一个不同的范式,很快变大没有意义,因为每一个我们雇的人都得看到我们所看到的,而不是每个人都能看到。所以我们会从小开始,慢慢扩到一二十人,再往下走。
萨顿: 我们希望高度一致。
贾维德: 我们希望高度一致,这样才能高效协作,把进展扩大。
主持人: 非常好。我很喜欢这场对话,感谢你们抽时间分享正在做的事。你对强化学习和算法设计的未来有着罕见的深刻思考,今天能与你一起探讨,是真正的荣幸。谢谢。
萨顿: 非常感谢,这是我们的荣幸。
一句话概括
Rich Sutton 与 Khurram Javed 认为当前 LLM 范式的根本缺陷在于"部署后权重冻结、停止学习",其新公司 Oak Lab 要用步长元学习、生成—测试(continual backprop)等算法实现从单一经验流出发的持续深度学习与自发抽象,并据此规划与推理。
核心要点
- "持续学习"本就是学习的常态,冻结权重才是反常。 Sutton 强调 AI 热潮之前没人需要说"continual learning",因为一切学习都是持续的;如今 LLM 在交互中"权重绝对不变",却宣称拥有博士级专业能力,他认为"不是我怪,是这个领域怪"。
- 《苦涩的教训》26 字版:别被人类知识分心,专注随算力扩展的方法(搜索与学习)。 它反对的不是先验知识本身(文中开头就说先验与学习"应是朋友"),而是实践中人们偏爱既有知识而贬低学习;需要的是"能随算力扩展的精巧算法",而非随人力投入扩展。
- LLM 是苦涩教训的正反两面例证。 正面:它用可扩展方法"喝干互联网"获得巨大能力;反面:互联网有限而世界远大于互联网,最终仍被依赖人类知识所限制。Sutton 称 LLM 是"语言的重大科学突破,完全出乎意料",但语言只占智能的约 20%–25%,"我们还没完成"。
- 合成数据是"大错误",因为它被人类专家瓶颈化。 Javed 的论证:若所有实验室工程师都去度假,谁来生成合成数据?以回声定位无人机为例,必须先有领域专家决定什么数据是对的;自动驾驶的仿真同样依赖大量工程师反复修补 sim-to-real 差距。Sutton 补充:任何仿真相对真实世界都是"微观的",比如无法为"他人此刻在想什么"生成合成数据。
- "大世界假说"是持续学习的理论根基。 世界比任何智能体复杂得多(因其包含众多其他智能体),所以不可能有最优解,只能用严重近似;智能体必须针对它所处的那一小块世界持续调整近似。推论:两个同等复杂的顶级系统互相无法建模,因此永远不会有"一个学会一切的单一系统",而是同一设计的多个心智各自积累不同经验。
- 动物不做监督学习,学校是智能本质之外的特例。 没人能示范"肌肉该如何抽动",别人发 Paris 音的肌肉动作放到你身上会发出不同声音——目标只能由自身经验获得。松鼠能突破任何障碍进入喂鸟器、实时化解跌落,Sutton 认为人与动物只是程度之差,强调差异是"傲慢"。但他同意人类需要想象与规划,文化传承极其重要,两者"不该被当成敌人"。
- 领域最大的空白:学到模型,再用模型规划。 AlphaGo 与数学证明(Lean)之所以可行是因为模型已知;而"自发抽象 + 学习抽象模型 + 用它规划"的能力在现有系统中完全缺失。范式转移(如爱因斯坦)正是人在积累知识后从经验中构建新抽象并规划的结果,这一技能既能在人类知识边缘研究,也能在感知—运动流层面研究。
- 灾难性遗忘"完全可治",解法是两项算法。 其一,步长优化:每个权重有独立的元学习步长,多数权重步长极小,新样本只改动该改的位置;其二,特征空间的生成—测试:不依赖缓慢的梯度,持续注入随机初始化的新单元,由反向传播充当"测试者"——这就是他们发在 Nature 上的 continual backprop。Cursor 的 tab 模型虽会更新权重,但靠成千上万用户的批数据做一次更新,无法让单个用户教自己的模型。
- 这些算法不能嫁接到现有模型上,必须从头训练。 因为它们同时学"知识"和"如何学未来的知识"(元学习),需要用新算法重新训练基础模型。2016–2018 年曾有人在"问题分布"设定下探索过,但没人做过单一经验流的通用版本。
- 大实验室困在局部最优,Oak 选择"先变差再变好"的路。 新范式一开始不会有 SOTA 表现,被产品锁定的大厂无法承受这条路;Javed 观察到各研究组甚至"没人相信这是可能的",不相信就不会去解技术难题。
结论与值得注意的细节
- Oak Lab 的最高野心:一种统一处理从微小到宏大(从肌肉抽动到"坐飞机跨城")全谱知识、能自我维持一致性的心智——LLM 靠后训练加冻结来"保持正确",而真实心智是不断改变却仍能"回到好的状态而不漂向疯狂"。Sutton 认为这"在可及范围内",2026 年算力已足够。
- 能耗目标:万亿参数、20 瓦。Javed 承认以现有内存技术仅存储万亿参数就超过 20 瓦,寄望 5–10 年(约两个数量级摩尔定律);主持人反推今天须能以 2000 瓦实现,两人表示用对算法可以更高效,Sutton 调侃大厂烧能源是"证明自己是真男人"。
- 若成功,Sutton 不认为人类会无关紧要,反倒是"LLM 可能有风险"——它们已经"跑得不错了"。
- 招聘策略:初始团队心中已有人选,多为长期思考这些问题的人;刻意不快速扩张,先做到"极度对齐"的一小撮人再增长。
- 背景细节:Sutton 2003 年在 AI 寒冬、身患癌症"尝试死亡多年未遂"的情况下去了阿尔伯塔,把坚持研究归因于富兰克林所谓"习惯或虚荣"中的习惯;Javed 从未申请过做他的学生,是合作六个月后自然转成论文选题;Alberta Plan 12 步中第 2 步"持续深度学习"被视为解锁一切的关键,后半程则关于让智能体在所处世界中学到正确抽象。

追问一个大问题。 苏菲拉底的每周来信,写这一周在追问的问题和看到的回应。
 微信公众号