
Emily M. Bender — Language Models and Linguistics
节目发布 2021-09-09 · Weights & Biases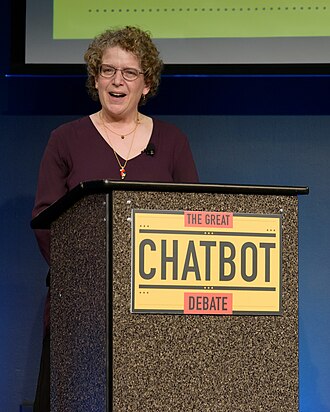 艾米莉·本德
LLukas Biewald
本文是播客《梯度异见》(Gradient Dissent)的一期访谈。主持人卢卡斯·比瓦尔德是 Weights & Biases 的创始人,受访者艾米丽·本德是华盛顿大学计算语言学教授,「随机鹦鹉」论文的作者,也是比瓦尔德在斯坦福读本科时语言学入门课的老师。谈话围绕本德近年的四篇论文展开:大语言模型的风险、语言模型能否「理解」、基准测试的误用,以及所谓「本德法则」。本文依据现场录音编译整理。
随机鹦鹉的由来
主持人: 欢迎收听《梯度异见》,一档讲现实世界里机器学习的节目。我是主持人卢卡斯·比瓦尔德。今天的嘉宾是艾米丽·本德,华盛顿大学语言学教授。她在语言学和自然语言处理领域的兴趣极广,从社会影响、跨语言差异,一直到可以说是语言学哲学的问题。我特别高兴能和她对谈,因为我在斯坦福读本科时,她正是我「语言学导论」的老师。那是我最喜欢的课之一,到现在我还记得课上学到的一大堆有意思的事实,也是那门课让我对语言学有了终身的兴趣。
我想先从您与人合著的那篇论文谈起:《论随机鹦鹉的危险:语言模型会不会太大?》(On the Dangers of Stochastic Parrots: Can Language Models Be Too Big?)。这篇论文在谷歌引发的风波,连我在推特上都看得清清楚楚。能否先讲讲这段经过,再进入论文本身的内容?
本德: 好。先说个题外话:这篇论文的标题里其实有一个表情符号,最后一个字符是一只鹦鹉,国际音标里没有它,念不出来。我们放它进去纯粹是好玩,因为大家都喜欢「随机鹦鹉」这个比喻。在风波发生之前,我们一度以为这篇论文最出名的地方,会是它是那篇标题里带表情符号的论文。没想到后来的事。
论文的缘起,是蒂姆尼特·格布鲁博士和玛格丽特·米切尔博士带着团队在谷歌做的工作。她们的职责是同工程团队对接,把好的实践嵌进去,让技术对更多人更有用,对世界少造成伤害。她们注意到,尤其是格布鲁博士注意到,业界正在拼命往越来越大的语言模型上推。论文里有一张表,最近两三年参数量和训练数据规模简直是爆炸式增长。
格布鲁博士在推特上私信我:「你知道有哪些论文谈过这件事可能的负面后果或者风险吗?或者你自己写过吗?」我回她:「没有,我不知道有这样的论文,我也没写过。不过随手想想,这里有五六件值得担心的事。」过了一天左右,我又说:「这看起来像个论文提纲。提纲在这儿,要不要一起写?」那是九月初,我们瞄准的会议是 FAccT(公平、问责与透明会议),最终在二〇二一年三月召开,投稿截止大概是二〇二〇年十月八日。
所以我们用一个月写出了这篇论文。之所以做得到,是因为写的人不只我们两个,也不只最后署名的四位,实际上有七位作者。格布鲁把米切尔拉了进来。这里我要强调她们都是有博士学位的,不过我跟她们熟到可以直接叫名字,下面我就叫名字了。蒂姆尼特带来了梅格和团队里另外三位成员,我带来了我的博士生安吉丽娜·麦克米伦·梅杰。我们七个人合起来,专业领域和读过的文献足够多样,才能凑出这样一篇综述。
写作过程也很有意思:我们从没开过一次全体到齐的视频会议,一切都在 Overleaf 上远程协作完成。这种做研究的方式不常见,但在这次行得通。谷歌那边的作者把论文提交了他们内部所谓的「发表审批」,通过了。我们投给会议,然后就把它放到一边,因为谁也没预料到九月要干这件事,对每个人来说这都是额外的活儿,大家各自回头去忙本来该忙的事。
到了十一月底,在我看来是毫无征兆地,谷歌那边的合著者被告知:要么撤稿,要么把名字撤下来。这里我得声明,我不在谷歌,也没拿过谷歌的资助,谷歌内部发生了什么我只有二手的了解,再加上后来媒体的报道。她们没有被告知原因,也没有机会讨论论文哪些地方需要修改,就是一句「撤稿或者撤名」。我们一时不知道该拿这篇论文怎么办:七个人的工作只署两个人的名字发出去,怎么看都别扭。我和安吉转向谷歌的合著者,说:「我们听你们的,你们希望怎么办?」她们说:「不,我们要它面世。你们两个去发表。」
这是最初的答复。然后蒂姆尼特细想之后说:「不对,这样不行。对一个被雇来做这项研究的研究者,不能这样对待。」这本来就是她的本职工作,也是整个团队的本职工作。于是她顶了回去。结果大家在媒体上都看到了,她被解雇了。谷歌说她是辞职,她的团队说她是「被辞职」(resignated),这个生造词很妙。这件事发生得够快,她来得及把名字重新署回论文上。
与此同时,梅格开始着手记录蒂姆尼特遭遇的一切。结局是几个月后她也被解雇了,但那时论文的定稿已经完成。这就是为什么第四作者的署名是「施玛格丽特·施米切尔」(Shmargaret Shmitchell)。
对所有当事人来说,这都是个令人难过的故事。这是对蒂姆尼特、梅格和团队其他成员的恶劣对待,不论他们是不是这篇论文的作者。我想那里已经变成一个很难工作的环境。对谷歌也是损失,它失去了极其宝贵的专业能力,也失去了研究界的大量善意。更让人难过的是,这件事照出了当下的状况:企业利益正在怎样左右我们这个领域的研究。
另一方面,我和合著者们始终觉得,一起写这篇论文、一起扛过后面的风波,是一段很愉快的经历。一个奇怪的结果是,这篇论文得到的关注远远超出它本来会有的。我认为它是一篇好论文,扎实的论文。从投稿版到定稿版,我们打磨得格外用心,因为知道会有很多人读。发定稿预印本的时候,我没放到 arXiv 上,因为那里的版本往往会被引用,而不是最终发表的版本。我只放在了自己的网站上,然后在推特上发了一个 bitly 短链接,这样我能看到下载次数。
单是通过这一个链接,下载量就超过了一万次,何况还有别的途径能找到它。这和我以往写过的任何东西都不在一个量级。作为研究者,这很有意思。但我也觉得这是件幸运的事,因为公众注意到了它。这项技术已经铺开了,正在以各种方式被使用,公众有机会理解到底在发生什么,这非常有价值。谷歌犯了一个严重的错误,却让我和合著者们得到了帮助公众理解这件事的机会。对此我确实感到幸运。
谷歌到底反对什么
主持人: 我很想进入论文的内容。但在此之前,您知道谷歌反对的是什么吗?他们有没有公开说过?我原本以为这一定是篇火药味很浓的论文,结果为了准备这次访谈把它读了一遍,感觉相当温和,没什么争议。这也许很难知道,但他们说过不喜欢它哪里吗?
本德: 说过。公开的说法大概是「它没有引用那些试图缓解这些问题的相关工作」。但从头到尾没人告诉我们该引用哪些工作。而且我们其实引用了一些做缓解的工作。所以我不太清楚那句话指的是什么。
你说得对。我们料到这篇论文会惹恼一些人,因为我们基本上是在说:「大家追得这么起劲的这个东西,也许该慢一点,想想它有哪些坏处,怎样才能安全地做。」总有人不爱听。但说实话,我们以为不高兴的会是 OpenAI,因为 GPT-3 是这类模型里最出名的例子,也是我们贯穿全文的例子。我们以为会惹恼一些人,没想到惹恼的是谷歌内部的人。而且这本质上是一篇综述。我们没做实验,没做分析,只是把关于大语言模型的各种相关视角汇集到一处。这篇论文竟然成了谷歌炸掉自家 AI 伦理团队这份宝贵资产的部分原因,实在出人意料。
伦理不是给人贴标签
主持人: 有意思。对这篇论文,一种读法是「我们该考虑大语言模型的负面影响」。但我可以想象另一种读法,也许不公平:一个正在做大语言模型的人读了,可能会觉得受伤,觉得你们在说做大语言模型是不道德的事。这样理解算夸大您的主张吗?论文不在我手边,但我觉得这可能会伤到一些人的感情。
本德: 我在自然语言处理的社会影响这个方向上做了不少工作,这类工作有时被冠以「NLP 伦理」的名目。我确实看到很多人对这个话题的反应是感到受伤。我想这和人们把自己同工作等同起来有关。如果你说「我们来想想正在造的这项技术在世界上是怎么运作的,怎样才能让它是有益的」,而你用「伦理」这个词来描述这件事,有些人就会读成「你在说我不道德」。我认为把谈话引向这个方向很少有什么价值。
总的来说,我相信这个领域里的人都想在世上做好事。当然有人做技术就是为了赚大钱。那种大亨式的漫画形象,为了尽可能多赚钱乐意碾碎所有小人物,这样的人大概是有的。但更常见的情况是,人们在某种体系里工作,这个体系要求他们对股东价值最大化之类的事负责,这让人很难对眼下正在给股东赚钱的东西踩刹车,很难退一步看大局。所以更有价值的谈法是:这些体系是什么,激励机制是什么,我们作为个人在体系里能做什么,而不是去评判谁道德谁不道德。这可能没有直接回答你的问题,但希望有点帮助。
主持人: 不,我明白,您是说您的观点比某些人可能读出来的要更细致。我自己开公司,热爱技术,热爱造东西,也承认确实有很多人受到伤害,我觉得有人指出问题、踩踩刹车、亮出警示,是件好事。但我能理解为什么有人会觉得有点被冒犯。我不确定是不是我想多了。
读这篇论文时我一直在想一个问题。先把赚钱放到一边,只谈研究,只谈把模型做出来、看它跑起来的那种兴奋。我对这种感觉体会很深。GPT-3 不管有多少喧嚣,它能做到的事确实惊人,我完全没料到它能做得这么好。您会主张这类研究方向应该停下来吗?或者,您希望像 OpenAI 这样的机构做出什么样的改变?这正是一个很好的例子:模型越大表现越好,并不是显而易见的事,再加好几个数量级还能持续改善,事先并不清楚。您是希望这类研究不要发生,还是以某种不同的方式发生?
该怎样做大模型研究
本德: 首先值得说明,OpenAI 其实花了不少力气去想「可能有什么坏处」、「这项技术放到世界上会发生什么」。这点很重要,我很高兴他们在做。我希望看到更多的,第一就是这类工作:可能的失效模式是什么,它们怎样影响到人;还有,当这个东西按预期正常运转时,又会怎样影响到人。OpenAI 做了一些,很好,还应该做更多。
另外,可以看看其他工程领域。在把一个东西放到世界上、让人们依赖它之前,要做各种各样的测试,要弄清楚容差是多少,什么情况下管用什么情况下不管用,适用的温度范围是多少,哪些项目必须检查和认证。这些在自然语言处理里我们几乎还没有。其他 AI 领域我不太能说,但我诚实地认为那里也有类似的问题。梅格·米切尔、蒂姆尼特·格布鲁等人在谷歌做过一个叫「模型卡」(Model Cards)的框架,就是朝这个方向迈的一步:你造了一个模型,要用它的人需要知道些什么?我希望看到更多这类东西。
与此相对的是泛滥的 AI 炒作:人们造了一个东西,很酷,很好玩,效果很好,可不知怎么这还不够。GPT-3 能生成连贯的文本,这还不够,非得说它在理解语言。它绝对没有在理解语言,这个我们等会儿肯定会谈到。
主持人: 您给了两个很好的引子。
本德: 不过这些都是连在一起的。不知为什么,AI 这个圈子的文化就是要去够那些大话,而不是去造那种范围明确、可靠、文档充分到能被安全可靠地使用的系统。我希望看到更多后一种方向。这是一点。
另一点我们在论文里也谈到了:如果如今通往成功的主要道路就是越做越大,那你就把很多语言社区排除在外了。即便是那些总体上支持得不错的语言,内部也有很多社区根本积累不起那么多数据。你也把小型研究组、小公司排除在外了,因为它们手里没有谷歌、脸书、亚马逊那种规模的数据。微软也做很多大数据的工作,但似乎没有像另外几家那样囤积数据。这很不幸,因为我认为它在一定程度上扼杀了创造力。如果整个学界都朝着一个只有少数人真正做得了的目标狂奔,那么人们本来可能去尝试的其他东西,就都丢掉了。
伤害早已在发生
主持人: 论文里还谈到一个不那么显眼的担忧:模型会以难以察觉的方式把偏见编码进去。您谈自然语言模型可能造成的伤害时,有没有现在就正在发生的例子?还是说这更多是面向未来的担心,担心随着 NLP 越来越普及会出现的伤害?
本德: 绝对是现在就在发生,因此很容易预测:如果我们不改变,它会继续发生。这方面萨菲娅·诺布尔(Safiya Noble)的《压迫的算法》(Algorithms of Oppression)是非常重要的记录。她研究的是:各种身份,本应属于拥有这些身份的群体,却是怎样在搜索引擎里被呈现、被反射回人们眼前的。她贯穿全书的例子是「black girls」(黑人女孩)和「black women」(黑人女性)这两个词组。这些情况随时间变化,她谈每个具体例子时都非常谨慎地注明日期。在她刚开始这项研究时,把「black girls」作为关键词搜索,出来的基本是色情内容。
你可能会说,「那只是数据里就是这样」。什么数据?数据从哪儿来的?读到她书的核心部分你会发现,之所以「数据里就是这样」,是因为互联网的经济结构允许人们购买身份词汇并靠它赚钱。这些问题被指出之后,谷歌零零碎碎地做了修改,现在搜「black girls」不再出色情了。但稍微戳一戳就能看出,那都是一个个事后的单点修补,没有人去系统地重新思考:搜索引擎和以广告驱动的排序机制是怎样咬住这些激励、再把它们放大的。
AI 圈里有一场持续不断的争论,推特上隔三差五就冒出来:偏见只在数据里,还是模型也有贡献?答案是:模型绝对也有贡献。
还有一层是那句「数据里就是这样」。谷歌另一个非常难堪的例子是,曾经有一段时间,谷歌图片搜索黑人会出现大猩猩的图片,具体的搜索组合我记不清了,总之难堪、恶劣、种族主义。当时一种反应是「那只是底层数据里就有的」,言下之意是「不是我们的错,我们只是把世界的说法展示出来」。可这不是真的。因为给搜索结果排序、给广告关键词竞价的那些算法,本身就在强化特定的激励。底层数据里确实有些东西,但还有问题是:数据是怎么收集的?从哪儿来的?它到底代表什么?它不是世界本身,只是某一个特定的数据集合。然后,优化指标是什么?你做了哪些建模决策?这些决策和数据里的各种偏见怎样相互作用?激励结构又是什么?诺布尔的工作是很好的切入点。
拉坦娅·斯威尼(Latanya Sweeney)在二〇一三年的一篇论文里记录了这样一件事:当时如果你输入一个听起来像非裔美国人的名字,弹出的广告之一会暗示这个人有犯罪记录;输入一个听起来像白人的名字,往往只会得到「关于某某的更多信息」。差别不是百分之百,但两组名字之间的差异在统计上很显著。这会造成真实的伤害:想象一个人在求职,或者只是在交朋友,有人上谷歌搜了他一下,旁边跳出一条暗示他可能是罪犯的消息。这就是伤害。我还可以再举一个例子。
主持人: 请讲,这些例子都很好。
模型自己也会带偏
本德: 罗宾·斯皮尔(Elia Robyn Speer)做过一项很有意思的工作,关于情感分析和词向量。情感分析这个任务,是拿一段自然语言文本,她用的是英语,去计算或预测其中的情感:这段文字对某个对象是表达正面感受、负面感受,还是没有表达感受。她用的数据集我记得是 Yelp 的餐馆评论,任务就是「读评论,预测星级」。
主持人: 对,那个数据集我用过。
本德: 然后她用了一个外部组件,词向量(word embeddings),也就是根据一个词会和哪些词共现,把词表示到向量空间里。所以一部分训练数据是领域内的 Yelp 评论,但还有这么一个组件,是在泛泛的网络垃圾上训练的。
她发现,用那种通用词向量,系统对墨西哥餐馆的星级会系统性地预测偏低。于是她深挖原因。原来那些网络垃圾里包含了关于从墨西哥、经墨西哥移民美国的讨论,其中有大量对墨西哥人极其负面、极其恶毒的看法。词向量就把「Mexican」(墨西哥的)这个词学成了和其他负面情感词相近的东西。于是,如果你在评论里说这是一家「墨西哥餐馆」,在系统看来你就是在说它的坏话,所以你不可能给它五星。
主持人: 这个例子太有意思了。我本来下一个问题就是模型在这里面扮演什么角色。这正好说明,不只是底层数据可能有偏见,模型本身也可能带着它自己的偏见。
本德: 对。词向量捕捉到了「Mexican」和许多同时与负面情感共现的词之间的共现关系,然后这个词向量被当作组件用进了另一个模型。Yelp 评论本身并没有什么理由让墨西哥餐馆评分更低。
主持人: 是的。
本德: 我不确定它们的平均评分是不是恰好一样,但这不重要,因为错误在于系统对任何一家墨西哥餐馆都预测偏低,平均起来是往低的方向偏。所以,这是一种从外部数据集里拾来的偏见。在 NLP 里,我们习惯把词向量当作非常趁手、非常细致的词「意义」表示,用它算词的相似度,包括语义相似度。如果不留心它到底学到了什么意义、什么共现,我们的系统里就会混进我们根本不想要的东西。
主持人: 那您建议怎么办?词向量确实很有用。而在这个例子里,事情似乎很简单:它在拖累性能,甚至不存在什么模型性能上的取舍。那能做些什么呢?
本德: 关于词向量的所谓「去偏」(debiasing)有很多工作,斯皮尔后来也接着做了一些。我想一部分办法是用更精心策划的数据集。关于墨西哥移民的讨论,就算你只用可靠的新闻来源,还是会碰到那些垃圾。所以单靠这个解决不了问题,但可以做得更好一些。完全没有偏见的数据集不存在,完全没有偏见的词向量也不存在,但你可以做得更好。
一步是问:用精心策划的数据能好多少?对我们已经意识到的偏见,去偏技术能做到什么?去偏技术的一个难处是,你得知道自己在找什么。在这之上,还要把失效模式想清楚。在一个具体的使用场景里,你造这项技术,利益相关方是谁?谁会受它影响?如果某人的餐馆评分因为某个原因被低估了,在实际使用情境中意味着什么?为了确认我们针对这个用例、针对最可能受到不利影响的相关方已经去偏得足够了,该测试些什么?
主持人: 我猜想,要找到一个没有偏见的人类数据集,几乎是不可能的……
本德: 对,它不存在。
形式与意义
主持人: 这正好引到我想谈的第二篇论文。为了不耽误时间,我们就往下走。我试着概括一下:这篇论文说的是,只在您所说的「形式」(form)上做语言建模,也就是只看流过来的词、只看词串,像 GPT-3 这类模型那样,是不可能有理解的,不可能有真正的理解。我觉得有意思的一点是,您说写这篇论文是为了终结推特上的某场争论,而我完全不知道有这场争论。我大概是带着比我自以为的更少的背景闯进来的。您能不能概括一下有哪些立场,以及您想终结的是什么?
本德: 我总是在推特上跟人吵起来,对方声称语言模型在理解东西。我说:「不,它们没有,不可能有。」这里得先说清楚我们说的语言模型是什么。语言模型是像 GPT-3 或 BERT 这样的东西,训练数据是一大堆文本,训练任务是预测文本里的词。有时是顺序预测,有时用掩码语言模型目标,把某些词挖掉,训练目标是「把这些词填回去」,然后更新模型,梯度下降,等等。
作为语言学家,我看着它会说:「有用的技术,有意思。」在语音识别和机器翻译这类任务里它极其有帮助,因为那里有个重要的子任务是「最可能的字符串是什么」。在语音识别里,声学模型说「这段声音可能对应这一批文本串」,然后语言模型进来说:「『It's important to wreck a nice beach』(毁掉一片好海滩很重要)是句荒唐话,『It's important to recognize speech』(识别语音很重要)才合理,所以后者排前面。」这是它们最初为之设计、也擅长的基于形式的任务。
过去几年神经语言建模革命带来的变化是,从语言模型里抽出的词向量,是对词分布的极其精细的拟合表示,非常有用。有些词向量还是上下文相关的,也就是关于这个词及其可能共现的信息不再是它在所有文本中的总体情况,而是它在当前上下文里的情况。极其有用,但这和理解语言不是一回事。
我不断跟非语言学家吵,他们非要说「是一回事」。所以我和亚历山大·科勒(Alexander Koller)写了这篇论文,就是想说:「好,看这儿,这是为什么不是的论证。」希望能了结这场争论。结果没有,人们还是要来跟我吵。
真正难看清的地方,也是语言学在这里的价值所在,在于我们使用语言时的状态。抱歉,我要搬出一位哲学家了:海德格尔有个概念叫「被抛」(thrownness)。当你意识不到自己正在使用的工具时,你就处在被抛的状态。想想在键盘上打字,顺手的时候键盘就消失了;然后某个键卡住了,键盘一下子又「在那儿」了。语言也是一样。我们说一门流利的语言时,语言对我们是不可见的,直到有什么东西迫使我们去注意它。语言学当然就是专门注意语言的,所以语言学家习惯这么做。
当我们说把词喂给语言模型时,一定要区分两种「词」:一种是作为字符序列的词,另一种是作为形式与意义配对的词。因为语言模型看到的只有字符序列。要想象那是什么感觉,最好想一门你不会的语言。你不会哪门语言?
主持人: 普通话。
本德: 普通话,好。你不会说普通话,我想你也不会读中文。
主持人: 肯定不会。
本德: 也许认得几个字?
主持人: 我会读日语,所以有些重叠。
本德: 那我们再走远一点。你会读切罗基语吗?
主持人: 不会,绝对不会。
本德: 好。切罗基语有一套很妙的音节文字,每个字符代表一个音节。如果有人给你看一大堆切罗基语文本,你看着它的那种体验,比你看英语文本更接近计算机在做的事。因为你看英语时,意义那部分是躲不掉的,英语是你会说会读的语言。普通话介于两者之间,你会认出几个从日语汉字里熟悉的汉字,感觉不完全一样。
图灵测试为何失效
主持人: 我不想跟您争,但我想替另一边说几句。这个问题我没深想过。我这辈子看到的是,这些语言模型用它们那套策略,效果好得超出我的想象,而且似乎抓到的细节越来越微妙。我小时候学过图灵测试,它表面上看是个不错的理解力测试:如果你和某个东西对话,分不清对方是自动系统还是人,那我们就可以说它有智能。在我看来,这些语言模型似乎就快通过图灵测试了。要怎样您才会觉得某种自动化技术真的理解了它所读到的东西?
本德: 关于图灵测试,我首先想说它为什么不管用。我很不愿意反驳图灵这样的巨人,他的工作极其重要,是奠基性的。
主持人: 但那是一百年前,漏掉点什么也正常。
本德: 七十年?
主持人: 七十,好吧。八十?七十?行,七十,抱歉。
本德: 事实证明,人太乐于从语言中找出意义,太乐于替一段话脑补出让它说得通的背景。所以我们并不适合充当图灵测试里的测试者。这就是它不管用的原因。
语言模型能产出看似连贯的文本,那是些高概率的序列:给一点噪声和一个起点,根据全部训练数据,接下来最可能出现什么。出来的东西是我们能读出意思的,于是我们很容易被骗,以为它真的有意在传达那个意思。
你问什么能证明机器有理解。我想一部分答案是:谈谈它以某种方式和世界接口的能力。我们确实有这样的例子,机器在受限的领域里、对受限范围内的事情,是有理解的。当你叫你家那个企业间谍机器人替你做件事,它做到了,那它就理解了。
主持人: 等等,什么是「企业间谍机器人」?能不能说具体点?
本德: 我在挖苦 Siri、Alexa、Google Home 这类东西的隐私问题。
主持人: 哦,明白了。
本德: 三星的 Bixby 也是这类,微软以前有 Cortana。当你让它们设个计时器、开灯、拨个电话,它做到了,那么在一定程度上它确实理解了。它之所以能理解,是因为它的训练设置不只看语言,还看语言之外、需要与语言对应起来的东西。这是一种理解。问题在于,对一个想在更广泛的范围内做到这一点的人来说,怎样设计任务,使它需要在世界中采取某种行动,而不能被语言模型硬推过去,靠一句「这是接下来最可能出现的东西」蒙混过关。
章鱼思想实验
主持人: 您得讲讲那个章鱼思想实验,它太形象了,我有几个问题。
本德: 好。章鱼思想实验讲的不只是能否理解,而是学会理解。这是它和图灵测试、和塞尔(Searle)的思想实验的区别:那两个都是说「假设有人已经把整个系统搭好了」,然后我们去测它有没有智能,或者从哲学角度说它仍然不算理解。系统已经在那儿了,我们只是思考它、测试它。
章鱼实验说的是:假设我们有一个东西,我们设定它是超级聪明的。这也是我们选章鱼的部分原因。其实最初是海豚,但我们觉得章鱼天生更有趣。而且海豚的环境和人类的环境太接近了。我们要的是一个被设定为超级智能的东西,而章鱼通常也被认为是聪明的动物。它要多聪明有多聪明,这不是问题所在。我们假定了智能,但只让它接触语言的形式。
在我们的场景里,两个说英语的人各自漂流到相邻的两座荒岛上。岛上没有别人,但以前的居民铺过一条海底电报线。两个人可以彼此通信。他们怎么发现电报机的、怎么知道对面有人,这些我们不交代,就当它存在。思想实验嘛,可以这么干,就像「假设一头球形的牛」,只不过我们不需要球形的牛。
所以有一条电报线,两个人叫 A 和 B,他们用摩尔斯电码编码的英语交谈。一只超级聪明的深海章鱼,我们叫它 O,游过来搭上了这条线。章鱼能感觉到摩尔斯电码的脉冲在线里通过。问题是,章鱼到底能学到什么?因为它超级聪明,时间要多少有多少,记忆要多少有多少,它能极其精确地建模「接下来可能出现什么」的模式。
故事里,章鱼不知为何觉得孤独,决定剪断电缆,假扮成 B 跟 A 说话。回头想想,可怜的 B 就此与世隔绝了,所以也许章鱼同时也假扮成 A 在跟 B 说话,不过我们没写这部分。问题是:在什么情况下章鱼能一直骗过 A,让 A 以为自己在和 B 说话?我们说这在某种意义上是一个弱化版的图灵测试。图灵测试的设定里,A 的任务是判断「我在和人说话吗」;而这里有欺骗,A 根本不知道章鱼的存在。
如果只是闲聊寒暄,那些东西照着模式来就行,只要输出内部连贯,说错点什么也无关紧要。就算有点不连贯,也许 B 只是在犯傻,没什么大不了。这种情况 O 能蒙混过去。但一旦谈话走向 A 真正在乎把想法传给 B、也在乎 B 传回来的想法,章鱼要维持这种「沟通良好」的假象就越来越难。我们举了个例子:A 造了一台椰子弹射器,章鱼能回一句「很酷的发明,干得好」之类的话,尽管 A 问的其实是「你造出来之后怎么样了」。
但章鱼没有关于椰子、绳子这类东西的任何经验。它没法对这些东西进行推理,甚至不知道 A 在说的就是这些东西。它能做的只是回一句「在这个语境下,一个回应最可能是什么形式」。O 之所以能蒙混过去,是因为 A 愿意从这些话里读出意思。在这个场景里,O 没有任何意义。最后,一头熊出现并攻击 A,A 对 O 说,其实是对 B 说:「救命,熊在攻击我,我手里只有两根棍子,该怎么办?」这时 O 完全没用了。所以我们说,如果 A 没被熊吃掉,这就是 O 铁定通不过图灵测试的时刻。
我们还拿 GPT-2 试了试,看它会怎么回答。答案很搞笑。用词落在对的话题范围内,所以出来的东西挺好玩,我鼓励大家去看论文附录,我们把这些放在那儿了。但它永远不会有帮助,它也并没有在表达任何交流意图。
只靠文本能学会语言吗
主持人: 我得说,不了解背景就读那篇论文,我读得很享受。对我来说尤其享受的是,这个思想实验很具体,既形象,又让人忍不住想:「嗯,我自己怎么看?」
我一直在想的是,我觉得我学过很多自己没亲身经历过的东西,尤其想到学数学,那么多抽象的主题。我感觉我在某种意义上几乎就是通过形式学会数学的,全在脑子里,边学边在脑中想象。从一串词里学会推理那些没见过、没经历过的事情,似乎是可能的。我还记得给盲人学生批改数学作业,很有意思,他们在数学课上推导问题的方式,看起来就像在脑中想象图形,尽管他们天生失明。所以我不太确信,章鱼如果听了全部的语言,就不能以某种方式弄明白弹射器是干什么的。
本德: 如果章鱼真的有机会学英语,那可以。但它没有,因为它从来没有获得最初的那个落脚点(grounding)。我们绝对可以通过语言学到直接经验之外的东西。反过来说,你作为一个视力正常的人,如果想了解盲人的生活是什么样的,你可以听或读盲人对此的讲述,从中学到东西。这我们完全做得到。但我们做得到,是因为我们已经习得了语言系统。我们用语言交流时,绝对会把连自己都没经历过的想法和事情讲给对方听。我们发明东西,再把它传给别人。但我们能这样做,靠的是一个共享的系统,它告诉我们:可能的形式有哪些,哪些是合格的词和句子,这门语言用哪些声音,词怎么构成,句子怎么构成,它们各自对应的固定意义是什么。然后我们用这些固定意义去猜测交流意图。
章鱼的问题不是它不聪明,我们说了它超级聪明。也不是它懂了这门语言之后还理解不了那些东西。而是它接触语言的方式,不足以让它把语言当作一个语言系统学会,它能学到的只有分布模式。
主持人: 那是什么阻止了章鱼像人一样随着时间学会语言呢?
本德: 论文里我们谈到了人类的语言习得。第一语言的习得,关键在于共同注意(joint attention)。婴儿学语言,是从和照料者之间的社会联结开始的,先明白照料者在向自己传达什么,再把词和那些交流意图对应起来。儿童语言研究的文献谈到共同注意的重要性:孩子学会词,是在照料者跟随孩子的注意力、注意同一个东西、然后给出词的时候。这种体验,这种对应,章鱼得不到。它只看到词流过去。
主持人: 您认为有没有可能存在某种算法,能接收一串词,然后在这个意义上理解它们?
本德: 自然语言理解是极其困难的问题,因为它不只依赖语言系统,还依赖世界知识、常识、推理,各种各样的东西。这里我要说得比我实际有把握的更笃定一点:有两种说法差别很大。一种是「我要造一个算法,它理解语言结构,理解语言意义,理解这些意义怎样映射到一个世界模型上,然后用这些来理解」;另一种是「我要造一个只拿到语言形式的系统,并假定它会以某种方式抵达理解」。
所以,是的。如果算法的训练输入里除了形式还有更多东西,你能走得远得多。那可以是视觉落地,可以是向人提问求答的能力,可以是知识库,可以是某种具身形式里的其他传感器。我不是说自然语言理解不可能、不值得研究。我是说语言建模不等于自然语言理解。
主持人: 我确认一下:只消费语言,不加所有这些额外的东西,您的主张是没有任何算法能仅凭这个真正理解语言?
本德: 我说的语言,指的是形式。想象你被扔进泰国版的国会图书馆,周围有你想要的任何一本泰语书,但只有泰语。不知为什么这座图书馆没有泰汉、泰法、泰英词典,就只有泰语。你能学会泰语吗?
主持人: 我觉得能。难的地方在于我已经有一门语言了。但我觉得我……
本德: 那你会怎么做?周围只有堆积如山的泰语书,别的什么都没有,你学泰语的第一步是什么?
主持人: 第一步会做什么?我不确定。您觉得我学不会泰语?
本德: 我是好奇你会怎么做。你作为一个人,能学会泰语吗?当然能,你可以去上泰语课。
主持人: 不不,我是说在这个情境里,就这么被扔进去。人们确实学会过……在没有人还懂的情况下,人们是怎么学会象形文字的?他们必须找到罗塞塔石碑之类的东西吗?还是说……
本德: 罗塞塔石碑正是解开圣书体的钥匙。如果没有这样的东西,你只能诉诸关于分布的假设,问:「关于这些文本所处的世界,我们知道些什么?关于语言一般怎样运作,我们知道些什么?」你可以说:「根据词频分析和词长,这看起来是一门有独立功能词、而不是有大量形态变化的语言。那个东西可能是冠词,那个可能是某个动词的一种形式。」你可以做这类分析。这不是语言模型在做的事。而要从这些结构性的东西走到关于意义的东西,你必须猜测文本在描述什么,你必须引入一些世界知识,问「这个猜测吻合得怎么样」。
我问你会怎么做的时候,心里想的可能答案是:「我会去找一本带图的百科全书。」这就有了视觉落地。或者:「我会去找一本从封面就能看出是《好奇的乔治》泰语译本的书。」
主持人: 这些建议都很好。
本德: 是的。但所有这些都是在引入外部的东西。一旦有了落脚点,你就能在上面往上搭。这是一条有意思的路。但如果你只有形式,形式给不了你这些信息。
语言模型的未来
主持人: 太有意思了,谢谢。这个话题的最后一个问题:您是否预计这些语言模型会撞上我们切实感受到的问题,然后不得不改变路线?还是说,随着我们对自然语言应用的要求越来越高,它们会自行适应,找到办法把外部信息纳进来,就像找到那本《好奇的乔治》译本一样?
本德: 我认为语言模型会继续有用。从上世纪五十年代香农的工作以来,语言模型一直是语言技术的重要组件,这是有长久历史的。但我猜想,预测未来太难了,也许该说我希望看到的是:我们对什么管用、什么样的失效范围是可接受的、需要什么样的保险机制,形成更严格的标准。
人们会发现,如果你的应用真的要求对说出来的每一个字负责,那么把语言模型放在这种应用的中心,是非常脆弱的做法。我猜到了那一步,我们会把语言模型从中心挪开,让它回到从若干候选输出里挑一个、或者提供词向量的位置。它们不是通往通用语言理解的一步,尽管炒作把它们说成是。
这是一类问题。如果你必须对说出的话负责,你就不会想要一只随机鹦鹉。你要的是一个能可靠地替你说话的东西,而不是编出听起来不错的话。另一件事是,如果我们认真对待偏见、训练数据中偏见的编码与放大这些问题,我想我们会发现,我们想要的是能从更小的数据集里榨出更多东西的算法,这样才能更好地策划、记录、更新数据集,让它们跟上世界的变化。而不是现在这条依赖超大语言模型的路。
这些是我的猜测。还有环境的角度。准确说,「能耗」这个角度既关乎环境,在一定程度上也关乎技术。越来越多的人,施瓦茨等人、斯特鲁贝尔等人、亨德森等人,一批工作都在说:「我们做事的时候,也要把环境影响、碳足迹量出来,好把力气用到越来越高效的做法上。」这是一个角度。另一个角度是,很多场景下你手边没有整片云。要在移动设备上做计算,你不可能塞一个庞大无比的语言模型进去。
所以有压力去找更精简的方案。我认为这是双赢:环境上赢,技术的灵活性上也赢。
基准测试的误用
主持人: 完全同意。这也正好引到您几篇关于基准测试的论文里指出的问题,我很想聊聊。也许先从「什么是基准测试」说起,虽然大多数人大概都知道,然后再谈它可能的陷阱。
本德: 好。先说明,这篇论文叫《AI 与「全世界的一切」基准》(AI and the Everything in the Whole Wide World Benchmark),去年在 NeurIPS 的「机器学习回顾」研讨会上发表,是和德布·拉吉、亚历克斯·汉娜、艾米丽·登顿、阿曼达琳·保拉达的合作。又一次合作,这回我们倒是真开会说话了,但这几位里我到现在只当面见过阿曼达琳,她是我们系的博士生。疫情生活嘛。
我们凑到一起,是因为在讨论基准测试是怎样被 AI 炒作机器误用的,怎样被那些追求通用性、把基准能说明的东西说过头的 AI 研究误用的。基准测试,基本上就是一个标准化的数据集,通常带有某种金标准标注。当然也可以给标注是内在的任务做基准,比如语言建模,实际出现的下一个词就是金标准。思路是,你可能有一套标准化的训练数据,也可能没有,然后有一套标准化的测试数据。人们可以拿不同的系统在上面测,从而能说「在这种训练方式下哪个系统更有效」,或者「给定这套训练数据、对那套测试数据,哪个更好」。这就是基准测试。
你之前问我能不能概括基准测试的问题。我有意见的不是基准本身,而是它们被使用的方式。我觉得这是「地图不是疆域」的一个例子。人们会说「这是计算机视觉的基准」,指 ImageNet;或者「这是英语自然语言理解的基准」,指 GLUE 和 SuperGLUE。然后人们会说……我真的在微软的一份公关材料里看到过,说计算机现在比人更懂英语了,因为某个系统在 GLUE 基准上的得分超过了一些人。这纯粹是狂妄的夸大,是对基准用途的误用。
夸大有什么问题?它把科学搞乱了。如果结论和实验对不上,我们做的就不是科学。我们生活在一个 AI 炒作的世界里,这意味着人们更容易买账、更容易部署那些并不像宣传的那样运转的方案,因为他们所处的世界里,有人告诉他们微软造出了一个比人更懂英语的系统。当然你也可以造一个 AI 系统去做别的什么不靠谱的事,比如「从一个人微笑的方式猜他的政治倾向」之类,这毫无道理。但我们所处的世界里充斥着关于 AI 的各种说法、各种夸大,这让那些荒唐的说法听起来也比它们应有的更可信。
这是我看到的问题。但基准测试很重要。计算语言学的历史上有过一段时间,给 ACL(计算语言学协会)写论文,你只要说「这是我的系统,这是我怎么造的,这是几个输入和输出的例子」,完事。后来统计机器学习的浪潮来了,带来了「共享任务评测挑战」的方法论,算是基准测试的历史前身:NIST 和其他机构会说,「我们要做语音识别,想切实了解这些不同系统之间的比较。所以我们办一场共享任务评测,所有人拿同样的训练数据,我们留一份谁也看不到的测试数据。到时候所有参赛者提交系统,看看结果。」
比起之前的做法,这在科学上是进步。但这不是全部。如果你想理解系统是怎么运作的,想知道下一个系统该怎么造,你不能只在某个标准数据上测一下就算了。你还得看:它犯的是哪些类型的错误?不同系统的差别不只在总分上,还在失效模式上,哪些输入对它们管用、哪些不管用,如此等等。而不是「好,我拿了最高分,完事」。
主持人: 说得好,我没什么要补充的。您能不能再多讲讲……我觉得这篇论文很好的一点是,你们给出了非常具体、非常理智的建议,提出了几种基准之外的替代方案。能不能给听众过一遍?
基准之外的方法
本德: 当然。说是「替代」,其实更像是「补充」。基准可以用作一种健全性检查,比如「我的系统真的比一个极其朴素的基线好吗」,或者「我想把几个系统头对头比一比,用这个基准」。除此之外,你还可以用测试套件(test suites),它是专门编排出来的,用来覆盖你希望处理好的特定类型的案例,而不是随手抓一把测试样本里碰巧出现的东西。
你可以做审计(auditing),它和测试套件非常相近。比如乔伊·布奥兰维尼、蒂姆尼特·格布鲁和德布·拉吉对人脸识别数据集的审计,他们系统地构建了一个测试集,覆盖两种性别和一系列肤色,然后问:「在这群人身上,准确率到底是不是均匀的?」他们发现不是。所以这是……
主持人: 这和基准有什么不同?听起来就像一个基准,不是吗?
本德: 区别在于,基准通常不是这样构建的。你可以想象有人构建一个系统地铺开整个空间的基准,但这不是通行做法。通行做法是:「我们从某处抓一批数据,留百分之十做测试,其余百分之九十做训练;或者百分之八十训练、百分之十开发。」基准的一般做法是「抓一个数据样本,看这东西总体上表现如何」;而测试套件和审计是「建立一套测试机制,让我们能摸出它失效模式的轮廓」。不是「它平均表现如何」,而是「它在这种情况、那种情况、另一种情况下各表现如何」。
还有对抗测试(adversarial testing),这个名目下有几种不同的做法。有时人们会把以前的系统表现差的例子全收集起来,做成一个特别难的测试集。这有意思的地方在于它能把那些太容易的白送分过滤掉,但它未必能引导任何东西在某个具体用例上表现得更好。因为它只是「挑出对上一个模型来说难的东西」,而不是「什么是特别重要必须做对的,什么在我们的用例里特别常见」,等等。
这是一种对抗测试。另一种是我们在「造它、破它」(Build It, Break It)共享任务里做的。那是二〇一七年,艾莉森·艾廷格、苏达·拉奥、哈尔·多梅和我一起办的,有造系统的队伍,也有「破坏者」队伍。破坏者的目标是找最小对立对:两个例子差别极小,但系统对一个管用,对另一个不管用。这是一种摸清什么导致系统失效的办法。
你还可以做错误分析。拿基准的测试集或开发集,进去看:「出现的都是哪些类型的问题?」很多依赖语言模型的系统在否定上表现很差。否定对意义至关重要,但往往只是一个很短的词或者子词,所以很容易漏掉。想想语音识别或机器翻译,二十个词里漏掉一个,漏的是哪个词非常要紧。把「a」换成「the」,多数情况下不会出什么问题。但如果漏掉了一个「not」呢?
主持人: 对,有道理。
本德: 所有这些,归根结底是在看:我们要造的是什么,我们在什么上测,它和背后的目标用例怎样吻合,什么管用什么不管用;对不管用的部分,后果是什么,这种失效在现实世界里发生会怎样,可能的原因是什么,是什么把我们绊倒了。这些才是我们希望看到的,而不是「排行榜主义」,所有人挤在一起往榜顶上爬,那感觉不像是真的在做什么。
谈论 AI 进展速度的人,特别爱说排行榜换得多快,各种基准上的最新水平(SOTA)涨得多快。我总是想:「对,然后呢?」从科学上更好地理解世界,或者造出不只平均情况好、最坏情况也好的技术,这些数字究竟意味着什么?
主持人: 有意思。读那篇论文时我想到几件事。我职业生涯刚开始时,大概正赶上 ACL 论文那个时代的尾巴,那时论文好像就是挑几个管用或者不管用的例子,看起来很荒唐。我记得早期有了基准之后,有人的准确率比直接猜最常见的类别还低,你可以争辩说那样也更好,也确实有人这么争辩,但在我看来有点荒唐。我还记得您课上讲的一个轶事,好像是诺姆·乔姆斯基说「妈妈不会教孩子语言」,可实际上她们会,只是没人费心去查。这种事让人抓狂,所以我从那时起就很珍视基准测试。
不过您的建议不但合理,我觉得在公司里很多已经是标准的最佳实践了。你不会不试一试、不摸清楚它哪里行哪里不行就发布一个新模型。你不会说:「我们留了百分之十的数据做测试,发布吧。」这似乎正是一个在公司里比在学术文献里更常见的做法,大概是因为看一个数字然后说「我们打败它了」更容易。但这显然有缺陷。总之我觉得这是篇很好的论文,建议很好,每个人都该照做。
本德法则
主持人: 我也想确保谈到最后一篇论文,这篇很酷,我想让大家知道。什么是「本德法则」(Bender Rule)?它为什么重要?
本德: 本德法则,或者叫「#本德法则」……
主持人: 是带井号的?
本德: 两种都行。
主持人: 先说它是什么,然后我有几个关于最佳实践的问题。
本德: 它本身就是一条最佳实践:你应该始终说明你研究的是哪种语言,哪怕只是英语。这个道理我从二〇〇九年左右就开始扛着到处宣讲,时不时站上去喊一嗓子。那时我看到很多前神经网络时代的统计 NLP 工作,基本上是在说「看,妈妈,不用语言学」,声称因为没有硬编码任何语言学知识,所以系统是「语言无关」的。而这些号称语言无关的系统,绝大多数只在英语上测过。你还会看到很多论文,说是关于机器阅读,或者关于情感分析,实际上呢,是关于英语的机器阅读、英语文本的情感分析。
另一面是,如果有人研究切罗基语、泰语、汉语或者意大利语,那份工作更难被研究会议接收,因为它被认为是「特定语言的」,而研究英语的工作不知怎么就成了「通用的」。这对科学是大问题,对造出真正跨语言可用的技术也是大问题。所以我一直在到处催人:真的去跨语言测试,说出你研究的是哪种语言。二〇一九年,有三四个人,名字都列在我发在 The Gradient 上的那篇文章里,把这种做法称作「本德法则」。名字不是我起的,但既然有了,我就顺水推舟。
一部分原因是,这个问题问出口会让双方都下不来台。如果有人写了篇关于机器阅读的东西,我走过去问「什么语言?」,这是个蠢问题,因为显然是英语。所以这让我难堪。对他们也有点失礼,因为这个问题等于在说「你本该写明的」。我不介意人们把它怪到我头上。我之所以把这个话题标签用起来,一部分正是因为:如果有人想问这个问题,又觉得问出来有点傻,他们可以把它推到我身上,我很乐意把名字借给这件事。
假如 NLP 从泰语起步
主持人: 明白了,很好。这个问题可能不好答,但我脑子里冒出来的是:英语太特殊了,大概有一大堆自己的怪癖。如果 NLP 是从泰语或者切罗基语起步的,您觉得它会有什么不同?英语在很多方面一定是不寻常的,对吧?英语有哪些不寻常的特征,让世界本可以走上另一条路?
本德: 绝对有。那篇文章里我列了一批。第一,英语是口头语言,不是手语。如果 NLP 是从美国手语或别的手语起步的,会非常不一样。
主持人: 显然。
本德: 这是一个大的分岔点。第二,英语有一套非常成熟、高度标准化的书写系统。世界上很多语言根本没有文字,有文字的语言里,很多也达不到英语这种标准化程度。另外,很多语言平均来说比英语有多得多的语码转换。
主持人: 什么是语码转换?
本德: 语码转换(code switching)就是在同一段对话里,有时甚至同一个句子里,使用多种语言。在双语或多语普遍的社区里这很常见。比如你和我,你也会说日本語(Nihongo)对吧?你学漢字(kanji)的时候,最喜欢用什么方式来勉強(benkyou)它们?我不是熟练的语码转换者,所以说得别扭又蠢,但意思是这个。
主持人: 我记得……对,这种情况我确实经历过。
本德: 当然,英语也参与很多语码转换。但同时也有海量的单语英语数据。而当你去看印度各语言的社交媒体数据,其中极大一部分是和英语混着来的。这里就冒出一整套有意思的技术挑战。
我们所处的世界里,最早的数字系统适配的是低位 ASCII,英语恰好全能装进去,最方便。英语的语序相对固定,形态相对简单,任何一个词出现时都只有寥寥几种形式。对比土耳其语,同一个词根据说能有上百万种屈折形式,这就改变了你处理数据稀疏的方式,也改变了数据稀疏本身长什么样。我们的正字法一团糟。前两天有人在推特上问:「为什么我们做字素到音素的预测,却不做音素到字素的预测?」字素到音素,就是「给定一个字母,最可能的发音是什么」,这是文本转语音系统碰到词表外的词时的重要组件。音素到字素则是「给定一个音,最可能的字母是什么」,这不是一个常规任务。我怀疑这在多大程度上是因为英语的书写系统晦涩而混乱。
主持人: 对,听起来是个不可能的任务。
本德: 正是。可如果你看日语,撇开汉字,只用假名转写日语,那直截了当得多。西班牙语的字素音素映射在两个方向上都非常透明、一致。所以细到这种程度,英语书写系统的属性都在起作用。英语喜欢在词之间放空格,句末放标点。这些我们视作理所当然的东西,比如把文本切成句子和词很容易,在别的语言里根本不成立。
所以我说不上来 NLP 会长成什么样,我只能告诉你分岔点可能在哪儿。
主持人: 不,这些很有趣。这些差异太有意思了。
本德: 你可是自愿选修了语言学课的人,我不意外。
主持人: 我就是觉得语言学太酷了。作为一个外行,如果你不懂它,它真的让人大开眼界,因为你就泡在语言里,却从没注意到那些模式。尤其是语音学,大概是最深的,你会惊叫:「天哪,这两个音是不同的?」我永远不会注意到。而且很容易做个思想实验就发现自己错了。我爱这些东西。
我早期的工作大多是用各种方式解析日语。我记得这好像没有妨碍发表,但让人吃惊的是,对这么一个必要的任务,相关工作竟然那么少。我第一份工作主要是处理日语,那时研究文献少得惊人,公司内部的经验反倒比文献多。
本德: 研究界发生的事情是,那类解析问题被认为「解决了」,因为人们在英语上取得了一定进展,而这被误认为是问题在总体上解决了。那么,这里新在哪儿?新在这是日语。可要让人们看到这一点其实很难。我对后来被叫作本德法则的东西,目标就是「把英语放回它该在的位置」:我做了英语的工作,我要说明它是英语的,好给其他语言的工作留出空间,那些工作同样重要、同样新颖、同样有价值。走着看吧。领域里不同的人会定期去数,一届 ACL 会议上有多少论文真的研究了不同语言、真的说明了研究的是哪种语言。变化没有我希望的那么快。但有一些很好的进展。通用依存(Universal Dependencies)项目为很多很多语言做出了树库,激发了大量真正跨语言的工作,很令人振奋。
低资源语言与社区
主持人: 我觉得最引人遐想的一些工作,是跨所有语言构建语言模型,或者构建能以有趣方式利用语言对的翻译模型,让数据多的语言帮数据少的语言。您觉得这是有成果的方向吗?还是说它会以某种方式把我们的偏见编进去?
本德: 这当然有意思。既然我们依赖这些吞数据的庞然大物,而很多语言就是没那么多数据,那么看看从大语言迁移过来能做到什么,是一条有意思也有价值的路。我认为值得问的问题是:「这在多大程度上把英语所编码的世界观强加到了其他语言的结果上?」「由此会导致什么?风险是什么?」再拿它和另一条路比较:「如果只做单语,我们只能走到这一步,所以我们接受那些风险,想办法缓解。」这类工作我认为很重要。
还有一点非常非常重要:你得确认你在低资源语言上用的是真实的数据。之前曝出一件事,我记得是苏格兰语,整个苏格兰语维基百科是一个不会说苏格兰语的人写的。维基百科是 NLP 里非常重要的数据来源,所以任何声称在为苏格兰语做点什么的 NLP 系统,其实都没有。
这方面一个极好的榜样是一个叫马萨卡内(Masakhane)的研究共同体,一个横跨非洲大陆的研究计划,用参与式的研究为非洲语言创建语言资源。他们在怎样把社区建起来上做了很有意思的工作,让人们能以译者的身份来贡献,不是机器翻译专家,而是真正翻译语言的人。去年 EMNLP 的 Findings 里有一篇很酷的论文介绍了马萨卡内项目。
这类工作的要义是:如果你要做低资源语言,一定要和社区建立联系。谁会是这项技术的使用者?然后你才能了解:「大家关心什么?你们希望在多大程度上引入我们从大语言那里能做到的东西?还是宁愿保持单语,看看能走多远?」倾听社区,让社区参与研究。我认为马萨卡内在这方面是很好的榜样。
主持人: 很好。这似乎是个合适的结束点。我们已经大大超时了,您非常慷慨。非常感谢,和您聊得很愉快。
本德: 我也是,谢谢。我可以一直说下去,所以很感谢有这个机会。
一句话概括
语言学家 Emily Bender 借《随机鹦鹉》一文的 Google 风波切入,论证语言模型只见"形式"不见"意义"、基准测试被滥用为"通用理解"的证据,并呼吁研究者明确所研究的语言(#BenderRule),而非把英语默认为"通用"。
核心要点
- 《随机鹦鹉》是一篇综述而非实验论文,却引发 Google 解雇两位伦理 AI 负责人。 起因是 Timnit Gebru 在 Twitter 私信 Bender 询问大模型风险,Bender 列出五六条担忧后成了论文提纲;七位作者一个月内在 Overleaf 远程合作完成,投稿 FAccT 2021。论文通过了 Google 内部发表审批,但 11 月底 Google 要求撤稿或署名撤回且不说明原因。Gebru 被解雇,Margaret Mitchell 数月后也被解雇,因此第四作者署名为 "Shmargaret Shmitchell"。仅 Bender 网站上的 bitly 链接就被下载超一万次。
- Google 公开的反对理由站不住脚。 Google 称论文"未引用缓解这些问题的相关工作",但从未指明该引用哪些,而论文实际引用了此类工作。作者们原本预期被冒犯的会是 OpenAI(GPT-3 是文中的贯穿案例),没料到是 Google 内部。
- "伦理"讨论应针对制度与激励,而非给个人贴标签。 多数从业者受股东价值最大化等系统性约束,难以对正在赚钱的东西踩刹车。Bender 希望 NLP 借鉴其他工程领域上线前的容差测试与认证,而非 AI 炒作文化;Model Cards 是朝这个方向的尝试。"越大越好"的路径还会排除数据量不足的语言社区和小型研究团队。
- 偏见不只来自数据,模型本身也在放大。 三个实证案例:Safiya Noble 记录搜索"black girls"早期返回色情内容,根源是广告经济允许购买身份词;Latanya Sweeney 2013 年发现非裔风格姓名的搜索广告暗示犯罪记录;Robyn Speer 发现用通用词向量做 Yelp 评论打星预测时,系统性低估墨西哥餐厅评分,因为网络上的移民话语让 "Mexican" 与负面情感词共现。Yelp 数据本身并无此偏差,偏差是模型组件带入的。
- 去偏无法彻底,但可以做得更好。 完全无偏的数据集不存在。可行路径:使用精心策划的数据、针对已知偏见的去偏技术(前提是你得知道要找什么)、按具体用例梳理利益相关者和失败模式,再决定测什么。
- 只学"形式"的语言模型无法获得"意义"。 语言模型的训练任务是预测文本中的词,看到的只是字符序列。母语者无法"关掉"意义,因此看英语文本不是好的类比;看切罗基语音节文字才更接近模型的处境。词向量捕捉的是分布模式,是有用的工程组件,但不等于理解。
- 图灵测试失效的原因是人类太善于"补全意义"。 人会主动为语句构建使其合理的语境,所以人不适合当图灵测试的裁判。章鱼思想实验的关键:假设章鱼超级聪明、时间和记忆无限,它监听两位漂流者的莫尔斯电报后能完美模仿"下一句最可能是什么",但当 A 问"椰子投石机造出来怎么样了"或"熊在攻击我,只有两根木棍怎么办"时,章鱼无能为力,因为它从未有过椰子、绳子或熊的接地经验。GPT-2 对熊的问题给出的回答话题相关却毫无帮助。
- 人类能通过语言学习未经历之事,前提是已掌握语言系统。 儿童习得语言依赖与照料者的"联合注意",把词映射到交际意图上;章鱼和语言模型没有这一步。被扔进只有泰语书的图书馆,突破口只能是带图的百科或《好奇的乔治》泰译本这类外部锚点。Bender 并非否认自然语言理解可行,而是主张需要视觉接地、知识库、传感器等形式之外的输入。
- 基准测试的问题在于滥用,不在于基准本身。 "地图不是领土":微软曾宣传其系统在 GLUE 上超过人类就等于"比人更懂英语",属于严重过度宣称,且让"从微笑猜政治倾向"这类荒谬产品显得可信。补充手段包括:测试套件、系统性审计(如 Buolamwini/Gebru/Raji 按性别与肤色网格审计人脸识别)、对抗测试(2017 年 Build It Break It 任务用最小对找出系统失效点)、错误分析。依赖语言模型的系统普遍处理不好否定词,漏掉一个 "not" 的后果远比漏掉冠词严重。
- #BenderRule:永远写明你研究的语言,哪怕是英语。 自 2009 年起她观察到"语言无关"系统几乎只在英语上测试,而做泰语、切罗基语的工作被视为"语言特定"难以发表。英语的特殊性包括:是口语而非手语、有高度标准化的书写系统、代码转换少、词序固定、形态简单(对比土耳其语一个词根有数百万屈折形式)、用空格分词、正字法混乱到"音素到字素"预测不成为任务。
结论与值得注意的细节
- Bender 预测语言模型会继续作为语音识别、机器翻译等任务的组件存在,但当应用需要对输出的文字负责时,随机鹦鹉会被"去中心化",退回到候选排序或提供词向量的角色。
- 她主张转向能从更小、可策划、可更新的数据集中学习的算法,理由同时包括偏见治理、碳足迹和移动端算力约束,认为这是环境与技术的双赢。
- 低资源语言的数据真实性需要核查:苏格兰语维基百科几乎全由一个不会苏格兰语的人写成,任何声称支持苏格兰语的 NLP 系统实际上并不支持。
- Masakhane 是她推荐的范本:横跨非洲大陆的参与式研究集体,让社区成员作为译者贡献语料,并由社区决定是否借用高资源语言的迁移。
- Universal Dependencies 项目为众多语言产出树库,推动了跨语言研究,但 ACL 论文中标明所用语言的比例改善得比她期望的慢。
- 主持人 Lukas 提到自己早期做日语分析工作时发现文献极少,Bender 的解释是:英语上取得进展后,问题就被误认为"已解决",做日语被视作"没有新意"。

追问一个大问题。 苏菲拉底的每周来信,写这一周在追问的问题和看到的回应。
 微信公众号